
RoCE 用 PFC 接住在途資料,用 ECN 降低持續進入的流量
重點
- RoCE 網路工程師
- RoCE 網路工程師要同時配置端到端減速的時間餘裕與逐跳暫停的在途緩衝,因為 sender 收到回饋之前仍會送資料;把 ingress priority group 與 egress queue 的計帳分清,才能避免門檻看似合理卻提早暫停。
- DCQCN
- DCQCN 讓 receiver 以 CNP 通知 sender 降速,改善持續壅塞中的服務分配;標記、回傳與 RNIC 反應都有延遲,因此突發流量仍需緩衝承接,較早出現 ECN 標記也只保證較早提醒。
- AI 叢集營運團隊
- AI 叢集營運團隊應連同無壅塞對照流量量測 pause duration、完成時間與吞吐,因為同一鏈路優先級的暫停會讓不同目的地一起等待;只看零丟包,容易漏掉同步工作被最慢傳輸拖住的代價。
- RNIC 設計團隊
- RNIC 設計團隊可用選擇性重傳與在途上限減少對 PFC 的依賴,代價是維護接收狀態、丟包追蹤與完成語意;能處理失序及遺失的 transport,才有條件承擔 watchdog 打斷暫停後的封包損失。
一個 RoCE fabric 可以同時做到沒有壅塞丟包、鏈路持續忙碌,卻讓不相關的小型請求等很久。PFC 保護的是相鄰設備間、指定優先級的接收空間;ECN 則把壅塞訊號送到端點,讓來源減少後續流量。兩者作用的距離與時間不同,部署時必須分別準備緩衝,並檢查它們如何影響完成時間。
先把工作具體化。四台伺服器各有一個大型 RDMA WRITE,要把結果送進同一台接收者;每條輸入及接收者的出口都以 400 Gb/s 作為理想資料率。這可以代表參數或快取資料的一次匯聚,也能作為 collective 某個匯聚階段的簡化模型。四條輸入同時開始,合計 1.6 Tb/s 爭用 400 Gb/s 出口。即使交換器內部轉送能力足夠,目的地前的出口仍要排隊。
下面先沿藍色資料路徑讀:四個 ingress priority group 的資料,匯入一個 egress queue,再抵達 receiver。橘色 PFC 往相鄰發送者返回;紫色 CNP 則由 receiver 發回原始 sender。這些控制路徑各有一段尚未生效的時間,buffer 就用來承接那段時間產生的資料。
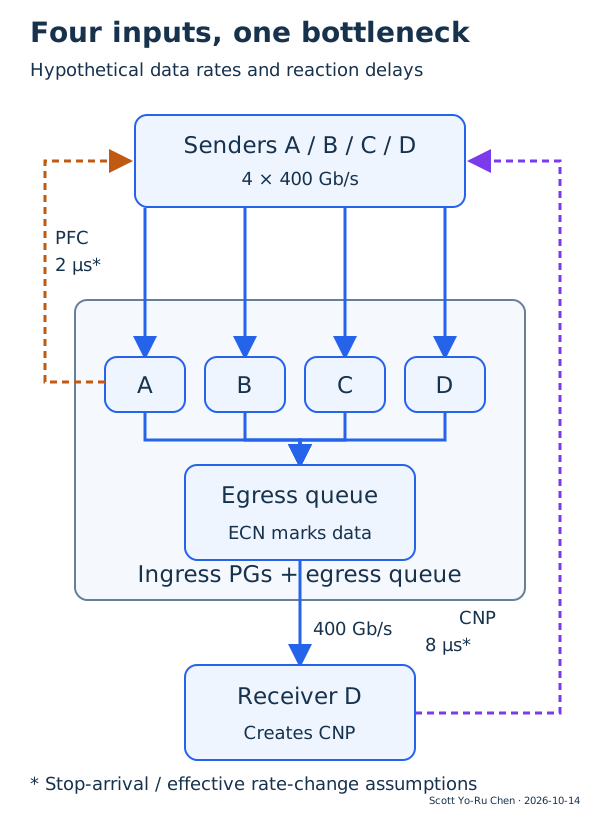
圖一:參考設計,省略中間 hop;400 Gb/s、8 μs 與 2 μs 都是後文的假設值。協定分工依據 IEEE 802.1Qbb、NVIDIA RoCE 文件。
這篇接續 CSIG 的路徑壅塞訊號 與 STORM 的 RNIC 排程。訊號回答 sender 如何得知網路狀態,排程決定誰先送;本篇補上的是它們生效前的資料量,以及逐跳暫停造成的共同等待。先理解這一層,才能判斷更快的訊號或更聰明的順序,實際省掉了哪段等待。
接收空間與來源速率由兩條迴路控制
IEEE 802.1Qbb 的公開說明 將 PFC 定義為全雙工鏈路上的 per-priority flow control。下游發出 pause,要求相鄰上游停止某個優先級的傳送,其他優先級仍可取得服務。它提供的操作是「現在先停」,粒度由鏈路與優先級決定。
ECN 使用 IP header 的 Congestion Experienced 標記表示壅塞,RFC 3168 §5 說明其 IP 層訊號。RoCEv2 receiver 收到標記後,可產生 CNP,由來源 RNIC 的控制器調整傳送速率。TCP 的 ACK 回饋與 RoCE 的 CNP 是不同 transport 路徑,共用 ECN 欄位並不要求相同的速率演算法。NVIDIA RoCE 的 lossy 模式說明 可作介面參照。
這裡的時間起點要一致。對 ECN,把 Tcc 定義為「一包在壅塞出口被標記,到降低後的流量真正抵達該出口」;它包含標記包的等待與正向傳送、receiver 產生 CNP、回程、RNIC 反應,以及降速資料再走到瓶頸的時間。拿空載 ping RTT 填入 Tcc,會漏掉其中幾項。
對 PFC,把 Tp 定義為「下游決定發出 XOFF,到上游最後一批仍被允許送出的資料抵達下游」;它包含控制框的序列化、傳播、上游處理與資料回程。這個定義已涵蓋來回影響,因此另加 cable RTT 時要避免重複。兩個時間都應以資料面觀察核對。
2015 年 Yibo Zhu 等人的 DCQCN,SIGCOMM 把交換器標記、receiver 通知與 sender 降速串成端到端控制。原始實作對每條 flow 抑制過密的 CNP,使用 50 μs 的通知間隔;第一個符合條件的標記包可立即觸發,後續通知才受間隔限制。這是當年實作參數,後文的 8 μs 只是理想化算例。
PFC 的逐跳阻擋與 DCQCN 的來源降速可以互補:前者處理來不及停住的資料,後者降低持續輸入的壓力。當暫停一路向上游擴散,ECN 回饋與 host pacing 能否及時降低輸入,便會影響有多少鏈路、多少工作被牽連。
400 Gb/s 下的一微秒,足以增加五萬 bytes
先只看一個出口,以十進位 bytes 計算,忽略 Ethernet、IP、UDP 與 RDMA header。400 Gb/s ÷ 8 = 50 GB/s,也就是每微秒 50,000 bytes。四條輸入合計每微秒 200,000 bytes,出口每微秒移走 50,000 bytes,淨增加 150,000 bytes。
令 A(t) 為進入這個 queue 的總速率,C(t) 為實際服務速率。只要 queue 非空,簡化流體關係是:
dq/dt = A(t) − C(t)
q(t) ≥ 0
當 queue 已空、服務能力大於輸入,q 維持零;多出的出口能力成為 idle capacity。這個守恆式可以先排除不合理設定:緩衝大小、控制速度及工作同步程度,要容納同一筆淨累積資料量。
若標記時刻 t0 的 queue 為 Kecn,控制生效前還會增加:
ΔQcc = ∫[t0, t0+Tcc] max(A(t) − C(t), 0) dt
這裡取正部是保守估計,沒有用中間的排空時段抵銷突發。若 A 與 C 固定且 A>C,才簡化成 (A−C)Tcc。要避免抵達某個同一計帳域的壓力線 Qg,至少須滿足 Kecn+ΔQcc<Qg。這只是首次反應前的必要餘裕;反應後若仍超額,queue 還會繼續增加。
對四對一、Tcc=8 μs 的假設,ΔQcc=1,200,000 bytes,也就是 1.2 MB。若 Kecn=256,000 bytes,第一次降速資料抵達之前,queue 可達 1.456 MB。ECN 已經標記並不會讓這些資料消失;它們已被來源送入網路。
較低的 Kecn 能早一點開始通知,但最激進的 Kecn=0,在這個模型仍留下 1.2 MB 的淨累積。若可用空間遠低於這個量級,就需要減少初始發送、縮短實際 Tcc、分散匯聚或啟動逐跳暫停。單改標記門檻有可推導的極限。
一次完整突發,把標記、暫停與首次降速排在時間線上
現在給簡化模型一組完整參數。四條 flow 在 t=0 同時以每條 50 GB/s 進入空 queue;出口維持 50 GB/s。到首次反應前,各 flow 都保持原速率。
| 參數 | 假設值 | 用途 |
|---|---|---|
| 每條 flow 的資料率 | 50 GB/s | 四條共 200 GB/s |
| 出口服務率 | 50 GB/s | 接收者前的瓶頸 |
| Kecn | 256 kB | 首次標記的確定性門檻 |
| Qg | 768 kB | 抽象的暫停觸發壓力線 |
| Tcc | 8 μs | 標記到首次有效降速資料抵達 |
| Tp | 2 μs | 暫停決定到最後舊資料抵達 |
| 最大框與額外安全量 | 每入口 9 kB | 供獨立 headroom 試算 |
所有 KB/MB 的算例數字皆採十進位 kB/MB。Qg 是單一計帳域的教學假設;下一節會把真正 ingress PG 與 egress queue 分開,它不是一套可直接填入交換器的設定。
queue 以每微秒 150 kB 增加,因此在 256/150=1.707 μs 跨過 Kecn。只靠這一次理想化 ECN 反應,降低後的流量要到 9.707 μs 才抵達。Qg 卻在 768/150=5.120 μs 已被跨過:即使標記先發生,仍要暫停。
若抽象控制器在 5.120 μs 對四條來源同時發出 pause,且每條都在 2 μs 後完全停住,峰值出現在 7.120 μs,為 1.068 MB;之後出口持續排空。這個首次暫停把峰值壓低,但付出所有四條 flow 一起停止的代價。此處只追到首次停住與排空,沒有模擬後續 XON、再突發或 DCQCN 的逐次收斂。
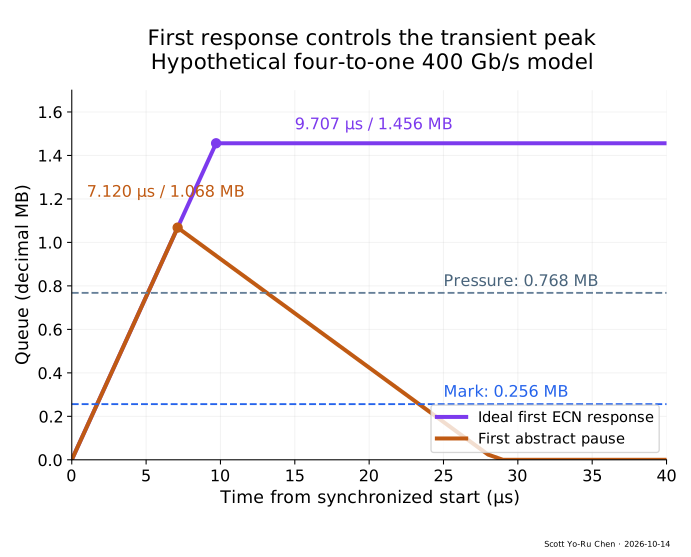
圖二:假設算例,以 可重跑腳本 產生的分段線性函數繪製。紫線在首次 ECN 生效後假設總速率立即等於出口能力,是有利於 ECN 的理想化控制;橘線在首次 pause 生效後停止所有輸入。兩條曲線均非實體 RNIC benchmark。
公平性也要另外檢查。四條等速 flow 的理想持續分配是每條 12.5 GB/s,即 100 Gb/s;然而「總輸入剛好等於出口」只約束總量。四條速率為 35、5、5、5 GB/s,也同樣不會新增 queue,卻有不同完成時間。用 Jain index,前者為 1,後者為 0.481。queue 穩定、鏈路利用率高與 per-flow 公平,是三項分開的要求。
再假設每條只需要送 16 MB,接收者總共要接 64 MB;在理想 50 GB/s 出口上,完成全批資料至少需 1.28 ms。這個容量下界保留了大家最終都得通過同一出口的事實。減少 pause 可以改善期間的 idle gap 與尾端等待,無法把出口的容量下界一併消掉。
ECN 與 PFC 門檻,往往量的是不同集合
真正的交換器會讓同一份 packet 同時被不同視角計帳。對以 ingress priority group 觸發 PFC、以 egress queue 做 ECN 的實作,可以定義 xij 為「從入口 i 收到、仍等著出口 j 服務」的 bytes:
入口 PG i 的占用  Ii = Σj xij
出口 queue j 的占用  Qj = Σi xij
一個入口可把資料送往多個出口;一個出口也可接收多個入口。因此 Ii 與 Qj 是矩陣的列總和、欄總和。它們可能來自同一份共享記憶體,並不意味著額外儲存兩份 packet。原始 DCQCN §4 已明確分開這兩種計帳;現代 ASIC 的 pool、PG 與 queue mapping 還須逐平台核對。
這使「ECN 門檻數字小於 PFC 門檻」失去單獨保證。構造一個反例:某入口向四個出口各積累 48 kB;每個出口目前都只有這個入口的資料。若各出口 Kecn=80 kB、入口 XOFF=128 kB,數字上 80<128,但入口已占 192 kB,四個出口卻都還低於 80 kB。PFC 可以先發生。
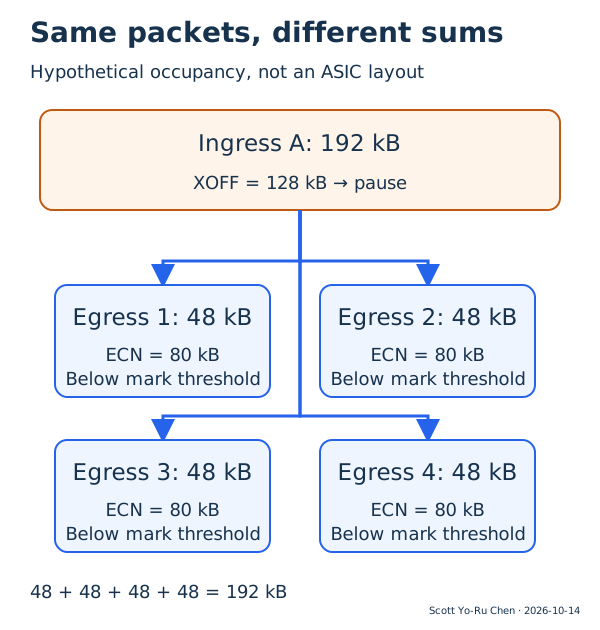
圖三:假設算例,展示同一份資料的兩種計帳視角。每個出口只有單一入口貢獻;源自 DCQCN 的 ingress/egress 區分,非任一商用 ASIC 的 buffer 佈局圖。
反過來,多個入口各自只積一小部分,合計卻能讓單一出口先標記。部署時要核對的是可達的流量分布、入口與出口服務關係,以及共享 pool 隨其他 port 忙碌而改變的可用額度。把兩個 CLI 數字排大小,漏掉了這張計帳矩陣。
動態共享可以讓空閒 port 的空間支援忙碌 port,但分配會隨並行負載改變。一個 flow 在獨占 fabric 時通過測試,加入第二個 job 後可能更早暫停。要把這種變動放進模型,Qg 應改成與 pool 可用量及活動 PG 數相關的壓力線;單一常數只能代表已固定的情境。
PFC headroom 必須接住已經出發的資料
到達 XOFF 時還有資料在路上。對某入口 i,一個保守的原始 bytes 預算可以寫成:
Hi ≥ Ci × Tpi + Mi
Ci 是入口可能抵達的速率;Tpi 必須涵蓋最後舊資料抵達;Mi 是未被時間模型涵蓋的最大框、門檻 overshoot 與安全量。若實際量測的 Tpi 已包含整框尾端,就應從 Mi 移除重複部分。這裡刻意假設該入口的 buffered bytes 在這段時間完全無法排出,得到保守需求。
400 Gb/s 的入口、2 μs 延遲與9 kB額外量,得到每入口 109 kB。四個入口同時需要 headroom,保守合計為436 kB。前一節的 queue 在 pause 決定後只增加300 kB,因為出口在2 μs內仍移走100 kB;headroom 的436 kB則保守地計入400 kB總到達與36 kB額外量。兩者回答不同問題,應保持同一組假設再比較。
共享 headroom 的配置可以小於所有 port 的最壞需求總和,代價是承擔同時暫停的重疊風險。假設四個入口各有32 kB專用空間,剩餘從200 kB共享池借用,每個仍需77 kB;四者共同要求308 kB,超過共享池108 kB。平均負載很低也無法消除這個同步峰值。
NVIDIA Cumulus 5.17 的 QoS 文件 分開 required、exclusive 與 shared headroom;其 PFC 計算也包含介面延遲與線長。實際硬體以 cell 配置,packet 大小還會改變內部占用。上述 bytes 算式適合先查量級,正式 sizing 要加入 cell rounding、metadata、各 port 的實際延遲與可保證的共享額度。
把鏈路換成800 Gb/s而維持2 μs及9 kB額外量,原始需求變成每入口209 kB。速率升高使同一段控制延遲承載更多在途資料;若靠改善反應路徑把延遲縮到1 μs,才可在這個模型回到109 kB。這指出改善控制延遲與增加SRAM是在支付同一筆資料量,但成本位置不同。
同優先級的其他目的地,也可能一起停住
考慮一條上游鏈路同時送 A→D 的大型傳輸與 A→E 的64 kB小型請求;D 的出口壅塞,E 的出口空閒,兩筆流量卻被映到同一個 PFC priority。下游要求上游暫停這個priority時,上游停的是整個類別,送往E的資料也要等。
這不是只有單一 FIFO 的隊頭擋住後方packet。即使來源已按目的地分開排程,只要 pause 的作用域仍是鏈路上的同一priority,當下都可能失去傳送資格。若上游的同priority buffer接著累積,它再向自己的鄰居發出新PFC,等待範圍便往外擴張。每一跳產生自己的控制框,原來的PFC框在鄰接鏈路終止。Juniper 2025 年工程說明 描述了這種逐跳壓力傳遞。
64 kB在400 Gb/s理想出口的序列化時間只有1.28 μs。若同優先級pause讓它等20 μs,其額外等待已遠大於自身傳送時間。換算成「等待加單鏈路序列化」是21.28 μs;這仍只是一段路徑的假設算例,完整FCT還要加入其他hop與端點處理。
增加priority能把部分工作分開,卻會增加buffer預留、mapping與排程配置。多租戶環境也要決定誰可以把流量放進受保護類別,以及CNP本身是否能及時送出。對照 STORM,更好的請求順序有助縮短等待,但整個類別被pause時,順序再精細也要先等鏈路重新提供服務。
長期吞吐要連到每條 flow 的完成時間
2015年的DCQCN原始測試,Figure 2與§6,使用40 Gb/s、三層Clos與ConnectX-3 Pro;以背景工作混合incast,比較啟用與未啟用端到端控制,觀察吞吐及公平性。它提供的是指定hardware與traffic下的控制效果,研究理由則延續到高速fabric:來源減速可以減少持續pause及旁觀flow被拖住的情況。
本篇的流體算例只證明首次反應的資料預算。若要評估今日部署,合理的三組對照是:同一可靠transport只用PFC;同一transport加入已校準ECN/速率控制;再加入sender pacing或錯開啟動。前三者保持NIC、路由、port rate、MTU、buffer pool與接收者相同,才可把差異追到控制。
負載要同時含長期飽和與有限突發。四條持續flow測每條throughput與Jain index;四條固定bytes的匯聚測整批makespan及個別FCT;另外穿插一條送往空閒目的地的短flow,觀察P99與pause duration。同步與隨機錯開的開始時間應分開做,因為平均offered load相同,queue峰值可以很不同。
還要同步記錄CE標記、CNP、入口PG占用、出口queue占用、pool餘裕與NIC速率。低pause但高drop可能是headroom不足;高CE但持續高queue可能是回饋慢或減速不足;低CE卻大量PFC可能是mapping或不同計帳域先撞門檻。這些是假說判別方式,須以同一次傳輸的時間線核對。
當訓練或服務有同步點,應把communication FCT接回iteration或request latency。短flow變快可能只是背景flow被延後;一條receiver鏈路一直100%忙碌,也可能代表工作在網路持續排隊。改善的目標是相同工作量與隔離條件下更早交付,而非單獨最大化某個counter。
持續暫停需要切斷等待,並處理遺失資料
短期壅塞通常會隨出口排空而解開。死鎖則出現一個相依環:buffer A裡的packet等B釋放空間,B等C,C又等A。若大家持續保留資料、又持續暫停對方,停止新流量仍可能留下互相等候的packet。
Chuanxiong Guo(Microsoft)等人的SIGCOMM 2016實務論文,§4.2 報告Clos部署中,未知目的MAC的flooding打破預期up/down路由,形成PFC循環等待。這個前例說明,預設路由圖之外的例外轉送也須納入相依分析;只檢查正常unicast路徑會漏掉故障時的實際路徑。
另一類問題是receiver的接收管線停住,反覆發pause。它未必形成路由循環,仍可能把上游都拖住。偵測時要區分持續XOFF、幾乎沒有queue服務、buffer滯留與相鄰設備故障;僅憑pause框數量,難以辨認短而頻繁的正常突發與長時間不前進。
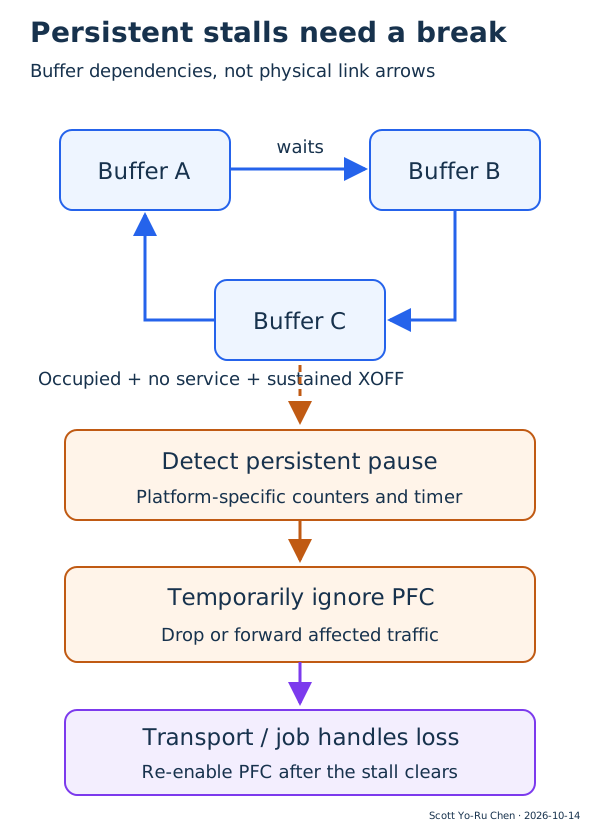
圖四:參考設計。相依環是示意;watchdog的偵測、drop/forward與回復配置概念依據 SONiC PFC Watchdog Design。圖中條件須依ASIC實際counter與平台行為實作。
SONiC的watchdog設計文件,§1.2 提供兩種處置:drop丟棄受影響queue的資料,或forward暫時忽略pause繼續服務;持續暫停消失後再回復PFC。其文件與目前CLI原始碼 的時間尺度是毫秒,CLI預設detection time為200。這是故障隔離尺度,與前面的微秒級突發緩衝分開使用。
打斷等待可能帶來packet loss。參考設計中,網路先限制影響範圍、保留port/priority及drop紀錄,端點接著檢查operation完成狀態、重傳是否前進,以及QP是否回報失敗。若operation已失敗,應交給上層依工作語意中止或重建;部分資料可能已寫入接收buffer,僅憑鏈路重新傳得動就交付結果,會漏掉未完成工作。
重新放行也要觀察同一故障是否再度出現。receiver仍失效時立刻重啟原工作,會再次注入壓力。對不可接受半完成結果的collective,一個可操作策略是停住相關operation、保留失敗紀錄,確認端點正常後從安全輸入重做該階段;這是上層參考處置,具體成本由collective與應用的錯誤語意決定。
選擇性重傳提供另一種付成本的位置
PFC降低壅塞丟包,但讓不同flow共享暫停範圍。Radhika Mittal(UC Berkeley)等人的IRN,SIGCOMM 2018 改良接收失序與選擇性重傳,再用BDP-FC限制單flow的在途packet。它把較多責任移到NIC,減少大量重送已成功抵達資料的浪費。
其預設網路評估是54台server、40 Gb/s的三層fat-tree模擬;NIC邏輯另有硬體資源與RTL驗證。對照包含RoCE加PFC,以及IRN加或不加PFC,並分開測不同壅塞控制器。原文§4與§6 提供條件。這種結果支持loss-tolerant transport的研究方向,仍需在目標NIC、速率及工作上重新比較。
| 方案 | 流量超出容量時怎麼付成本 | 主要新增負擔 | 適合先驗證的情境 |
|---|---|---|---|
| PFC為主 | 暫停相鄰設備的同priority資料 | headroom與共同等待 | 既有loss-sensitive NIC、突發有限 |
| PFC加ECN/來源pacing | 逐跳承接首次突發,來源減少持續輸入 | 回饋延遲與速率參數校準 | 持續壅塞混合短工作、既有fabric |
| 選擇性重傳加在途上限 | 接受遺失,端點補傳缺少的資料 | NIC狀態、完成語意與重傳成本 | 可完整驗證loss及reordering的transport |
這是工程比較,前三欄並未替任何NIC宣告功能。NVIDIA Cumulus文件同時提供lossless及lossy RoCE配置,顯示switch可以採不同模式;端點是否能承擔損失,仍須以實際NIC功能及失敗注入測試確認。單把PFC關掉,保留其餘設計不動,無法取得IRN整套修改的效果。
接收端授予credit或工作排程錯開傳輸,也是可比較的選項。credit可以在資料進入fabric之前限制receiver負載,但引入請求、授權與credit不足時的等待;錯開啟動可降低同步峰值,卻把等待放到sender或runtime。用同一批64 MB及相同出口容量比較,才能看出等待移到哪裡、總完成時間是否下降。
高速鏈路要求量測控制延遲的尾端
未來一年,若某個fabric把400 Gb/s升到800 Gb/s,且實際Tp與同時暫停數保持不變,這個模型預期原始在途bytes項加倍;若增加的headroom遠小於推導值,必須由更短的實測反應時間、較低輸入或可保證的排空解釋。這是一項條件式工程預判,可以用pause注入與逐port最大占用直接檢查。
ECN也有相同量級壓力。應量的是「標記到新速率抵達瓶頸」的分布,包含CNP排程與receiver處理;尾端Tcc拉長時,更多bytes會在回饋生效前到達。較豐富的路徑訊號可以減少控制器猜測,較早的接收credit可以限制起始burst,但緩衝與端點控制仍須對同一條資料時間線負責。
RoCE調校最後可以收斂到三個可檢查的量:首次回饋前的淨累積、XOFF後的在途資料,以及暫停牽連的其他工作量。前兩項決定緩衝是否自洽,第三項決定零丟包換來多少服務延遲。把這三項接到具體工作與完成時間,就能選擇增加buffer、縮短控制路徑、改善端點重傳或調整傳輸時機各自應付的成本。
證據範圍
- 四對一400 Gb/s、8 μs/2 μs、256 kB/768 kB與9 kB安全量均為假設算例,未量測商用交換器或RNIC。腳本只計算守恆式、首次反應、headroom、Jain index及容量下界,沒有實作DCQCN、packet simulator或穩態PFC迴圈。
- 模型忽略wire overhead、cell占用與離散packet;假設ECN首次反應後四條flow立即取得公平速率。Qg是抽象暫停壓力線,不是實際ingress XOFF。XON、接收credit、後續rate increase與多瓶頸均須額外建模。
- DCQCN採SIGCOMM 2015原文;IRN採2018年6月21日的arXiv extended version及其SIGCOMM工作。歷史40 Gb/s結果不外推為400/800 Gb/s增益。Microsoft 2016案例只支持其報告的故障機制,不推定今日所有NIC仍有相同問題。
- Cumulus配置說明以5.17版為定點參照;頁面已有5.18版連結,本篇未宣稱5.17為最新版。不同ASIC的pool、cell及門檻生效值要分開查;公開指令沒有在真實設備執行。
- SONiC設計頁為歷史規格;CLI原始碼固定於cc4fbb3e831358e5b3844490753d239797cf1611。不同ASIC對偵測、drop/forward及PFC恢復的支援可能不同,本文未宣稱整條故障處置已完成production驗證。
- 本篇僅使用公開協定、研究與工程文件。端點operation失敗與重做階段的處理屬參考設計,應依實際completion及應用語意決定。
參考資料
- IEEE 802.1Qbb — Priority-based Flow Control — 2011年6月16日核准的標準項目說明。
- RFC 3168 — The Addition of Explicit Congestion Notification to IP — 2001年9月。
- Yibo Zhu et al. — Congestion Control for Large-Scale RDMA Deployments — SIGCOMM 2015,§3–6。
- Chuanxiong Guo et al. — RDMA over Commodity Ethernet at Scale — Microsoft,SIGCOMM 2016,§4。
- Radhika Mittal et al. — Revisiting Network Support for RDMA — arXiv v1,2018年6月21日;SIGCOMM 2018工作延伸版。
- NVIDIA Cumulus Linux 5.17 — Quality of Service — PFC、ECN與shared headroom。
- NVIDIA Cumulus Linux 5.17 — RoCE — lossless/lossy與CNP。
- Juniper — Lossless Ethernet Fabrics with PFC for AI/ML Workloads — 2025年11月17日工程說明。
- SONiC — PFC Watchdog Design — 偵測、處置與回復設計。
- SONiC CLI — pfcwd/main.py — 固定版本原始碼。
- RoCE feedback budget 試算 — 本篇假設模型;執行結果。