
商品目錄快取擴容,要一起搬動版本與回源預算
重點
- 商品目錄 API
- 商品目錄 API 允許展示資料短暫落後,換取大量讀取由記憶體承擔,但每層快取都要沿用來源讀取時的截止時間,否則一次延遲回填或節點搬移,就會把原本三十秒的陳舊承諾重新延長。
- 快取服務維運團隊
- 快取服務維運團隊以穩定邏輯分區降低擴容時的搬動量,仍需分批預熱、限制回源及作廢舊回填權;一致性雜湊只改善資料位置變動,單一熱門 key 與新節點的冷資料仍會消耗來源容量。
- 目錄後端工程師
- 目錄後端工程師把資料版本、owner incarnation 與單次回填 token 分開管理,能拒絕失效後晚到的舊結果,也能在快取重啟後重新建立資料;代價是多一條版本通知與有界等待路徑,嚴格讀取仍需回到權威來源。
一家提供多租戶商店的電商平台,讓商家修改商品名稱、圖片與展示文案,消費者則在活動期間大量開啟商品頁。商品資料原本由目錄 API 直接查資料庫,平常運作正常;活動連結被分享後,重複讀取開始拖慢商家的更新與管理頁。
消費者希望快速看到商品,商家則希望更新能在合理時間內出現。平台還會增加 API 與快取節點:若每次擴容都讓大量讀取重新打進資料庫,增加容量反而會造成停頓。接下來要設計的快取服務,必須同時回答資料能落後多久、誰有權回填,以及資料搬家時來源能承受多少工作。
先看原有路徑:大量訪客與少量商家操作共用目錄來源。圖中保留這個最小系統,先把新鮮度與來源負載要求說清楚,再加入快取與分區。這是一個公開技術機制支持的參考設計,所有業務流量均為假設。
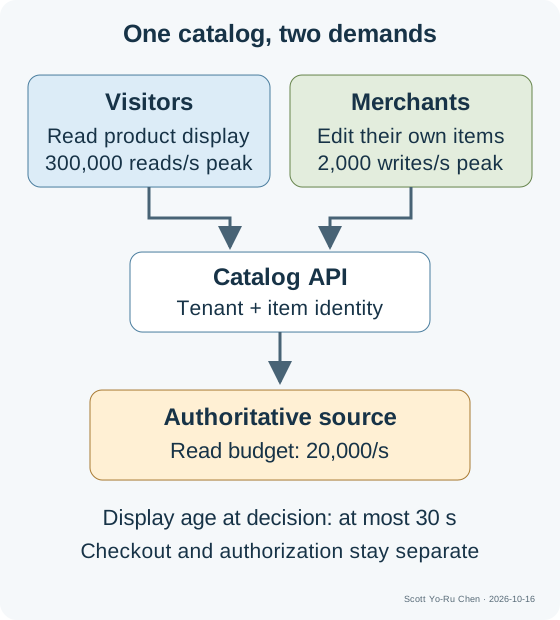
展示內容可以落後三十秒,成交與授權另走權威路徑
功能先限於按商品 ID 讀取名稱、圖片、展示文案,以及商家更新這些欄位。搜尋、推薦、精確點擊計數不在本次範圍;庫存預留、結帳價格與存取權判定也不交給這份展示快取。商品頁上的展示資料可能短暫落後,提交訂單時則重新確認成交資訊。
本案例採單區域,假設讀取尖峰 300,000 次/秒、更新尖峰 2,000 次/秒,熱工作集 2,000 萬筆。目錄讀取入口至送出回應的 P99 目標為 50 ms、有效請求成功率 99.99%;合法但不存在的商品回 404 算正常結果,來源過載回 503 算服務失敗。更新成功的資料必須在約定的單節點故障接手後保留,快取全失則允許暫時降低讀取可用性。
展示資料的硬限制是:在 API 做出回應判定時,採用的來源觀測距今最多三十秒。每次來源讀取必須是能看到當時已提交資料的短查詢,避開落後副本與長時間舊 snapshot。管理者更新後取得版本,例如 42;管理頁可帶 min_version=42 要求讀到至少該版本,必要時直接回源。一般訪客讀取接受三十秒內的舊版本,兩條路徑分別計量。
需要維持的規則很具體:租戶 A 的資料永遠不會因 key 相同而回給 B;同一 owner 已知的商品版本下限不因延遲回填倒退;搬到另一個節點或 L1 時保留原截止時間;來源查詢與背景預熱共用有上限的總預算。快取寫入成功只表示一份可丟棄副本已安裝,商家更新成功則表示權威交易已持久化,兩者分開回應。
若產品要求更新成功後所有訪客立刻看到新版,後面的有界陳舊方案就要改選。三十秒是明示的產品取捨;立即可見則需要把協調放進更新確認或讀取路徑。
先用一份資料庫完成讀取與更新
最小版本是一組無狀態目錄 API,加上一個具交易與故障接手保證的資料庫。公開讀取使用 GET /v1/catalog/items/{id},租戶由已驗證的站台或服務身分解析,回應包含 item_id、version、display;管理更新使用 PATCH,帶 expected_version 與請求識別。版本不符就回衝突,同一請求識別重試則找回原結果。
資料表以 (tenant_id, item_id) 為主鍵,保存 version、display_payload、state、updated_at;管理列表另設 (tenant_id, updated_at, item_id) 索引。更新交易原子檢查 expected_version、增加版本、改 payload,並保存請求結果。商品 ID 不重用;刪除保留遞增版本的終態記錄,避免「刪除後重建」讓版本重新從一開始。交易與請求識別的處理可接續短網址服務,這裡不重新設計 ID 分配器。
一次正常更新是驗證商家身分 → 鎖定自己的商品列 → 檢查版本 → 提交新版與請求結果 → 回傳版本 42。讀取則以同一主鍵查短查詢,確認商品屬於該租戶與可展示狀態,再組回應。這個版本沒有跨節點快取一致性問題,先量來源的讀寫混合負載與延遲,就能知道是否需要下一步。
假設容量測試已替此案例設定來源讀取安全預算 20,000 次/秒,並已替更新保留資源。相較讀尖峰,至少需要擋下 1−20,000/300,000 ≈ 93.3% 的來源查詢,才能僅從平均請求數維持預算;實際還要替故障、偏斜與管理強讀留餘裕。因此先加入共用記憶體快取,目標穩態命中率 99%,讓一般回源約為每秒 3,000 次。這是容量目標,尚待壓測證明。
每個 key 除了值,還要帶著來源時間
快取先用 cache-aside:API 先查快取,miss 才查來源並回填。key 是包含 schema 版本的 catalog:v1:<tenant>:<item>,value 保存 payload、來源版本、來源讀取起點、soft deadline 與 hard deadline。各層傳遞截止時間,避免以接收時間重設三十秒。
例如來源查詢在 12:00:00 開始,結果因排隊到 12:00:02 才回到快取,硬期限仍從 12:00:00 算。這裡假設所有參與節點的時鐘相對 UTC 誤差各不超過 100 ms,名義 hard lifetime 使用 29.8 秒,為兩端最壞 200 ms 差額留餘裕;時鐘失控的節點停用快取回應。L1、備份快取及搬移複本都保存同一 absolute deadline,API 在送出前再檢查一次。
這個設計借用 HTTP cache 對傳輸延遲與 resident time 都要計入 age 的原則,應用層版本與期限欄位依本案例定義。RFC 9111 §4.2.3明確把 request/response 延遲與本地停留時間納入 age 計算。
soft deadline 可以在來源讀取後三至五秒隨機分散。soft 到期而 hard 尚未到期時,仍可回現有展示資料,同時讓一個請求負責更新;hard 到期就停止使用,來源不可用時回 503。這樣的 stale serving 消耗既有期限,沒有新增延長。AWS 的雙 TTL 做法提供相同的基本取捨:較早嘗試更新,依賴失效時用到硬期限為止。
真正不存在的主鍵可以短暫 negative cache,例如兩秒,但來源逾時或容量拒絕保留為 UNAVAILABLE,避免把故障寫成 NOT_FOUND。新增商品會產生新版本通知,管理頁又可要求至少建立版本,因此兩秒負快取只影響接受一般展示一致性的訪客。
失效先到、回填後到,單純刪 key 會留下裂縫
現在追蹤一次實際會影響新鮮度的交錯。讀者 R 遇到 miss,去來源取得 v41;商家隨後提交 v42,API 刪除快取;R 最後才把 v41 寫回。刪除命令全部成功,舊內容仍重新出現。加入 version 欄位也還少一個條件:空 key 已沒有可以比較的新版值。
2013 年 Facebook 的 Rajesh Nishtala 等人在《Scaling Memcache at Facebook》中,以 key 綁定的回填 lease 處理 stale set,並限制同 key 回源競爭。原論文 §3.2.1 這提供機制起點,下面再補上本服務需要的重啟與搬移狀態。
快取節點為每個 key 原子管理 generation、min_source_version、active_token。miss 時只有一個呼叫者拿到 token,其餘得到 WAIT 或仍在期限內的 stale 值。token 綁定路由 epoch、owner incarnation、key、generation、單次序號與一秒期限;同一 owner 的發放序號不重用,每次重啟換 incarnation。外部 caller 無權自製 token 或任意 PUT。
Fill(token, source_version, payload, hard_deadline) 必須在 owner 同一原子操作中核對:token 仍是 active、未過期、屬於目前 incarnation 與路由 epoch,來源版本至少等於 min_source_version,且 hard deadline 尚未到。安裝成功即消耗 token。等待者再次 Lookup 就讀到同一結果;填入成功而回應遺失,重試舊 token 不會再次修改狀態,caller 重新 Lookup 即可。
商家更新交易同時保存版本化失效事件,傳送者依 (tenant,item,version) 可重送。owner 收到較新的 v42 時把最低版本推到 42,推進 generation 並撤銷 active token,標記較舊 payload 待更新;重複或較舊事件保持現狀,成功回填也提高已知版本下限。DB 與快取之間沒有共同交易,所以事件傳遞是常態加速路徑,三十秒硬限制仍由來源時間保住。
若交易提交後傳送程序立刻崩潰,來源仍留著 v42 與待送事件,快取可能保留 v41。程序接手後由持久化進度繼續掃描並重送,監看最舊待送事件的年齡;通知中斷期間,一般展示最多用到原 hard deadline,管理者的 min_version 讀取則跳過 v41。已知舊值即使暫時供展示,也保持 stale 標記,收到通知的時間不會成為新的來源觀測時間。
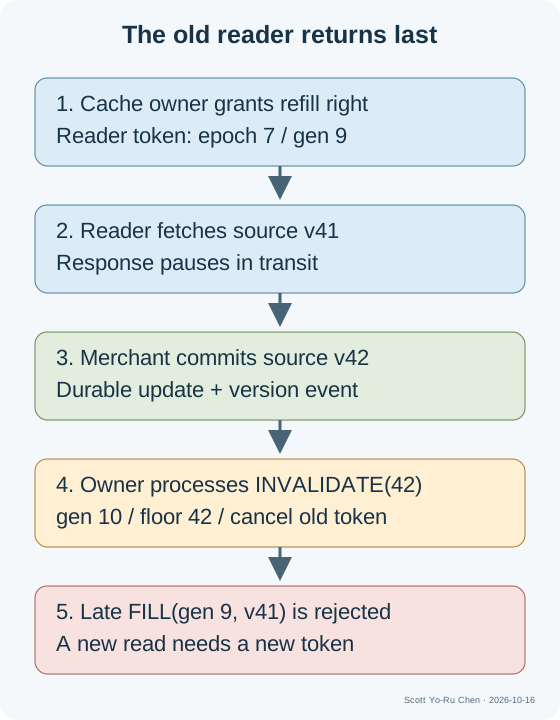
這裡第一個完整故障是 R 讀到 v41 後暫停,v42 事件已處理,R 才醒來。殘留狀態包括 R 的舊 token/payload,以及 owner 的新 generation 與最低版本。R 回填得到拒絕,使用者可改走一次 Lookup 或在原 deadline 內重讀來源;新回填須取得新 token。偵測看版本拒絕計數與失效傳遞 lag,處理時丟棄舊結果,避免無條件 SET 作為補救。
若 owner 在期間重啟,舊 token 也會因 incarnation 不同失效。若只是 value 被 eviction,仍須作廢相關 token;新建 metadata 使用新的發放序號,避免舊 token 因 generation 歸零而復活。版本下限可保留到所有在途來源查詢期限結束,之後才清理;來源讀取超過一秒就放棄,不能無限期帶著舊 snapshot 回填。
Memcached 現行 Meta Text Protocol提供 CAS、更新權與 stale 標記,可作為部分實作材料;完整 token 格式與跨路由語意仍需自行實作並測試,普通 GET/SET/DEL 並未包含上述全部保證。
記憶體放不下後,再決定 key 搬到哪一台
若每筆熱資料連同 key 與基本欄位平均 1,536 bytes,2,000 萬筆需要 20,000,000×1,536=30.72 GB。假設為可用性保存兩份快取資料,原始資料為 61.44 GB,再用 1.5 倍計入 allocator、索引與 metadata,約 92.16 GB。若正常只使用配置記憶體的 60%,需配置約 153.6 GB。這些 GB 均採十進位,程序 RSS 另以實測校準。
這個量級支持把共用快取分到多台,並保留每台的配置餘裕。以十六台均衡放置估算,每台約需 9.6 GB 配置容量;CPU、NIC 與大物件分布還要另測。尖峰只算 payload 回傳就有 300,000×1,536≈460.8 MB/s,約 3.69 Gbit/s,尚未計協定、第二份資料的更新與預熱。容量規劃因此同時看記憶體與每節點服務成本。
TTL 與 eviction 也各自處理不同問題:TTL 限制資料可供應的時間,eviction 在記憶體不足時提前丟棄資料。保留大量低重用掃描結果,會把真正熱門的工作集擠出,讓命中率下降並增加回源。因此先以租戶記憶體配額、最大 value 及入口限制隔離掃描,再評估是否採第二次存取才納入的 admission policy。若第二次存取也要計數,計數表本身同樣有容量上限;盲目替每個任意 key 保存完整 metadata,會把攻擊面移到另一張表。
最簡單的 hash(key) mod N 會在 N 改變時大量改路由。若從十六變十七,均勻雜湊下只有約 1/17 保持相同編號,約 94.1% key 會換位置。這會讓原本的記憶體命中大幅消失。改用一致性雜湊,可把新增節點影響限在其取得的區間;Amazon 的 2007 年 Dynamo 論文描述了這類分區與 virtual node 思路,這裡只借用放置機制,不採用其完整儲存一致性模型。Dynamo §4.2
本設計把 key 先雜湊到固定 4,096 個邏輯 bucket,再以版本化表映射到物理節點;bucket 的 key 集合保持穩定,擴容只改其 owner。它達到有限搬動的效果,也方便逐 bucket 控制進度。理想均衡增加第十七台約需移動 241 個 bucket,即 5.88%;這是主副本 placement 之外的單一 owner 算例,兩份資料的故障域安排另受放置規則限制。
bucket 數量多有助於平均配置,卻無法切開同一 key。若一個商品占每秒 90,000 次讀取,該 key 仍只落到一個主 owner。這時在三十二台 API 各放 0.5 秒 L1,並做 process 內同 key 合併,理想穩態只需約 32/0.5=64 次/秒到 shared cache;代價是多份 payload 與版本通知。L1 仍沿用 hard deadline,沒有因短 TTL 重建新的三十秒。
新節點加入時,先給它可承擔的冷流量
搬動 5.88% key 看似不大,仍可能移走約 118 萬筆熱資料。依前述 1,536 bytes 算,單份 payload 約 1.81 GB。若真的以 100 MB/s 可用搬移頻寬連續複製,至少需要約十八秒,實際還有源端讀取、metadata、節流與競爭。快取可重建,所以也能不複製,但來源就必須承擔冷資料回填。
用數字決定切換節奏:假設被搬 bucket 的 5.88% 流量原先大多命中,一次冷切可能新增約每秒 17,640 次回源,加上原本約 3,000 次,超出 20,000 的安全預算。若每次只切一個均衡 bucket,瞬間新增約 300,000/4,096≈73 次/秒,並在命中率回升後才切下一批,來源就有控制空間。熱門 bucket 要用實際請求率估計,按 key 數平均會低估它。
遷移採「準備、暖機、切路由、排空」四步。新 owner 先接收資料副本及版本通知,所有複製值保留原 hard deadline,不搬 active token。複製途中若 v42 事件先到,新 owner 先提高最低版本,晚到的 v41 複本也要經版本比較。尚未建立足夠失效進度的新 owner,可以直接冷起並只接受從權威來源讀回的新資料。
到切換點,管理平面發布新的 bucket map epoch,舊 owner 停止替該 bucket 發出新回填權,撤銷未完成 token;新 owner 以自己的 incarnation 與 epoch 發放 token。舊路由請求會得到 MOVED 或在原期限內讀到既有副本。若節點失聯導致短暫分裂路由,本設計接受重複快取與重複回源,仍由絕對期限維持展示新鮮度,來源入口的總預算則限制額外負載。
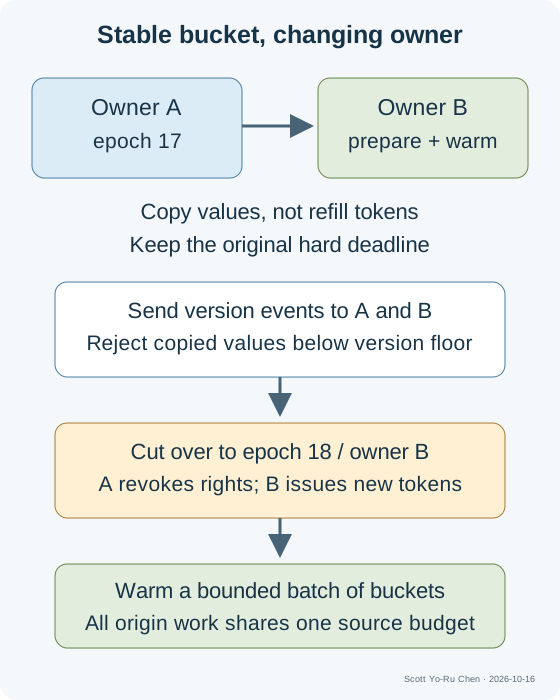
失效事件在過渡期送到舊、新兩組 owner,直到舊路由與在途操作排空。切換後回滾也發布更高 epoch,重新冷起或驗證仍在期限內的資料,保留已知版本下限;不直接把舊 map 與舊 token 一起復活。若失效進度不清楚,就丟棄受影響副本再有界回源。這比搬權威資料庫簡單,原因是允許犧牲命中率重建,商品資料本身仍在來源。
一台快取失效,也可能超過整個來源預算
第二個完整故障是某節點重啟。即使資料與讀取完全均衡,單份 owner 的十六分之一流量約為每秒 18,750 次。若沒有可用第二份資料,與穩態回源相加的保守上界約為 21,750 次/秒,已超過來源預算;全 cache 失效時更是每秒 300,000 次,等於安全容量十五倍。
節點重啟留下空記憶體、新 incarnation、API 上各不相同的 L1 子集;來源商品仍完整。使用者先看到部分延遲增加,接著冷門 miss 可能收到 503,熱門商品可能靠 L1 或未過期限的第二份資料繼續服務。回源率、來源排隊與 cache timeout 搭配健康探針觀測,才能在來源資源耗盡前開始拒絕。
來源入口總上限假設為每秒 20,000 次,前景讀取最多使用 12,000、背景更新與暖機最多使用 8,000,且總 in-flight 再設硬上限。這些額度由有限 owner 分配或共同准入維持,不能讓三十二台 API 各自擁有完整兩萬次。其配額機制可接續多租戶限流服務;此處額外限制實際併行,以免來源由 5 ms 變成 500 ms 後累積大量工作。
同 key 的 token 合併可減少重複回源,卻擋不住隨機掃描的不同 key。來源逾時先停止背景暖機,有效但過 soft deadline 的值繼續用到原 hard deadline,無值或已過期就快速拒絕。每個 miss 等待者也設數量與 deadline 上限;token holder 中斷時等一秒權利到期,由新 holder 接手。重試只交給直接呼叫來源的一層,以有界次數及 jitter 執行。Google SRE Addressing Cascading Failures說明了限制佇列、併行與重試放大的原則;前景與暖機分級則可參照 Handling Overload 的請求重要性與資源配額。
修復時先確認來源延遲回穩、前景拒絕率下降,再逐步恢復 8,000 次背景預算。以 2,000 萬筆、每秒 8,000 個互異 key 的理想條件,全工作集重建至少需要 2,500 秒,約 41.7 分鐘;不能承諾一分鐘就恢復原命中率。實務先暖熱門子集,避免為填滿所有記憶體而推遲有效流量恢復。
當要求改成管理者讀己之寫,沿用版本就能縮小代價
若管理頁只要求「自己的更新立即可見」,不必把所有訪客都改為強讀。更新回版本 42,後續 GET 攜帶 min_version=42;L1 或 shared cache 若版本較低,就跳過該值,在來源預算內查到至少 42。這把一致性需求放在具體使用流程,而非全站停用快取。
假設這類讀取占尖峰的 1%,最多額外需要每秒 3,000 次來源查詢,與一般 3,000 次合計約 6,000,仍低於前景 12,000 預算。若增加到 10%,額外 30,000 次就已超過總容量,必須增加來源、改善版本化副本,或調整功能承諾。min_version 也要限制在可信 API 回傳的版本或受控範圍,避免任意巨大數字造成持續回源。
另一個替代是 write-through,把更新先寫來源再同步寫快取,降低常態失效延遲;但來源成功、快取失敗仍會留下裂縫,成功回應的意義需要重新定義。若選版本不可變 key,例如 item:42,舊回填覆寫的問題會減少,卻仍需為「目前版本是幾」建立新鮮度規則。資料變成不可變,沒有讓版本指標消失。
在這個讀多寫少、展示允許三十秒落後的案例,cache-aside 加版本失效與有界 stale 比同步雙寫更簡單。若改成權限撤銷、立即下架的安全判定,應讓該判定經過最新權威狀態,或在確認成功前完成受控服務集合的切換;不要沿用展示資料的陳舊政策。
把故障交錯做成可重跑的檢查
隨文提供的 狀態模型程式只用 Python 標準函式庫,以可控制的虛擬時間測試回填。本次執行的十項測試全數通過,覆蓋失效後舊值回填、亂序事件、lease 到期、新 token 接手、owner 重啟、路由切換、metadata 淘汰與 hard deadline 繼承,另檢查單次 token 與租戶 key 隔離。這是協定局部的可執行範例,並未啟動實際 Redis/Memcached 或網路叢集。
整合測試還要加入均勻及熱門分布、資料大小偏斜與隨機不存在 key;在讀來源後暫停 reader,插入更新、重啟或搬移,再放行舊回填。逐步把來源延遲拉高,核對總准入與 in-flight 仍受控;中斷版本事件傳遞,確認各層 hard deadline 一致,超過後回 503。讀取抽樣與權威版本比對時,記錄真正來源觀測時間,避免以 cache 最近命中時間冒充資料年齡。
日常指標應同時包含有效讀取成功率與 P99、fresh/stale 命中比例、hard-expired 拒絕、回源 QPS/併行、版本拒絕、失效 lag、top bucket 流量、暖機進度與租戶記憶體占用。高基數 item ID 放抽樣 trace,不放所有 metrics labels;租戶 key 空間、最大 value、並行回填及記憶體皆有配額,避免一家租戶的掃描把其他資料全部擠出。
上線先做影子讀取,抽樣比較版本與期限,再逐租戶提高使用比例。快取回滾與來源入口限流一起切換,避免「暫時繞過快取」瞬間將三十萬次讀取送到來源。schema 升級使用新命名空間但共用來源預算,舊命名空間依期限排空;源端更新仍維持相同商品版本,不因快取格式改版重置。
回到商家更新與訪客讀取,這個方案讓資料庫只承擔權威更新與有界回源,快取承擔大量可重建的讀副本。版本與單次 token 擋住已知失效後的舊回填,固定 bucket 減少擴容搬動,原始截止時間限制跨層與搬移的陳舊程度;任何故障下,來源容量都由入口預算保護。下一個問題才是:若資料本身由 key-value 儲存服務保存,寫入確認要如何跨故障留下來?那將進入 WAL、複寫確認與耐久性。
證據範圍
商品目錄、API、資料模型、token 格式、遷移流程、SLO 與全部容量數字均為參考設計或假設算例,不是任何公司的內部架構或實測容量。狀態模型通過只支持其列出的交錯與局部規則,無法替代網路隔離、時鐘、程序中斷、資料庫接手及完整負載測試;硬期限的推導依賴來源讀取新鮮度、每端時鐘誤差不超過 100 ms,以及 API 在送出前的期限檢查。
兩份快取資料提高部分故障下的命中機會,並未提供權威資料耐久性或副本線性一致性。短暫分裂路由可造成重複查詢及不同版本,仍須在來源時間期限內;全站版本立即可見、安全撤銷與跨區域多活不在基線承諾內。Memcached 文件僅支持其中的 CAS/stale 機制,完整協定仍是本案例設計。本文沒有執行實際叢集 benchmark。
References
- Rajesh Nishtala 等人,Facebook,Scaling Memcache at Facebook,NSDI 2013,cache-aside、stale set 與 lease。
- Giuseppe DeCandia 等人,Amazon,Dynamo: Amazon’s Highly Available Key-value Store,SOSP 2007,§4.2 分區與 virtual nodes。
- AWS Builders’ Library,Caching challenges and strategies,容量相依、雙 TTL 與失效時的取捨。
- Memcached 官方文件,Meta Text Protocol,CAS、anti-stampede 與 stale serving;查核於 2026-10-16。
- IETF,RFC 9111 HTTP Caching,2022,§4.2.3 age 計算。
- Google SRE,Handling Overload,2016,資源配額、請求重要性與客戶端節流。
- Google SRE,Addressing Cascading Failures,2016,佇列、in-flight 與重試放大。