
如何設計多租戶 API 限流:從共享配額需求到跨節點判定
假設我們正在設計一個讓企業客戶建立物件、查詢資料的 API 平台。不同公司共用後端資源,其中一家客戶啟動批次工作,短時間送入大量請求。它的請求占住處理資源,其他客戶開始遇到延遲與逾時。平台需要限制每家客戶的用量,讓正常請求仍能穩定完成。
現在的設計問題是:如何替這個平台加入限流,讓同一家公司的請求無論經過哪一台入口,都受到一致的配額控制? 還要讓客戶知道為什麼被拒絕、何時值得再試,以及限制服務故障時平台會如何處理。
「每家公司每秒只能呼叫一千次」看似已經是完整需求,但它留下了幾個會改變設計的問題:一家公司的多把 API key 要分開算嗎?一千次廉價查詢和一千次昂貴建立等價嗎?閒置後突然送來一批請求,是否應該允許?接下來先把這些問題釐清。
這是一個作者提出的假設案例,數量與政策用來推導架構,並非某家公司的內部資料。既有短網址服務可作為被保護的 API;前篇的 ID 分配則會在後面比較批次配額時派上用場。
圖中先只保留原有問題:兩家客戶經過不同入口,最後仍競爭同一批後端資源。A 的批次流量增加,B 的請求也可能跟著等待;接下來要釐清計量對象與可接受的突發,再決定配額狀態應放在哪裡。
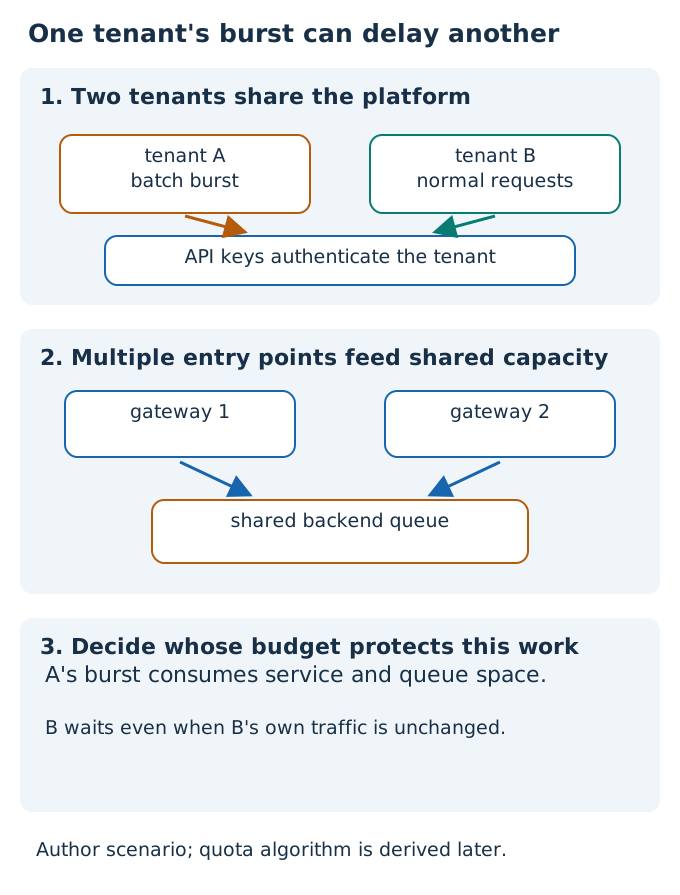
圖:作者設計的假設平台情境,未指定限流演算法。故障與過載機制參考:Google SRE — Addressing Cascading Failures。
誰共用配額,哪些操作需要被限制
先問限制的對象是誰。若按 IP 計數,一家公司透過多個出口便能取得多份配額,多家公司共用出口又可能互相影響。若按 API key 計數,客戶建立新 key 就可能擴大預算。因此本案例選擇「企業租戶」:同一公司的多把 key、不同使用者與入口節點,共用同一租戶預算。租戶身分來自驗證結果,外部自行填寫的 X-Tenant-ID 不能成為計數依據。
再問一次請求值多少。平台的查詢通常比建立便宜,先以 route class 定義成本:普通查詢一單位、昂貴建立五單位。這些是粗略的保護權重,不能用來聲稱精確計量 CPU。第一版不做帳務結算、逐使用者方案、跨區域共享預算,也不負責把批次工作排到未來執行;超過配額的請求會收到明確拒絕。
第三個問題是何時扣額。若只計後端成功,客戶可以大量送出最後失敗的昂貴操作,資源已消耗卻不算用量。因此選擇在准入時扣額,後端失敗也不自動退回;gateway 在轉送前崩潰會有保守扣額,這是刻意接受的代價。業務重試是新的准入嘗試,是否重複建立同一物件仍由業務冪等鍵處理。配額允許與業務完成是兩個不同的結果。
接著問可用性與延遲。假設健康狀態的限流判定 p99 要在五毫秒內,有效判定成功比例至少 99.99%。配額不足的正常拒絕算成功判定;判定逾時算服務失敗。對昂貴寫入,先選擇無法確認配額就拒絕;廉價讀取是否值得採用有界緊急額度,留待故障情境再決定。
最後問「公平」的範圍。每租戶有上限,不代表每租戶都有保留容量。若所有租戶的方案上限加起來超過後端能力,仍要有全服務的資源准入。例子很直接:每秒一千個請求,平均執行由十毫秒拉長到兩秒,穩態並行量約從十個升到兩千個,因為 並行量 ≈ 到達率 × 停留時間。所以後端另設有界並行與佇列;本次限流只負責入口配額,不承諾排程公平性。
一千次的上限,是否允許閒置後突發
還有一個需求必須先回答:配額允許短暫突發,還是要求任意時間窗口都不超額?
假設一家公司平常每秒只有十次查詢,偶爾一次提交五十筆資料。本案例希望容許有限的短批次,但限制它持續占用後端。這需要兩個參數:長期可使用的速率,以及閒置後能立即使用的額度。用「每秒補充 r 單位、最多存 B 單位」描述,客戶便能預期自己的批次何時會被限制。這個模型稱為 token bucket。
例如 r=100 units/s、B=20 units,滿桶時最多立即准入二十次普通查詢,或四次成本五單位的建立。之後一百毫秒補十單位,最多再放行兩次建立。這樣定義後,才有理由選 token bucket,並把每租戶狀態縮成「還有多少額度、上次何時補充」。
理想計量時鐘下,任意長度 T 秒的區間,其准入成本包絡是 A(T) ≤ rT+B。2002 年的 RFC 3290 附錄 A描述了這個速率與桶容量模型;將封包 bytes 改為 API 成本單位,是這個案例的設計。
如果剛才的需求答案不同,演算法就要改。
若產品要求「任意六十秒最多一千次」,token bucket 不直接等價。令 r 等於 1000/60、B 等於一千,六十秒包絡可到兩千次。固定分鐘計數也有跨界突發:前一分鐘最後一毫秒一千次,下一分鐘第一毫秒再一千次,兩毫秒就兩千次。
因此先選「有限突發加持續速率」作為本案例的契約。精確滑動窗口保留為需求改變時的替代方案,不能讓兩種政策共用一個模糊的「每分鐘上限」名稱。
先用一個入口做出能運作的版本
先把平台縮成一個入口 process。它驗證租戶身分,找到該租戶的 tokens、last_refill,依現在時間補充額度;足夠就扣掉成本並轉送,不足便拒絕。用一個鎖保護同一租戶的「補充、判斷、扣除」,就能完成正常請求;此時無需獨立限流服務或分片。
以前面的二十單位桶為例,客戶連送五個建立請求,每個成本五。假設五個請求在同一個可忽略補充的短區間抵達,前四個放行,第五個拒絕。過五十毫秒補回五單位,第五個再試便可能成功;若其他請求先用掉補充額度,它仍可能被拒絕。對外的等待時間因此只能是建議,不能當成未來額度預留。
單一 process 的正常路徑已經可以運作,但它還沒有滿足「不論走哪一台入口都共用額度」。假設 gateway 由一台增加成三十二台,每台都保存同一租戶完整的 r=100、B=20。所有桶合起來就能持續放行三千二百單位/秒,立即突發六百四十單位。原本的租戶上限被放大三十二倍。
一個直覺修正是把速率與桶容量平分。只要各 r_i 加總不超過 r、各 B_i 加總不超過 B,且 owner 集合與計時條件受控,合計仍符合原包絡。問題轉成利用率:若九成請求落到一台,該台只有約 100/32=3.125 units/s,其他節點閒置的額度幫不上忙。這適合分布穩定或可固定租戶路由的系統。
本案例假設負載平衡器會移動請求,也允許 gateway 擴縮,因此先改成同一租戶只有一份共用桶狀態。gateway 將准入判定交給它,取得允許後才轉送。這解決了配額加總,但也新增一次網路判定;接下來要算這條共用路徑需要承受多少工作。
共用判定需要承受多少流量
先向平台確認規模,這個案例採用以下假設:二十萬個活躍租戶、三十二台 gateway,平均二十萬次請求/秒、尖峰一百萬次/秒。每次請求都做判定,因此主要負載是一條持續改動狀態的路徑,policy 管理讀寫的頻率相對低。若一次判定 RPC 的 request 加 response 約三百八十四 bytes,尖峰總 payload 是 10^6 × 384 B = 384 MB/s,約 3.07 Gbit/s;尚未計 TLS、封包標頭、複寫與重試。RPC 數量比這個純頻寬更容易形成 CPU、連線與尾延遲成本。
若權威狀態平均每租戶一百二十八 bytes,二十萬桶的原始資料僅 25.6 MB。因此這個服務的第一個瓶頸通常是判定頻率與偏斜,並非桶狀態總量。若單一權威已不能在目標延遲內承受流量,可以按租戶雜湊成六十四個邏輯分區,讓不同租戶平行更新;均勻尖峰每分區約 15,625 decisions/s,但這只是目標負載,不能當成已測得容量。
假設單一大租戶占十五萬次/秒,它的桶仍要在同一條原子更新路徑上。六十四分區不能把一個 key 平分六十四次;增加一般分區只幫助其他租戶。應先量這個熱點的串行 CPU、commit 與排隊延遲,再決定要讓它獨占分區、降低可用配額,或導入局部額度。把同一租戶任意拆成多個完整桶會直接改變上限。
另一個數量級是短期去重:若每次判定保存八十 bytes 的結果,保留兩秒透明 RPC 重試窗口,尖峰是 10^6 × 2 × 80 B = 160 MB,反而超過桶狀態六倍。實際還有索引、allocator 與複寫。這筆成本告訴我們:去重窗口必須與最大 RPC deadline 一起設計,不能讓任意外部 key 永久進入限流狀態。
這些估算給出兩個決策:先按租戶分區,維持每個桶的唯一更新位置;另外單獨追蹤熱門租戶,因為它不會隨一般分區數增加而自動變快。六十四是容量規劃的示例,實際 physical node 數需由目標負載與 commit latency 測試決定。
把 API、狀態與一次請求接起來
將前面的共用桶做成內部服務後,gateway 依 hash(tenant_id) 找到權威分區;「權威」表示只有這裡能宣布該租戶額度已扣除。初期 policy 管理與判定可以在同一個服務,狀態留在支援原子交易與持久化的主寫入庫。之後分區時,同一租戶的 policy、桶與判定紀錄一起搬,避免一次判定變成跨分區交易。
gateway 可以快取路由與政策描述,不能快取「上次允許」當作下一次通行證。它另有粗粒度本機入口限制,保護限流服務本身;這個本機限制不代表完整租戶額度。
圖 1|作者設計;本機粗限流搭配全域判定的分層思路參考 Envoy global rate limiting。
內部 API 是 Check(tenant_id, route_class, attempt_id, deadline)。attempt_id 由可信 gateway 為每次准入嘗試生成,外部使用者不能指定或跨 gateway 重用。回應含 ALLOW / DENY / UNAVAILABLE、policy_version 與估計等待時間。ALLOW 只能在本次 attempt 的 deadline 內使用;gateway 對該 attempt 的轉送狀態做本機原子轉移,避免同一 RPC 的重複回應觸發兩次轉送。
配額不足對外回 429;權威服務不可達且此路徑選擇保守拒絕,回 503,不要把基礎設施失效說成租戶違規。2012 年的 RFC 6585定義 429 可附 Retry-After,也明定此回應不能被 cache 保存;它沒有規定應用如何辨認租戶或計數。等待時間只是重新嘗試的建議,其他請求可能先消耗補充額度,不能保證屆時必定成功。
資料模型可縮到三個同分區物件:policy(tenant_id, version, r, B, route_costs, mode)、bucket(tenant_id, tokens, last_refill, applied_version)、decision(tenant_id, attempt_id, request_hash, result, expires_at)。主索引分別是租戶、租戶,以及 (tenant_id, attempt_id);去重到期用時間索引或分批清理,不能在一筆准入交易中掃遍所有歷史。相同 attempt 配不同 route 或成本要拒絕。
走一個完整請求:租戶 A 用已驗證的 key 建立物件,gateway 對本次嘗試生成 attempt_id → 本機入口保護通過 → 租戶 A 的權威分區查重、取出建立成本五、補充並扣額 → 確認後回 ALLOW → gateway 對本次嘗試只轉送一次 → 後端並行檢查 → 業務交易。若桶不足,請求在 gateway 收到 DENY 後結束,後端不會收到它。
政策管理者讀取版本化 policy cache 即可;若客戶想查看剩餘量,可以查權威狀態,但回應後其他請求立刻可能扣額,顯示值不能作預留。集中模式的配額以權威提交 ALLOW 的時刻計入;回應傳輸和轉送可能延後,因此後端的實際到達突發還要受 deadline、in-flight 與並行上限控制。
補充、判斷、扣除必須是同一次狀態轉移
正常請求走通後,先追問兩個請求同時到達會怎樣。共用狀態只解決「在哪裡保存」,還要讓同一個剩餘 token 不會被兩台 gateway 同時承諾出去。
集中模式最小演算法如下,整段在租戶桶的原子邊界內執行,使用權威端時間,不接受 client timestamp:
若 attempt 已存在:驗證參數與期限,回原結果
t = max(authority_now, last_refill)
available = min(B, tokens + r * (t - last_refill))
若 cost <= available:new_tokens = available - cost,結果 ALLOW
否則:new_tokens = available,結果 DENY
保存 new_tokens、t、policy version 與 decision
依選定的持久化/複寫契約確認,再回應
兩台 gateway 同時讀到一個 token,若各在 client 端判斷、再覆寫零,就會放行兩次。將補充、比較、扣除和 decision 放在同一交易,第二筆只會看到第一筆扣除後的狀態。拒絕也要保存本次補充後的時間與數量,避免後續重複補充;分數 token 用整數微單位與餘數保存,不能每次都向上取整憑空生額度。
cost > B 的操作永遠等不到足夠 tokens,應當視為 policy 配置錯誤或另設昂貴操作規則,不能一直回一秒後再試。桶狀態只可在已閒置至少 B/r 且沒有未過期 decision/grant 後安全刪除,因為此時重新建滿桶與正常補充等價。重啟或 eviction 任意把桶設滿,等於額外給一次突發預算。
若選 Redis 實作,server-side Lua 能讓該次狀態更新不被其他命令交錯,但腳本也會阻塞同一服務的其他工作,必須保持有界、先驗證參數,不能把大量滑動視窗清理塞進熱路徑。這是 Redis Scripting with Lua提供的局部原子語義;它沒有自動建立跨故障接手的確認保證。
接著把網路放進這條路徑。第一個完整故障時序是扣額成功但回應遺失。T0:桶有十單位,A 的成本一單位;權威原子寫成九並保存 ALLOW。T1:回應在網路上丟失,gateway 還沒轉送。T2:gateway 用同一 attempt 在 deadline 內重試,權威找到 decision,回原 ALLOW,桶維持九。T3:gateway 原子標記本次已轉送,後端收到一次嘗試。若 T2 前 deadline 已過,gateway 必須放棄舊 attempt;使用者稍後重新呼叫會產生新 attempt,舊的一單位不退回。
殘留狀態是少一 token 的桶、短期 decision,以及 gateway 的未轉送狀態。使用者可能只看到延遲,或在重試窗口耗盡時看到 503;不應看到同一 RPC retry 被扣十次。偵測看 decision replay、逾時後放棄率與「已確認允許/實際轉送」差額。恢復無需補償交易,保守扣額會隨正常 refill 消失。如果 gateway 已轉送後失去業務回應,則進入業務冪等問題;重放限流判定不能替它消除副作用。
原子更新之後,還有主節點接手的界線
現在已經能處理同時到達與回應遺失,下一個要求是單節點故障後仍保留已確認扣額。主節點的原子更新不足以回答這件事,必須追到接手節點從哪份狀態繼續。
第二個故障是扣額在接手後消失。舊主把桶從一百扣到二十,回出八十個 ALLOW,備份卻仍是一百。提升落後副本後再允許一百個,短時間一共放行一百八十個。所有單次扣額都可能是原子的,仍然違反原來的上限。
對契約性的硬上限,我會要求每分區只有一個有效寫入權威;成功回應建立在故障模型內可保留的日誌提交上,且切換先隔離舊主、恢復已確認狀態。可以用具有共識日誌的狀態機或合適的資料庫提交與接手契約實現,但要驗證 commit 邊界,不能只寫「三副本」。時間也納入故障模型:新權威不能以失控的前跳時鐘立刻補滿桶;回撥可暫停補充,過大的前跳或偏差則撤出服務。若只能保證時鐘誤差,應公開帶時間誤差的包絡,或降低名義速率留出餘裕。
Redis 官方複寫文件明確指出預設非同步複寫,WAIT 也不把部署轉成具強一致性的系統,特定故障下已確認寫入仍可能遺失。因此 Redis 加原子腳本適合可以接受短期超額的防濫用限流;若要用於不可超支的預算,必須另證明接手與持久化邊界。這是保證的差別,無法用較低的 benchmark latency 抵銷。
若平台選擇近似模式,超額應明確量化。假設故障前實際允許速率為五萬單位/秒,遺失零點二秒已確認扣額,可能重新放出約一萬單位;這是持續流量與落後時間的算例,突發還會再增加。副本落後若沒有硬上界,就不能聲稱只有固定百分比誤差。觀測 replicated offset、接手世代和 confirmed watermark;無法建立上界時,先拒絕或將桶保守設零,再從安全時間慢慢補充,代價是正常租戶也會被誤拒絕。
如果上限改成任意六十秒,哪些狀態必須改
前面選擇允許有限突發。如果產品後來要求任意六十秒都不能超過一千次,集中權威的位置可以沿用,但只保存剩餘 tokens 已不足以辨認哪些請求仍在窗口內。需要改變的是每個租戶的計量狀態與判定演算法。
精確 sliding window 可以保存已接受嘗試的時間與成本,用有序佇列清除 (now-W) 之前事件,維持成本總和,檢查後追加;同樣要在單一權威原子執行。每單位成本相同時也可用按 timestamp 排序的集合,事件 member 需唯一,不能讓相同毫秒的多筆請求覆寫。若熱租戶允許二十萬次/秒、W 是六十秒,窗口就有一千二百萬事件;每事件理想化三十二 bytes 是 384 MB,未計有序索引及記憶體放大。相較之下 token bucket 只要固定大小狀態,這個差距足以決定是否真的需要精確窗口。
近似的兩窗口計數用 C_current+(1-x)C_previous,x 是目前窗口已經過的比例。它假設前一窗口分布均勻;若事件全擠在前一窗口末端,實際仍在最近 W 內,估計卻先打折。當 x 為零點五且前一窗口有一千次時,可能少算五百次。所以合約硬窗口應選精確日誌,或可證明保守的時間分桶上界;對軟性防濫用才考慮兩計數近似。這些都是作者推導的替代方案,不能只因某個產品叫 sliding window 就假設它精確。
熱租戶把中央扣額改成局部額度,誤差從哪裡來
回到允許有限突發的基線,集中方案已經滿足主要正確性要求。再看容量估算:如果一個租戶持續占十五萬次判定/秒,該租戶分區的串行更新先碰到瓶頸,還有哪些選擇?
可以維持逐次判定,把它搬到獨占權威分區;這保留原契約,代價是專用容量與每次 RPC。若測量證明瓶頸仍在協調頻率,而業務接受可量化的額外突發,才值得引入批次額度。
熱門租戶可向權威預領 q 單位:中央先按同一 token bucket 原子扣掉 q,保存 grant_id、owner_incarnation、policy_version、expiry,確認後交給 gateway。owner incarnation 識別 gateway 的這一次 process 生命週期,重啟必須換新的身分。gateway 在本機原子消耗 grant;沒有本機 refill,沒有額度就再請領。每個 owner 同時最多持有 q 未消耗單位,預領也算在這個上界內。這是作者設計,不等同於把完整的 r、B 複製到每台節點。
圖 2|作者設計;quota assignments 與逐次判定是不同路徑,可參考 Envoy global rate limiting,本圖的扣額及誤差契約由作者提出。
它與前篇號段有一個關鍵差異:ID 區間放在記憶體多久都不影響唯一性,限流額度延後使用卻會影響何時發生突發。中央分配流量滿足 G(T) ≤ rT+B,不代表 gateway 的實際放行流量也滿足相同包絡。
設區間開始時未消耗額度是 U_start。區間內准入最多來自原有額度加新 grant,所以 A(T) ≤ U_start + G(T) ≤ U_max+rT+B。若一租戶最多有 N 個可消耗額度的 incarnation、每個至多 q,則 U_max ≤ Nq。這是理想時間、grant 不重複且不退回條件下的保守上界;新增的是突發誤差,長時間平均增量為 Nq/T,不能把它宣稱成每秒固定誤差。
假設算例:r=10,000 units/s、B=2,000、N=32、q=100,新增突發餘裕是三千二百,實際包絡變成 10,000T+5,200。中央協調在充分利用下約由每秒一萬次降到一百次;低利用率、到期與小批請領會提高這個數字。平均每 gateway 約三百一十二單位/秒,一百單位只撐約零點三二秒,並沒有獲得很長的離線可用時間。
如果業務只接受兩百單位額外突發,需 q ≤ floor(200/32)=6,協調頻率回到至少約 10,000/6 ≈ 1,667 次/s。另一條路是減少持有配額的 owner 數,或在每台另外做 pacing;不能同時保留大 grant、任意負載移動與近乎零誤差。控制面中斷後最多消耗當時剩餘 U,耗盡或到期就拒絕;這是有界的暫時繼續服務,不是無限制 fail-open。
grant RPC 的重試用同一 grant_id,權威回同一分配;重啟換 incarnation,丟棄舊 grant。expiry 後也不退回中央桶,因為它已靠時間 refill;退款可能創造第二份容量。暫停後醒來的舊 process 必須在每次准入前檢查期限,且時間來源要涵蓋暫停/休眠;無法界定時鐘偏差時停止離線消耗。新 incarnation 與仍可能復活的舊 incarnation 都計入 N,不能只數目前註冊的三十二台。否則滾動重啟會不斷累積舊額度,剛才的 Nq 就失去意義。
配額降低與停用,何時必須生效
還有一個需求變動沒有處理:管理者可能在租戶持續使用時降低方案,甚至要求停用。集中桶只需更新一份權威狀態;批次額度已在 gateway 手中,生效時間便成為新的限制。
policy 降額也屬於狀態變更。集中桶先用舊 r 補到切換時刻,再令 tokens=min(tokens,B_new),寫入新版本;不能換一個 version key 就新建滿桶,否則每次改配置都送一次突發。局部 grant 模式若突然撤銷租戶,舊 owner 仍可能持有 U 單位直到 expiry;推送通知可加快,但不是立即撤銷的證明。要求即刻生效的路徑必須重新走權威檢查,或經過會驗證最新世代的共同閘口,接受其可用性與延遲成本。
限流服務失聯時,把損失限制在哪裡
最後回到需求釐清時留下的可用性問題。正常狀態的五毫秒目標沒有決定網路隔離期間應該怎樣;集中與局部額度兩種方案,此時會提供不同的服務結果。
圖 3|作者設計;快速拒絕與有界重試的操作原則參考 Google SRE:Handling Overload。
第三個情境是限流分區網路隔離十秒。集中模式 gateway 在五毫秒判定預算耗盡後回 503,不轉送;有 grant 的路徑只能消耗未過期餘額。假設剛才每台都剩一百單位,三十二台最多繼續三千二百單位;實際各台剩量與負載不同,不能宣稱全站一定可撐零點三二秒。grant 用完或時間不可證明時進入拒絕狀態,連線恢復後每 incarnation 僅一筆 outstanding grant RPC,加入退避與 jitter,避免所有節點同時預領將恢復中的權威壓垮。
fail-open 是另一種明確取捨。對廉價讀取可配置獨立的緊急本機桶,但此桶必須有全站加總速率、burst 與最長使用時間 H 的上界。如果緊急速率總和八百/秒、總 burst 一千六百、只允許十秒,失聯期間額外准入最多約九千六百單位。它屬於契約外明示的緊急預算;如果每台用完整租戶上限且無期限,超額就無法以固定數字限制。昂貴寫入與不可超支配額維持 fail-closed。後端並行上限在所有模式都有效,防止「為可用性放行」變成資源耗盡。
限流本身也要保護。gateway 本機粗桶限制送往權威的總 QPS,先驗證身分再建立狀態;未驗證流量以連線與入口資源上限處理。descriptor 必須是白名單 route class,不能拿任意 URL、query string 或使用者輸入作 key,否則攻擊者能產生無限基數。每租戶 state、管理 API、grant 請領都有上限;路由熱租戶時保留其他分區資源,避免一個桶占滿 CPU 連帶拒絕整站。
上線驗收要量誤拒絕,也要量超額
操作上至少分開三類 SLI:配額不足的正常拒絕、權威無法判定的失敗,以及符合契約卻被保守扣額/偏斜限制拒絕的損失。監控判定 p99、分區佇列與 commit latency、decision replay、時鐘偏差、policy 生效延遲、grant 未用量 U、過期丟棄量及後端 in-flight。用低基數總量與抽樣追蹤租戶,不能把每個 attempt_id 都放進 metrics label。
驗收應獨立記錄准入時間與成本:集中模式計權威提交,局部 grant 模式計 gateway 消耗;再逐區間比對 rT+B 或承諾的誤差包絡,不能拿中央分配數冒充實際放行數。給均勻流量之外,再給單租戶熱點、窗口邊界突發、成本混合、扣額後丟回應、落後副本接手、時鐘前跳、舊 process 暫停後復活與降額。這些是建議的壓測與故障注入,並非本文已實跑的結果。
遷移時先做 shadow 判定,使用獨立桶且完全不影響真實准入,量測拒絕差異與權威容量。正式切換逐租戶進行,同一租戶只有一個有效 enforcing owner;舊版與新版不能各自持有滿桶同時放行。重分區可先停止該租戶新判定,等在途判定與 grant deadline 結束,再搬 bucket、decision 與版本,切路由後才恢復。需要不中斷搬移時,才增加有序變更日誌與 ownership cutover,別用暫時雙寫規避原子責任。
回滾保留目前桶餘額與已消耗 grant 狀態,不能重新初始化滿桶。若狀態格式不相容,寧可短暫保守設零並按安全速率恢復,也要把誤拒絕預算明寫出來。Google SRE 的 Handling Overload(2016)強調重試需要預算,且多層同時重試會形成組合放大;這裡同樣要求只有直接呼叫權威的一層處理透明重試,上游看到 429 或失聯拒絕時不能立即無限重送。
回到起始需求,哪些承諾已經成立
回到最初的 API 平台,現在可以逐項核對要求:租戶由驗證身分決定,多把 key 共用預算;route class 決定成本;准入已扣額,即使後端失敗也不自動退款;正常超額回 429,無法判定回 503;後端並行上限獨立保護實際資源。
初始採用按租戶分區的集中桶,是因為需求要求共享額度、負載會移動,而判定頻率與少量桶狀態支持這個最小方案。每次扣額須在同一原子邊界內,且已確認狀態可在約定故障中保留。只有熱門租戶的協調路徑成為實際瓶頸,且業務同意 Nq 的額外突發,才切到局部 grant。若需求改成任意六十秒的硬上限,就改用精確窗口並承擔事件儲存成本。
因此仍有明確限制:單區域失聯時昂貴操作可能不可用,租戶上限不保證保留資源,成本權重不代表精確帳務,局部額度也不能保證立即撤銷。這些界線與最初的功能目標一起,構成可交付的設計。
下一個自然問題是:gateway 已能快取 policy 與路由,API 的讀取資料也能快取,但權威版本改變後如何避免舊資料回填?下一篇將以完整的分散式快取服務,追蹤失效競態、熱門 key 與回源容量。
References
- RFC 3290: An Informal Management Model for Diffserv Routers — IETF,2002;附錄 A 的 token bucket 模型。
- RFC 6585: Additional HTTP Status Codes — IETF,2012;429 與 Retry-After 語義。
- Global rate limiting — Envoy 官方現行文件;逐次判定、quota 分配與分層限流。
- Scripting with Lua — Redis 官方現行文件;原子執行與阻塞界線。
- Redis replication — Redis 官方現行文件;非同步複寫與 WAIT 的保證限制。
- Handling Overload — Google SRE,2016;過載處理與重試預算。