
NVIDIA NVDLA 把 IP 配置接到可驗收的綜合交付:五個分區與 SRAM 邊界
可配置加速器 IP 的重用價值,來自把已完成的功能設計帶進不同 SoC;整合者仍要讓硬體配置、軟體能力、記憶體實作與時序假設彼此一致。NVDLA 的公開流程把這個交接問題具體化:同一份 configuration 會生成 RTL 與測試環境,五個綜合分區又各自需要相容的 SDC、library 與實體 view。配置一致性因此是跨階段的驗收條件。
從系統需求選定算力與 buffer 尺寸,到工具產生可交付 netlist,中間包含多種不同承諾。Generator 接受參數,代表它能產生某個設計;simulation 檢查指定行為;synthesis 則把邏輯映射到目標製程資源。原本依靠整合工程師辨認版本與交接條件的流程,在配置、SRAM 家族或工具分支增加後,容易出現各階段都能執行、卻沒有在處理同一份設計的問題。
研究這條公開路徑的價值,是找出哪些工程知識可以轉成可檢查的交付契約:配置如何影響驗證與軟體,behavioral RAM 如何接到實體 cell,分區綜合成果如何被後端接收,以及錯配後哪些證據必須失效。這些相依關係決定成果能否安全重用,也決定平台與 agent 可以自動化到哪裡。
NVIDIA 在 2017 年 9 月公開 NVDLA 硬體原始碼與參考綜合腳本,並於 2018 年 4 月釋出可配置 v2。以下以其整合手冊、配置說明及驗證手冊分析公開 IP 的整合方法;成果管理與驗收方案會清楚標為作者設計。
先沿圖從 configuration 分出去看:RTL、測試與軟體可見能力,都必須對應同一組配置。進入綜合後,還要接上目標 SRAM、library 與 SDC;所以每一份交付成果都帶著輸入條件,單看檔名或工具成功訊息不足以判斷能否接收。
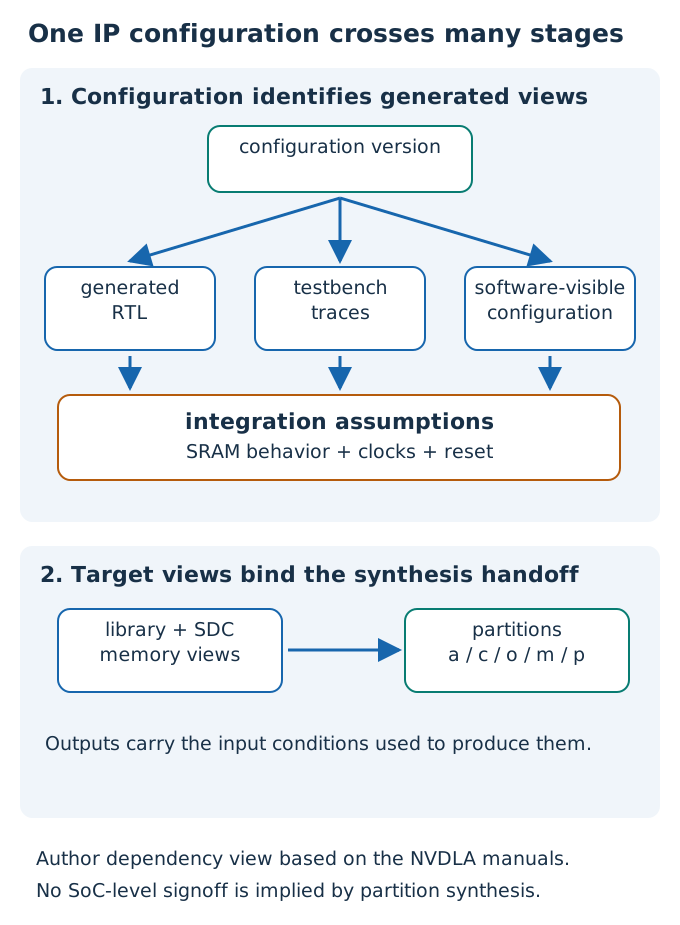
圖:作者依 NVDLA Integrator’s Manual、Configuration and Scalability整理的相依關係示意,非完整 SoC 架構。
一份配置會跨過哪些設計邊界
NVDLA 的 hw/spec/defs/<config>.spec 選定硬體組態,tree.make 固定要建立的 project 與工具位置,tmake -build vmod 產出對應的 RTL;ready_for_test 另建測試環境,verif_protection 可跑基礎保護測試。官方環境設定指南列出生成結果放在 outdir/<project>/vmod,也列出 cmod_top 的獨立 build target。這些目錄與命令讓配置不只是一行 define,而是有具體衍生物的 design state。
從平台角度看,第一個重要機制是配置要同時約束三種讀者:RTL 生成器讀取硬體參數,驗證環境使用同一 project 選擇 test plan,軟體可由 ConfigROM 理解硬體能力。官方scalability/ConfigROM 文件列出 nv_small 與 nv_large 的 MAC atomic size、CBUF 尺寸、功能位及 sub-unit descriptors;例如 nv_small 的 NVDLA_MAC_ATOMIC_C_SIZE 與 K_SIZE 都是 8,nv_large 分別是 64 與 32。這不是單純效能檔位:尺寸與功能位改變,測試資料對齊、buffer 行為及驅動程式對能力的判斷也必須一致。
有一個值得留意的公開限制:手冊列出多種配置,卻只對 nv_small 的當時驗證程度作出明確承諾。平台因此不能把「generator 接受參數」寫成「所有組合已驗證」。我的建議是替每個配置保存 spec 內容識別、生成工具版本、產生的 RTL 清單、ConfigROM 預期值與已通過的 test-plan ID。這是由公開流程推導的作者設計,並非 NVDLA 現有的私有 manifest 格式。
ConfigROM 提供了可實作的交叉檢查點。官方文件把 sub-unit ID、能力位與部分基準參數編成軟體可讀的描述;若 RTL 生成選了 nv_small,而驅動程式依舊按較大的 atomic size 準備資料,兩邊各自編譯成功仍可能在執行時錯誤。ConfigROM descriptors 與 payloads一個低成本的 release test 是在模擬中讀出 ConfigROM,和 spec 解析後的預期表逐欄比較,再讓軟體測試使用同一份預期能力。這不能取代功能 coverage,卻能及早攔下配置、韌體假設與實際 RTL 互相漂移。若能力描述版本改了,後續 trace 即使名稱相同,也應先確認是否仍在測同一種硬體組態。
這個機制與先前討論的 Arm CSS 子系統整合在工程問題上相接,但公開證據層次不同:CSS 文章處理商用子系統交付邊界;NVDLA 提供可直接檢查的 spec、build target、trace 格式與綜合輸出。兩者不能互相充當對方的實作證據。
第二個機制:把行為模型和可實作 cell 分開
參考 RTL 在功能模擬中可讀寫記憶體,不代表後端已拿到實體可實作的 SRAM。NVDLA 的整合手冊說明,發布包內的 RAM 是 behavioral model;整合者要以相同 port 介面的 wrapper 映射到自己的 memory compiler 產物,並供應對應的 timing model。手冊特別警告不要把 vmod/rams/model 加進綜合的 RTL_SEARCH_PATH,因為它是模擬模型,不是可供該流程綜合的 RAM RTL。
這是 R2G 中很實際的責任切割。IP 團隊可以交付邏輯 RAM 介面及測試模型,製程整合團隊才有能力選擇實際 SRAM、電源控制腳位、保留模式、大小與物理位置。官方文件也指出幾類 clock-domain synchronizer 雖有可綜合 RTL 實作,實際導入時應換成適合目標製程的專用 synchronizer cell。這裡需校正原文的術語:手冊寫「reduce MTBF」,但 MTBF 是平均失效間隔;可靠性目標應是提高 MTBF、降低失效頻率。AMD 的 synchronizer MTBF 文件也明確以增加 settling time、提高 MTBF 為目標。兩種替換都要求功能等價的介面和製程相容的實體 view;只有 RTL module name 對上,不足以驗收 clock crossing 或記憶體讀寫語意。Library Cells 段落
記憶體的讀寫衝突尤其不能粗略處理。NVDLA 手冊區分 true dual-port RAMDP 與以倍頻方式實作的 pseudo-dual-port RAMPDP,並明列同位址讀寫時的行為:前者讀出資料可能毀損,後者在指定的 1R+1W 時序中讀到舊內容。RAM 時序與介面若替換的 SRAM 只有 pin 名稱相同、碰撞語意卻不同,基本 convolution 測試仍可能通過;在罕見的 buffer 衝突或 reset 邊界才出現資料差異。整合平台應把 RAM wrapper 的真實 cell、Liberty view、幾何 view、碰撞模式與對應定向測試綁為一組交付物。
時脈也有同類問題。官方介面文件列出 dla_core_clk 與 dla_csb_clk 為非同步域,並說明主 reset 的 assertion 與 deassertion 處理不同;還另有 DFT reset 與 test mode 腳位。Clock/reset 與 DFT 介面若只在 SDC 中對兩個 clock 宣告 asynchronous,卻沒有核對實際 synchronizer 替換、reset release 及 DFT 模式,綜合報告的 clean timing 不能證明 CDC 安全。假設與實作要在 CDC、DFT、STA 三個驗收域各自留下證據。
分區綜合把交接物具體化
NVDLA 參考流程把 NV_NVDLA_partition_a/c/o/m/p 視為獨立的 synthesis top,再由 top-level wrapper 例化。整合手冊的 Synthesis 段列出 TOP_NAMES、RTL_SEARCH_PATH、CONS、DEF、TARGET_LIB、LINK_LIB、技術檔及 RC 映射的配置欄位。<TOP_NAME>.sdc 要與分區同名;參考 SDC 包含 16 nm 時脈目標與部分 false paths,官方明說整合者必須依目標製程與 corner 調整。若跑 physical synthesis,可另外提供各分區的 RAM/I/O DEF。這一點把「同一份 RTL 在不同製程跑」拆成可列舉的依賴,而非假定 constraint 能原樣沿用。
syn_launch.sh 支援 wireload 與多種 physical synthesis mode,並可從 DDC 恢復某個分區資料庫。它的輸出結構比「綜合成功」有用得多:每個分區可產生 mapped .gv、輸出 .sdc、完整 .def、.ddc、formal 相關 .svf,以及 check_design、check_timing、final timing/QoR report。官方 output tree這些輸出不等價:.gv 表示邏輯實例;.sdc 記錄工具輸出的時序條件;.def 搭載幾何資訊;.svf 可供後續形式驗證流程使用;報告則是對指定 library、corner 和 mode 的分析結果。平台要保存它們的共同輸入身分,才可能在後段調查「為什麼這個 block 今天的 WNS 跟昨天不同」。
公開參考流程甚至留下了實體時脈建構前的折衷:TIGHTEN_CGE 可對 clock-gate enable path 加嚴要求,CGLUT_FILE 則以 fanout 對應額外 latency,目的在綜合階段先考慮 post-CTS 可能付出的延遲。Clock Gate Enable Path Over constraining此處的 lookup table 是一種近似,不是已量測的 clock tree。加嚴太少,後端 CTS 後才發現 gate enable timing 過不去;加嚴太多,又可能讓綜合使用較大或較耗電的 cell,甚至把修不好的假問題傳給 APR。要判斷是否值得啟用,應保存同一分區在相同 RTL、library、SDC 下的兩組綜合結果,並比較後續實際 CTS timing,不能只比較綜合當下的 WNS。
這同時解釋何以約束必須有來源。官方提供的 SDC 是一組參考 clock target 與 false path,而不是設計整合者可不審查就移植的時序真理。Synthesis constraints當 SoC 把 CSB clock 接到新的 host domain,或讓 RAM wrapper 加入額外一拍,原本的時脈假設和跨域驗證都需要重新檢查。合理的交接資料應回答每條例外由哪個設計意圖支持、適用於哪個 mode、哪個 owner 核准;有 check_timing 報告只代表工具已按目前設定分析,並不替這些設定背書。
手冊還公開了一個小但重要的分散式執行接點:COMMAND_PREFIX 可以把每個 TOP_NAMES 的 dc_shell 送到 LSF 或其他 grid,<MODULE> 與 <LOG> 代入對應名稱;沒有 prefix 時分區工作序列執行,使用非阻塞 prefix 才能平行送出。Synthesis Configuration公開資料只證明參考腳本有提交鉤子,沒有揭露 NVIDIA 的內部 queue、license policy 或 artifact store。若要把此介面升級為團隊平台,提交後還需要分區與配置 identity、attempt ID、exit status、license 消耗及產物驗證;這是作者提出的控制層,不應倒寫成 NVIDIA 已部署功能。
分區化降低單次綜合工作大小,也讓不同 block 可局部重跑;代價是跨分區 timing budget 與 top-level 實際線長必須重新閉合。某一分區的 check_timing 沒報錯,不表示跨分區路徑、SoC memory fabric、clock tree 或 top-level IR drop 已通過。公開包提供的是綜合參考流程,沒有公開完整 route、STA corners、DRC/LVS 或 power-integrity signoff 的交付鏈。這個保證邊界必須寫在 release gate 上。手冊的輸入與輸出範圍
從後端接收者視角,合格的 block 交付還應列出工具解析後的 top name、macro black boxes、未受時序約束的路徑、clock gate enable 設定與對上層的 timing budget。這些欄位是作者提出的接收清單,因為官方輸出目錄本身無法表示誰核准了例外、哪些 warning 可以接受。接收方若發現 .gv 的 partition 與 .sdc 的 top 不符,應拒收整個 bundle;若只有 report 缺失,也不該把 netlist 存在當成驗收完成。每一個 gate 都要能回傳可修正的拒收理由,才有可能把局部重跑接成真正可維護的 R2G 流程。
從一個配置走到一份可以交接的 evidence
以 nv_small 加入一個假設 SoC 為例,設計輸入是固定版本的 nv_small.spec、NVDLA RTL、SoC clock/reset 接法、目標 SRAM wrapper 與 library。以下 trace 使用官方真實的 convolution 測試名稱與命令形式;後面的 manifest 則是作者設計的範例,沒有宣稱曾在某製程執行。
release: soc-nvdla-small-r1
config: {name: nv_small, spec_digest: "sha256:<fill>"}
generated: {rtl_tree_digest: "sha256:<fill>", configrom_check: pending}
views: {ram_wrapper: "<approved-id>", liberty: "<approved-id>", sdc: "<approved-id>"}
verification: {trace_plan: nv_small, result_manifest: pending}
synthesis: {tops: [a, c, o, m, p], artifact_manifest: pending}
acceptance: {cdc: pending, lec: pending, top_sta: pending, apr: pending}
先由 tmake 建出 vmod 與 verification environment,再按官方驗證指南執行 run_test.py -P nv_small dc_24x33x55_5x5x55x25_int8_0 -outdir ... -v nvdla_utb。測試的 trace 包含 .cfg 中的 register 操作和 .dat 中的記憶體內容,可用 golden CRC 或 output surface 比對;完成一個 hardware layer 的中斷也能成為同步事件。它的特別之處是同一 trace 格式可重用於 unit RTL、system verification、C model、FPGA validation 和 bring-up,讓各環境對「送了什麼刺激、期待什麼結果」有共同座標。Trace Test format
一個 trace 不只是預填的 output。官方格式裡,mem_load 裝載資料、reg_write 建立暫存器狀態、sync_wait/sync_notify 約束多個 player 的先後,intr_notify 觀察完成中斷,check_crc 或 check_file 才做結果核對;poll 可等待某個硬體狀態達成。Trace configuration commands對多資源 pipeline,順序錯誤可能讓資料尚未準備好就啟動下游單元;如果平台只保存最後的 CRC pass,之後便無法分辨是 register 序列、資料載入還是中斷等待造成差異。因此一筆驗證結果至少要指回 config、trace、data、testbench、DUT RTL 和執行 log 的版本,且保留 timeout 與 checker failure 的分類。
這條路徑還有語意上的死角。CRC 通過是針對所測資料及指定 memory surface 的結果,不能證明未執行功能或跨 SoC 的 coherency、reset recovery 都正確。官方 run_plan.py 能用 test plan、tag 與 run directory 選取 regression,範例包含 -no_lsf 在本機執行,並輸出各 test 的 PASS/RUNNING 狀態;這給了分散式回歸可用的批次入口,卻未公開跨 farm 的可靠採納協定。Verification Suite 的 Quick Start工程平台若平行跑多個 seed,應先定義「worker 回報完成」和「報表可被正式採納」的區別:缺少 trace output、版本漂移或 checker 沒跑到,都不能由零退出碼補救。
但同一 trace 在五種環境都 pass,仍無法替代綜合與實體驗收。接著替五個 TOP_NAMES 提供相容 SDC、RAM wrapper、library 和必要 DEF,跑 syn_launch.sh;交付的每個分區必須有 netlist、約束、資料庫與 reports。check_design、check_timing 和 final report 應跟實際讀入的 RTL/library/SDC 版本綁定,並再由 SoC 層執行 CDC、LEC、STA、APR 和 signoff。這些 SoC 驗收項是作者建議,不是說公開 NVDLA 腳本已替整合者全部完成。參考流程的 synthesis outputs
若用量化算例評估分區併行,假設五個 synthesis partitions 各需 3、4、5、2、6 小時、每個占一張 license;串行 wall time 是 20 小時。若有五張同類 license 且可同時啟動,理想下限是 6 小時,速度上限約 20/6 = 3.33 倍;如果只有兩張 license,排程和分區長短會把完成時間拉高,絕不可能得到五倍。這是明示假設的容量算例,不是 NVIDIA 的實測。實際收益還受記憶體、I/O、工具啟動、license queue 與 top-level 返工影響。它說明 COMMAND_PREFIX 提供執行併行性,卻不會自行產生資源效率與正確性交付。腳本公開支援的串行與非阻塞提交模式
一次 RAM view 錯配會留下什麼
假設整合者更新 SRAM wrapper,使 nv_small 某個 RAM 的碰撞行為或深度映射改變。RTL trace 仍使用 behavioral RAM,於是 simulation pass;綜合則讀到新版 wrapper,但 LINK_LIB 指向舊版 timing model。更糟時,物理流程沿用舊 .def 或 macro 幾何 view。這是由公開介面推演的故障情境,並非 NVDLA 的已知事故。
故障點在跨工具 view 的配對。殘留物可能包括有效的 trace log、已產生但未經新 SRAM view 驗收的 .gv/.ddc、舊的 .sdc/.def、以不一致 library 算出的 timing report,以及等待 top-level 接收的分區包。偵測不能只看工具 exit code;應比較 release manifest 中的 RAM interface、model/Liberty/geometry 識別與實際 resolved files,並跑同位址讀寫與 reset 等定向測試。發現錯配就把相關 partition artifacts 隔離,保留它們以供診斷,禁止進入新的 top-level release。
恢復先選定同一版 RAM family 的功能、時序與物理 view。若只改模擬模型,需重跑受影響的 trace;若 library 改了,受影響分區綜合與後續 timing 要重算;若幾何或 pin location 變了,既有 floorplan/APR checkpoint 也不能直接沿用。最後重新核對跨分區 timing budget 和 SoC 層連接。保證只到受影響依賴被重跑且各 gate 通過為止;內容 hash 能抓出漂移,不能單獨證明 RAM 行為或 signoff 規則正確。
兩條合理路線的取捨
| 方法 | 計算與授權成本 | 回饋延遲 | 正確性邊界 | 維護與整合代價 |
|---|---|---|---|---|
| 每次全部重建 RTL、trace 與五分區綜合 | 較高;重複跑未變更分區 | 常受最慢工具與 license queue 影響 | 流程較容易理解,但仍需核對跨 view 相容性 | 腳本簡單;大型 SoC 會浪費資源 |
| 以配置與 view 依賴做增量重跑 | 能跳過不受影響工作;需保存 artifact 與索引 | 小變更較快,錯判依賴時可能返工 | 必須證明 cache 命中條件,特別是 SDC、RAM 與 tool mode | 需要版本化圖譜、失效規則、隔離與審核 |
在五個分區、少量變更時,先用完整重建建立 baseline 是合理的。當組態、SRAM 家族或下游 corner 增多,再增加依賴索引;索引須以實際 tool inputs 而非檔名推斷。例如改了某分區的 SDC,不可重用其舊 check_timing,但未受影響分區的功能 trace 可能不必重跑。改了 spec,則連 ConfigROM、RTL 與驗證計畫的共同身分都要重看。
增量策略最難的是處理「工具輸入沒變、解讀方式變了」。若有人更動 waiver 規則或提高驗收門檻,原始 netlist 也許可以保留,但舊的放行決策必須失效;若換的是綜合工具版本或隱含預設選項,依賴圖應保守地重算受影響分區。平台可以允許人工批准例外,但每次例外都要記錄理由與到期條件,避免暫時繞過檢查的做法變成永久設計事實。
AI 或 agent 在這裡能做的事也應受此邊界約束。作者建議讓 agent 讀取已封存的 check_design、check_timing 與 trace failure,產生下一步診斷或重跑建議;真正的修改只允許在已核准的 config、SDC 或 wrapper 分支上進行,並由對應 owner 審查 timing exception、CDC waiver 和 signoff 判定。Agent 不應因看到一個 false path warning,就自行刪掉路徑或把 failing trace 換成不再觸發的 stimulus。公開 NVDLA 文件沒有宣稱這套 agent,這是可做 shadow-mode 實驗的作者方案。
未來 6–18 個月,最值得借鏡的是三個具體能力。第一,讓配置版本直接索引生成 RTL、ConfigROM 預期與 trace plan。第二,為每個綜合分區保存 resolved inputs、.gv/.sdc/.def/.ddc/.svf 與 reports,並明確標示 top-level 尚未驗收的項目。第三,針對 SRAM、CDC、SDC 變更建立保守失效規則,先求「不錯用舊證據」,再追求增量重跑速度。
不碰 PDK 的最小驗證可以用公開 nv_small 的 config 與 trace metadata 做一個小型 dependency checker,或在簡化 FIFO IP 上模擬同一交接形狀:準備兩個配置、兩份 SRAM 行為模型、兩份假設 SDC,為每個 artifact 記錄輸入 digest;故意只改 RAM collision rule,再檢查系統是否拒收舊 trace 與舊分區 report。成功標準是受影響結果全部被標為 stale,無關結果仍可重用,且審查者能從 manifest 找到原因。這項實驗的驗收對象是平台的失效判定。
NVDLA 提供一段可檢查輸入、輸出與責任交界的公開 R2G 入口。下一個值得追的工程問題是:五個綜合分區進入同一顆 SoC 後,跨 block SDC、clock/reset 和 SRAM 物理 view 如何在 APR/signoff 前重新形成一致的驗收契約。
參考資料
- Open NVDLA Repository Updates — NVIDIA/NVDLA,2017 年 9 月 25 日首次釋出;2018 年 4 月 19 日公布可配置 v2 與當時驗證限制。
- NVDLA Integrator’s Manual, v2 — NVIDIA/NVDLA,v2 文件,隨 2018 年可配置版本;SoC 介面、RAM/synchronizer 替換、綜合配置及產物。
- NVDLA Environment Setup Guide, v2 — NVIDIA/NVDLA,v2 文件,隨 2018 年可配置版本;
tree.make、tmakebuild targets 與 generated tree。 - Scalability parameters and ConfigROM — NVIDIA/NVDLA,v2 文件,隨 2018 年可配置版本;組態參數、能力描述與
nv_small驗證程度。 - NVDLA Verification Suite User Guide, v2 — NVIDIA/NVDLA,v2 文件,隨 2018 年可配置版本;trace 格式、test plan、single test 與 regression。
-
nvdla/hw — NVIDIA/NVDLA 官方原始碼,2017 年起發布;RTL、spec、verification、synthesis scripts 與 performance model。
- report_synchronizer_mtbf — Vivado Design Suite Tcl Command Reference Guide, UG835 — AMD, 2026.1;用於核對 MTBF 定義與改善方向。