
Arm CSS N4 的整合基線:IP 重用如何保留客製晶片的正確性
預先整合的 IP 子系統能縮短客製晶片的起跑距離,前提是修改後仍保有可驗收的整合基線。Arm Neoverse CSS N4 值得研究的地方,是如何交付一組已搭配的 RTL、系統 IP、參考軟體與實作指引,同時保留配置及加入加速器的空間。Arm CSS N4 交付範圍
SoC 整合的成本來自多個相互依賴的界面:CPU、記憶體與 I/O 不只需要接線正確,還要共同遵守位址、ordering、clock/reset、power 及軟體可見狀態。單一 IP 的驗證結果,只有在原有假設成立時才能重用;增加 DMA、換 SRAM 或改 clock ratio,都可能越過這個邊界。
因此,平台的價值要由「哪些工作不必重做,哪些改動必須重新驗證」判斷。以下從版本與環境固定,走到一條 DMA 資料路徑,再追到 RTL-to-GDS handoff。要帶回設計團隊的是能辨認相依失效的交付契約,而非把所有配置都選到最大。
圖中綠框是一組可重用的整合基線,旁邊的客製加速器卻會透過 DMA 加入新的記憶體流量。先把修改跨過的邊界畫出來,才能追問原有位址、ordering、clock/reset 與驗證條件是否仍成立;預先整合的價值也建立在這些假設上。
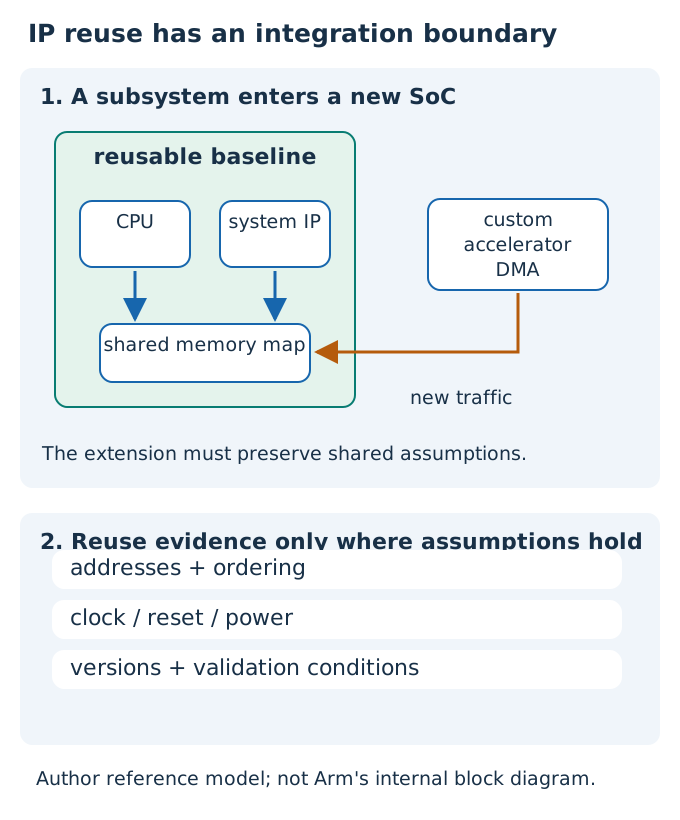
圖:作者提出的 SoC 整合參考情境,非 Arm 官方內部架構。交付範圍依據:Arm Neoverse CSS N4。
CSS N4 交付的是整合起點:RTL、系統 IP 與參考軟體
Arm 的產品文件寫得很具體:CSS N4 以 RTL 交付,包含預先整合的系統 IP、軟體及參考設計,另有實作指南、第三方 IP 互通支援,以及可啟動 Linux 的整合軟體堆疊。每個 die 可配置 8–128 個核心,並支援 LPDDR6、PCIe Gen 7 等選項。這裡的重點不是把規格全部選到最大,而是每個選項都必須對應一組能共同工作的交付物。CSS N4 官方產品與交付範圍
Arm Total Design 則是另一層:它把 CSS、第三方 IP、EDA、設計服務、晶圓代工及韌體支援組成合作生態系。這不是一套點一下就能生成晶片的 CAD 軟體,也不等於所有合作夥伴的 IP 都可以任意混搭。整合前要確認的是特定子系統版本、配置、製程與工具組合,有哪些相容性已被驗證、哪些仍由整合團隊負責。Arm Total Design
可核對的實際設計案例,是 Synopsys 在 2026 年 3 月 24 日公開的 Arm AGI CPU 合作。該晶片基於 CSS V3,不是 CSS N4;公開工具包含 VCS、Fusion Compiler、PrimeTime、IC Validator、RedHawk-SC,並涉及介面 IP、ZeBu、HAPS 等驗證與原型資源。因此,N4 告訴我們最新平台交付方向,AGI CPU 則提供已公開的 V3 設計工具鏈案例;不能把兩者拼成一個已證實的 N4 tapeout 流程。AGI CPU 設計與驗證案例
環境設定先固定設計版本,才固定執行工具
一個可接手的設計環境,不只是把 simulator 和 APR executable 放進 PATH。我會把專案環境拆成兩份相互對應的清單:一份記錄「設計由什麼組成」,另一份記錄「用什麼條件解讀與驗證它」。前者包含 CSS 配置、客製 RTL、IP release、記憶體巨集與產生器版本;後者包含工具版本、製程與 library 組合、SDC、UPF、操作模式及驗證範圍。
下面是建議的專案契約,不是 Arm 的私有設定檔。欄位刻意指向已核准且不可任意漂移的 release,而不是在文章中虛構商用工具或 PDK 版本。
# 參考設計:實際版本與清單由授權交付物填入
project: datacenter-offload-soc
soc_revision: integration-r3
compute:
  delivery: licensed-css-release
  configuration: config/compute.json
ip_manifest: manifests/ip-releases.lock.json
environment_manifest: manifests/eda-environment.lock.json
constraints:
  timing: constraints/top.sdc
  power: constraints/top.upf
views:
  simulation: manifests/simulation.files
  synthesis: manifests/synthesis.files
  physical: manifests/physical-views.json
validation:
  functional: tests/system-smoke.yaml
  implementation: checks/release-gates.yaml
這份契約的作用是讓「同一份設計」有可判定的範圍。整合工具產生的 top-level RTL、register model 與檔案清單,要記錄來自哪個配置;跑後端時還要補上實際解析到的路徑與內容識別。檔名相同但內容換了,不應悄悄沿用舊驗證結果;反過來,只有文件變動,也不該讓所有昂貴的實體工作失效。
軟體端有一個可直接參考的公開做法。Arm 的 Neoverse Reference Design 文件提供由 manifest 選定軟體 release 的環境,支援 host-based 與 Docker-based build。文件以 Ubuntu 22.04 驗證,建議 48 GB RAM、至少 32 GB,並保留 64 GB 磁碟空間;container wrapper 會處理 host 與 container 的使用者身分、工作路徑對應。這些是參考設計軟體建置的條件,不是 CSS N4 全晶片 APR 的硬體需求。官方 Getting Started
依官方步驟完成 manifest 同步、安裝 Docker 後,既有 workspace 可用下列入口建立環境;WORKSPACE 必須是自己的絕對路徑,且不要以 root 執行 wrapper。
# 僅供 Arm 公開 reference-design 軟體環境
: "${WORKSPACE:?請先設定已同步 workspace 的絕對路徑}"
cd "$WORKSPACE/container-scripts"
./container.sh build
./container.sh -v "$WORKSPACE" run
更有參考價值的是版本配對。公開 RD-V3 文件把 RD-INFRA-2025.07.03 與 FVP 11.29.35 配成一組。這是有日期的既有參考版本,不是 2026 年 N4 的最新設計套件;FVP 也不是 RTL simulation 或 timing model。它能讓團隊先理解 boot、firmware 與作業系統如何接上平台,不能用來證明新增 RTL 正確或某個時脈能夠 signoff。RD-V3 平台與 release 對照
商用硬體環境則應另行取得授權 CSS、IP 與製程交付資料,核對支援的 OS/EDA 組合、license 存取、檔案權限及儲存需求。公開資料沒有完整揭露 N4 的安裝清單與 flow scripts,因此不能聲稱上面幾行命令可以跑完 N4 的 R2G。可移植的做法是「版本成組、路徑一致、輸出隔離」,不是把軟體 Docker image 直接當作晶片設計環境。
IP 整合要同步的是設計語意,不只有 top-level 連線
以一顆資料中心資料搬移 SoC 為例:運算子系統負責控制軟體,自研 DMA/資料處理加速器負責資料面,外接記憶體與 PCIe 介面。這是用來分析交接的假設設計,並非 AGI CPU 或某顆 N4 客戶晶片的公開配置。
整合時,我會先固定三種關係。第一是位址與權限:CPU 看見的 MMIO window、DMA 可到達的記憶體、裝置身分及中斷路由。第二是交易語意:資料寬度、傳輸順序、coherency、backpressure 與 outstanding 上限。第三是生命週期:哪些 clock/reset/power domain 能獨立停止,停止前必須清空哪些交易。
這些條件必須同時反映在 RTL、驗證模型及軟體描述。硬體 decode 已經改址,但 firmware 仍使用舊 register map,模擬與實機可能呈現完全不同的故障;若只在最上層手接 port,工具不會自動知道這幾份描述其實應該一起更新。
Arteris 在 2025 年的技術材料提供了具體對照:Magillem Packaging 可以由 HDL 檔案清單或目錄建立 IP-XACT 描述,並區分 simulation、synthesis、emulation、verification 的 FileSets。這說明「IP 包裝」可以是正式的機器可讀介面;但沒有公開證據顯示 Arm AGI CPU 或 CSS N4 使用了這套 Arteris 工具,這裡引用的是可借鏡的整合方法。Arteris IP packaging 技術說明
我要的整合結果會是一份可以重建的 release:配置與 IP metadata 產生 top-level、檔案清單、register 定義及驗證骨架;人工負責無法從介面推得的設計意圖。尤其 SDC 不能僅由 RTL 猜完:哪兩個 clock 可以同步分析、哪種模式下某條路徑不會啟動,必須有設計與使用情境的依據。產生器可以檢查名稱及引用是否一致,不能憑空創造正確的 timing exception。
這個假設設計還有一個容易忽略的接點:邏輯上相連的元件,不一定能放在相同的時脈與供電條件。假設控制 CPU 的區域持續供電,加速器可以獨立停機;那麼 power-off 流程就必須先停止接收新工作、確認在途交易的處置,再處理跨邊界訊號。恢復時,軟體也需要知道 queue 是被保留、已清空,還是仍有一筆工作狀態不確定。這些是案例必須定義的需求,不能從 IP 的 port 名稱自動推出。
因此,我會讓 clock/reset/power 的整合表成為 release 的一部分:每個介面列出來源與目的 domain、允許的運作模式、跨域機制及驗證 owner。若 pipeline 或 clock ratio 改變,除了生成新 RTL,還要明確檢查原本的吞吐量承諾、reset 測試和 timing budget 是否仍成立。工具可以協助同步描述,但「停機是否允許丟失一筆交易」這種產品語意,必須先由設計者決定。
用一條 DMA 資料路徑,檢查整合是否真的成立
具體驗證可以從一筆工作開始:CPU 配置 descriptor,寫入 doorbell;DMA 取得輸入資料,完成處理後更新結果與完成狀態,最後以中斷通知 CPU。沿著這條路徑,必須追蹤的不是「AXI 接上了沒有」,而是每一端看到的位址、資料版本與完成順序是否一致。
Linux DMA 文件區分 CPU virtual address、physical address 與 device DMA address;有 IOMMU 時,裝置使用的位址不一定等於實體位址。另外,coherent memory 並不免除 memory barrier;streaming DMA 的 buffer ownership 轉移也可能需要同步。這些都是硬體整合契約會直接影響軟體正確性的接點。Linux DMA mapping guide
假設 CPU 把 descriptor 的 valid bit 先讓裝置看見,地址欄位卻尚未對裝置可見,DMA 就可能讀錯位置。測試不能只驗證記憶體最後有資料,還要刻意改變延遲、cache 狀態、交易重疊與 reset 時刻。對這個假設案例,我會要求 scoreboard 比對輸入、目的位址、資料、完成次數;遇到逾時則保留最後一筆被接受的交易,而不是一律把整顆 SoC 重開當作通過。
效能也要從這條路徑算,而不是由 CPU 核心數倒推。假設資料通道每 cycle 最多接受一拍、寬度 256 bit、時脈 1 GHz,理論單向頻寬是 256 ÷ 8 × 10⁹ = 32 GB/s。若有效傳輸比例只有 70%,就是 22.4 GB/s。這是示範算例,不是 Arm 的量測。
再假設一次讀取的往返延遲為 120 ns,要維持 22.4 GB/s,系統平均至少需要約 22.4 GB/s × 120 ns = 2,688 bytes 的讀取資料在途;若每個 outstanding request 對應 64 bytes,理想下限是 42 筆。實際仍需考慮延遲分布、仲裁、credits 與回應緩衝。若入口最多只能維持 16 筆,單憑這個延遲條件,其上限約為 16 × 64 B ÷ 120 ns = 8.53 GB/s。
這個估算會改變 IP 配置與 R2G。增加 outstanding 可能需要更深的 queue、更多 tracking logic 與 SRAM;加寬 bus 會增加走線需求;插入 pipeline 有助 timing,卻增加在途資料與驗證狀態。架構、IP 選項和後端代價必須放在同一輪比較,否則前端交出去的是頻寬需求,後端收到的只是突然膨脹的面積與壅塞。
從已整合 RTL 交給 R2G,交付物必須包含假設
Synopsys 對 Fusion Compiler 的公開說明,是以統一 RTL-to-GDSII 引擎及整合資料模型串接邏輯與實體最佳化。這有助減少流程階段間不一致的設計表示,但工具不會替專案決定正確的功能、時脈與供電需求。Fusion Compiler 技術定位
因此,R2G 入口不能只接受一份 netlist 和一句「請做到 1 GHz」。至少要有同一個 release 的 RTL/IP views、top configuration、已核准 SDC/UPF、操作模式、library 與 RC corner 組合、DFT 假設,以及可追溯的前端驗證結果。這裡列的是參考交接要求,不是聲稱 Arm 公開了相同的內部 checklist。
我會把後端拆成三個可以看見輸入、輸出與退回理由的接點。第一個是 synthesis handoff:elaboration 是否完整、哪些 black box 是明確允許的、clock 與 I/O 約束有沒有覆蓋目標範圍、synthesis 後的等價性檢查在什麼假設下成立。缺了記憶體模型時,不能把「工具沒報 fatal」當成設計完整。
第二個是實體整合:floorplan 要容納 CPU、cache、DDR/PCIe PHY 等位置限制及供電路徑;placement、CTS、routing 會把線長、buffer、時脈分配與寄生效應帶回結果。採階層式實作時,block 的 timing model、介面 budget 與頂層位置假設要對得上;flatten 後可以取得更多跨界最佳化自由度,但也會削弱分工及局部重跑的便利。
第三個是 release/signoff。AGI CPU 公開案例中的 PrimeTime、IC Validator 與 RedHawk-SC,分別提供時序、實體驗證及電源完整性等分析能力;這些不同維度不應壓成同一個「pass」。最終判定還取決於選定的 corner、規則、activity、模型與 waiver。GDS 已匯出,只代表產物存在,不代表所有 release 條件都已成立。AGI CPU 公開工具範圍
一次 SRAM 換版,足以暴露整合平台的可靠性
假設 SRAM 供應商更新交付版本,模擬模型已更新,後端卻仍讀到舊的 LEF 或 timing library。只檢查檔案存在及 module 名稱,可能攔不住這種錯配;各階段甚至都能完成,但證明的是不同版本的設計。這是失效情境推演,不是 Arm 的已知事故。
我的處理方式是先在 IP manifest 內列出每一種必需 view 的 release ID、內容識別與相容關係,再讓 simulator、synthesis、APR、STA 各自回報「實際載入了什麼」。檢查要比較宣告與解析結果,而不是相信某個環境變數。內容 hash 只能辨認位元是否改變,無法證明 view 在語意上相容;後者仍要靠供應商交付規格與一致性檢查。
錯配被發現後,舊的實作與分析結果應標成不能用於新 release,而不是直接刪除,否則失去比較依據。恢復流程先建立相容的 view 組合,再從依賴受影響之處重跑:只有 timing library 變動,不一定需要重建所有軟體;macro 幾何或 pin 變動,則不能只重跑 STA。是否重用 checkpoint,要由變更語意及工具支援決定,不是看到 hash 一樣就保證結果可重播。
同樣道理也適用於 reset。DMA 在送出部分寫入後被重設,重新送出整筆工作是否安全,取決於目的端是否允許重複副作用。平台至少要能留下已接受交易、錯誤回應和復原狀態,讓驗證團隊判斷這是可重試、需要清理,還是必須向軟體回報失敗。把所有 failure 都變成自動 rerun,可能只是讓錯誤更難重現。
AI 的位置,是探索已定義的自由度
「這顆 SoC 服務 AI 工作負載」和「設計流程使用 AI」是兩件事。公開 CSS N4 說明不能直接證明 Arm 用了某種 agent 來完成整合。可核對的工具能力是 Synopsys DSO.ai:以 reinforcement learning 探索設計流程選項,支援 PPA 多目標最佳化,並與 Fusion Compiler、IC Compiler II 等工具配合;這不是 AGI CPU 已採用它的證據。DSO.ai 官方說明
放到前面的 DMA SoC,我會先讓搜尋只改一組明確的自由度,例如 queue depth、pipeline 配置或一段實體最佳化 recipe,固定其他版本及驗收條件。涉及功能的 RTL 改動,必須重新通過相應驗證;不能拿工具參數搜尋的成功,推論任意重寫 RTL 一樣安全。目標函數也不能只有面積或 WNS,還要保留吞吐量、尾端延遲、功耗估計與資源成本,避免拿功能退化換漂亮 PPA。
兩種平台路線各有合理場景。由分散 IP 自行整合,自由度最高,也最能配合特殊架構,但版本協調與系統驗證都由自己承擔。以 CSS 為已整合的運算基礎,可以把精力集中到自研資料面與外部介面,但必須接受它的配置及交付邊界。若直接使用完成的 CPU 晶片,會再減少硬體設計責任,代價則是不能把差異化邏輯任意放進同一顆 die。這三條路線的選擇,取決於差異化價值究竟位於微架構、SoC 整合還是系統軟體,而不是哪個平台名稱更新。Arm 對 CSS N4 與 AGI CPU 的路線區分
最值得帶回設計團隊的,是可以驗收的整合基線
比較實際的起步,是挑一條有代表性的 IP 整合路徑,把交付做完整,先不急著複製一套大型平台介面:固定一組版本,產生 top-level 與軟體描述,跑通控制及資料交易,再交接到一個可驗證的實體分區。沒有商用套件時,可先用公開 reference-design 軟體理解 boot 與平台契約,另用開源 RTL 小案例驗證 IP metadata 與 R2G 交接;兩種實驗的證據不要混在一起。
驗收可以比較三個量:新工程師從乾淨環境到首次有效驗證的時間;一次 IP 換版後,找出不相容交付物需要多久;相同 workload 與設計條件下,後端結果及重跑成本是否穩定。先刻意注入一次 register map 漂移、一次 SRAM view 錯配,確認流程能在昂貴階段前擋下,再談更大規模的 AI 探索。這是建議的驗證計畫,並非本文已完成的晶片實驗。
未來六到十八個月,我會優先觀察三件事:子系統供應商是否交付更完整的配置與相容性證據;IP 整合工具是否能讓 RTL、軟體與驗證資料同步變更;AI 最佳化是否能把探索結果接回可重現的 R2G 基線。Arm 的最新 CSS 與既有完整晶片案例,讓這幾個接點有了具體研究對象。能借鏡的平台能力,是讓下一個產品少重做哪些工程,以及出現變更時,還能清楚知道哪些結果值得信任。
參考資料
- Arm 以 AGI CPU 與 Neoverse CSS N4 擴展代理式 AI 時代的 AI 基礎架構 — Arm,2026 年 9 月 8 日。
- Arm Neoverse CSS N4:產品、可配置項與交付範圍 — Arm 官方產品文件,2026 年 9 月查閱。
- Arm Total Design — Arm 官方生態系說明,2026 年 9 月查閱。
- Synopsys Supports New Arm AGI CPU with Full-Stack Design Solutions — Synopsys,2026 年 3 月 24 日。
- Neoverse Reference Design:Getting Started — Arm 公開軟體環境指南;文中使用其現行文件條件,不代表 N4 硬體實作環境。
- RD-V3 Platform — Arm;文中採用表列的 RD-INFRA-2025.07.03/FVP 11.29.35 參考配對。
- Design & Reuse: Efficient IP Packaging for Today’s SoC Integration — Arteris,2025 年 9 月 17 日。
- Dynamic DMA Mapping Guide — Linux Kernel 官方文件,2026 年 9 月查閱。
- Fusion Compiler: RTL-to-GDSII Design Solution — Synopsys 官方產品文件,2026 年 9 月查閱。
- DSO.ai: AI-Driven Design Applications — Synopsys 官方產品文件,2026 年 9 月查閱。