
AI 驗證閉環的兩份契約:高通案例中的刺激探索與結果驗收
AI 用於晶片驗證的價值,在於更有效地找到尚未被檢查的行為,同時維持原有驗收條件。模型可以提出下一組刺激,卻不能靠改掉 coverage 分母或 assertion,讓同一個設計看起來更接近完成。探索權與驗收權需要分開。
晶片驗證是在龐大的狀態及輸入空間中累積證據。Constrained-random tests、coverage 與 assertions 各自縮小不確定性;當剩下的 coverage holes 難以命中,單純增加 jobs 可能付出很多資源,卻沒有增加同樣多的信心。這正是 AI 指向刺激生成與診斷的研究動機,也使實驗版本與可重現性更加重要。
高通公開的 FunCovr.ai 會議材料與 AWS/Bedrock 使用方向,分別提供驗證問題與平台整合線索;它們並未證實兩者已接成同一套系統。以下以公開內容及明示的參考設計,追蹤刺激、simulation、coverage evidence 與非同步重試,判斷什麼條件下這個閉環值得採用。
沿圖中的迴路看一次 stimulus 如何進入 simulator、產生 coverage,再影響下一次嘗試。下方另外保留 assertions 與 coverage model 的驗收邊界:搜尋可以改變嘗試順序,不能自行改變何謂通過。這是理解 AI 驗證平台的起點。
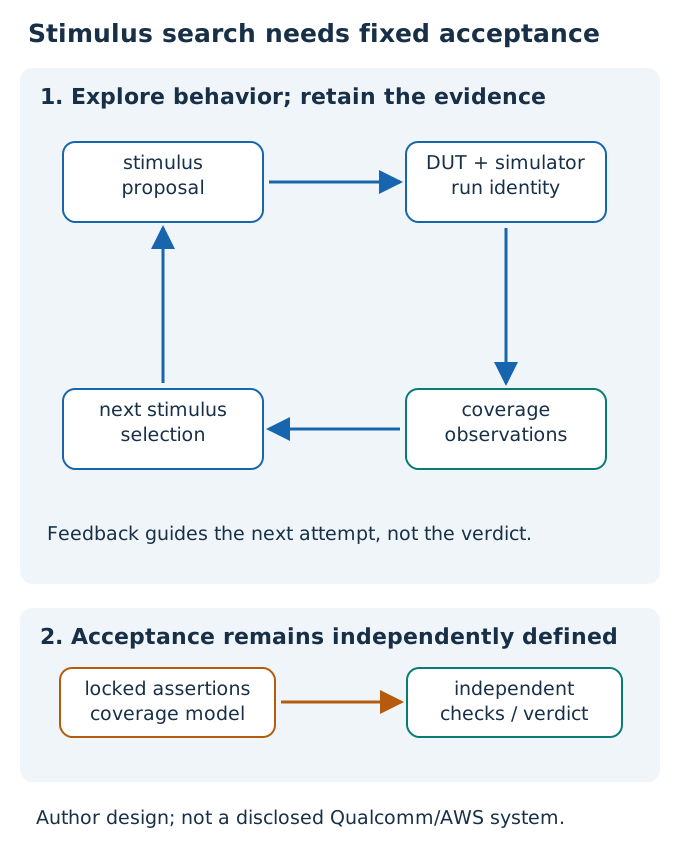
圖:作者設計的驗證參考迴路,非已公開證實的 Qualcomm/AWS 整合系統。問題線索:DVCon India 2026 Selected Papers。
三種證據,回答的是不同問題
理解這條演進路徑,必須把新計畫、研究分享與既有實測分開。
| 公開材料 | 可以確認 | 不能據此確認 |
|---|---|---|
| 2026 年 9 月高通/AWS 公告 | 將深化包括 Bedrock 在內的 AWS AI 基礎設施於 EDA 的使用 | 指定模型、完整部署拓樸、各階段自動化程度 |
| DVCon India 2026 的 FunCovr.ai | 高通團隊提出以 AI 對準驗證缺口的工作 | LLM/RL 的具體分工、可重現資料、全公司部署規模 |
| Synopsys 公開的高通 VCS ICO 案例,2023 | 特定 GPU 驗證專案已有以 AI 改善回歸與覆蓋率的結果 | 這些成果來自 Bedrock,或代表 2026 年所有設計的效益 |
表中前兩列依據上述原始資料;第三列來自 Synopsys 的高通驗證案例。
2023 年案例提供了一個重要基準。VCS Intelligent Coverage Optimization(ICO)使用強化學習,高通比較了有無 ICO 的驗證結果;其中 Project C 報告每個 block 的 grid usage 減少 10–15%。另有工程師描述某個 block 的功能覆蓋率收斂提前約 1.5 週。這是不同條件下的個案結果,不是所有晶片的保證,更不能把兩個數字相乘成平台總效益。VCS ICO 案例與條件
這裡值得延伸的工程判斷,是讓「跑過的結果」改變「接下來跑什麼」。Bedrock 的公告則把模型服務帶入 EDA 的方向說得更明確。兩條線要接起來,仍需要一層理解驗證語意、執行成本與權限的應用系統。
覆蓋率最後一段,缺的往往是有效探索
考慮一個假設情境:GPU 的請求佇列需要在高占用、下游 backpressure,以及重置釋放後第一筆交易等條件下保持正確。單獨覆蓋「佇列滿」和「曾經重置」,不代表已測到兩者在特定順序下交互作用。
若某個合法情境在一輪測試中出現的機率是 p,並且各輪可近似獨立,跑 N 輪至少命中一次的機率是 1 − (1 − p)^N。假設 p 為萬分之一,跑一千輪只有約 9.5% 的命中機會;即使跑一萬輪,也只有約 63.2%。這是用明示假設計算的例子,不是高通量測值。真實回歸的測試彼此可能相關,因此不能直接套用這組機率。
增加算力只能增加 N;修改刺激策略才可能改變 p。但提高某個角落的命中率,又可能把其他角落擠出測試預算。好的探索器必須同時回答:目前缺什麼證據、有哪些合法手段接近它,以及要保留多少多樣性,避免整輪測試過度偏向單一情境。
FunCovr.ai 第一作者描述的「動態對準驗證不足邏輯」正落在這個問題上。不過,該分享沒有說明它如何表示狀態、生成刺激或處理探索與利用的取捨,因此不能替它補上一個未公開的強化學習或 LLM 演算法。FunCovr.ai 公開說明
對平台設計而言,一個可實作的起點是保存每輪命中的 coverage bins、刺激參數、seed、RTL/testbench 版本、耗時及失敗指紋。先用這些資料辨識沒有新增證據的重複測試,再考慮用模型提出新候選。不是所有探索問題都需要生成式模型。
第一個邊界:AI 可以改刺激,不能偷偷改題目
假設已核准的 coverage model 定義了一組 bins,測試集合的價值應看新增了哪些有效命中,而不是將各次執行的百分比直接平均。多個測試反覆命中同一組 bins,聯集可能幾乎不變;大量 run 成功退出,也可能只表示重複完成了容易的情境。
參考設計可以將候選測試的優先分數寫成:預期新增的重要 bins 權重 ÷ 預期執行成本。權重由驗證計畫決定,分母可採 CPU-hour 或 license-hour;另保留探索預算給目前模型不看好的候選。這只是可檢驗的排程策略,不是對 FunCovr.ai 或 VCS ICO 內部實作的描述。
最危險的捷徑,是讓同一個探索器修改「什麼算命中」。例如刪除難以觸發的 bins、放寬 assertion,或把 timeout 改成通過,分數都會上升,證據卻反而變少。所以驗證規格、coverage model、assertions 與 waiver 必須屬於獨立版本;一般探索只能改被核准的刺激參數。模型可以提出規格修訂,但那是另一條需要審核的工作,不是一次 optimization action。
即使 coverage 達到 100%,結論仍只對既定的 coverage model 成立。未被定義的行為不會因分母填滿就自動獲得驗證;錯誤的 checker 也能持續輸出一致的錯誤答案。因此還需要規格對照、assertions、scoreboard,以及適用時的 formal 分析。不同證據互補,不能由一個 coverage 百分比替代。
資料介面可以參考 Accellera 的 UCIS:它為跨工具的 coverage 資料建模與存取提供共同介面。這有助於收集證據,但 UCIS 本身不替專案定義「哪些行為應該驗證」;平台仍要保留 testplan 與 coverage model 的關聯和版本。Accellera UCIS
第二個邊界:模型回應,不等於 EDA 工作已執行
高通公告只指向 Bedrock 的使用方向。若要理解可能的接法,AWS 已有一個可直接檢查的機制:Bedrock Agents 的 action group 能使用 RETURN_CONTROL,將待執行動作與參數交回呼叫端。回應帶有 invocationInputs 與 invocationId;應用程式自行執行後,再帶著對應識別資訊回傳結果。AWS Return control 文件
這項介面的意義,是可以把「提議做什麼」與「真正執行什麼」分開。它不表示高通已採用此模式,也不表示 Bedrock 自動提供 EDA 作業恢復、license 管理或跨工具驗收。
在參考架構中,模型只取得經授權的設計摘要、缺口與候選動作,例如讀取 coverage 差異、提出刺激參數、要求啟動回歸。應用層先解析工具與參數,再檢查專案權限、可寫入範圍、預算及版本;通過後才建立不可變的執行請求,交給既有計算環境。
大型報告與 waveform 不必全部塞進模型上下文。可保留在受控儲存,回傳帶版本的摘要與 artifact ID,讓工具按需取得細節。但摘要不能抹除單位、corner、被排除的條件或錯誤狀態;否則節省 token 的同時,也移除了判斷所需要的前提。
同樣地,模型服務具備資安功能,不代表所有 EDA 資料都適合送入其中。RTL、工具授權、第三方 IP、製程資料與客戶資料各有不同限制。資料出口要由明確分類與存取政策決定,而非讓 agent 在 prompt 裡自行判斷哪些資訊敏感。這是接入設計要求,不是高通未公開的部署細節。
把一次測試變成有身分的工程實驗
模型呼叫通常可以很快得到回應,但回歸可能排隊,再執行很久。把整個過程壓成一個同步 tool call,會讓網路 timeout、排程 timeout 與測試失敗混成同一種錯誤。
較合理的介面是先接受工作並回傳 run_id,之後分別查詢狀態與取得結果。一次實驗的身分不能只有名稱或目前路徑,而應固定輸入快照、參數、工具環境與驗收規則。下面是作者提出的最小 RunSpec,雜湊以短代號示意,不是高通格式或商用工具的原生 API。
run_id: fifo-reset-bp-0042
request_key: campaign-A-candidate-17
inputs:
  rtl_digest: rtl-v7
  testbench_digest: tb-v4
  coverage_digest: cov-v3
  assertion_digest: sva-v2
  toolchain_digest: simulator-build-config-v5
stimulus:
  scenario: reset_release_then_backpressure
  seeds: [17, 41, 93]
limits:
  max_cpu_hours: 12
  max_parallel_jobs: 3
acceptance:
  require_matching_input_digests: true
  require_complete_artifact_manifest: true
  classify_assertion_failures: true
  allow_coverage_model_edit: false
這裡 request_key 是避免同一個提交要求被重複執行的識別,run_id 對應已建立的實驗。刻意增加另一組 seed 是新實驗,不能因 RTL 相同就被去重。輸入雜湊也不等於結果必然可重現;工具版本、選項、依賴、執行環境與可能的非決定性都要納入考量。
同樣重要的是,「可採信的實驗結果」不等於「設計通過」。一份帶完整輸入身分與反例的 assertion failure,可能是最有價值的驗證成果;一份 exit code 為零、卻缺失 coverage database 的報告,反而不應進入統計。平台應分開 execution_status、artifact_integrity 與 design_verdict,不能只有一個綠燈。
用一個 FIFO,檢驗閉環到底懂不懂設計
以下是可自行重現的假設案例,不是高通的實際 GPU 模組。建立一個小型同步 FIFO:正常操作時不得遺失或重排已接受資料;同步 reset 被取樣後清空佇列,reset 前尚未輸出的資料依規格丟棄;下游未 ready 時,輸出端必須維持有效資料穩定。
固定這些規格後,先做一般 constrained-random 測試,將「reset 釋放後接受第一筆資料、接著持續 backpressure、最後恢復輸出」定義為一條時序 coverage 目標。若一直未命中,探索器可以提出在 reset 後增加輸入交易、延長下游 stall 的候選參數,但不能更改 reset 語意或資料比對器。
平台接到候選後,確認它仍在合法參數範圍,建立 RunSpec,執行原始 RTL/testbench 快照。Scoreboard 在每次 reset 清空參考佇列;在有效握手時分別加入與取出資料。Checker 同時檢查 stall 時資料穩定性,coverage collector 則記錄完整事件順序,而非僅確認幾個事件曾各自出現。
接著故意植入一個錯誤:reset 釋放後,FIFO 的第一次 stall 意外前進讀取指標。新的刺激可能一方面命中目標 coverage,另一方面觸發資料遺失。這時應保存反例、保留失敗指紋,讓工程師修 RTL;不能為了讓測試轉綠去修改 scoreboard。
修正後以新 RTL 版本重跑相同 seed,再加入未參與調整的 seed 與原有回歸。如此才可區分「記住某個測試」與「行為確實被修正」。若測試逾時、輸入快照不符或波形不完整,則標成實驗不完整,不能視為沒有 bug。這個小例子已足以測出 AI、執行平台與驗證規則之間的責任是否清楚。
提交逾時後的重試:重複執行、輸出覆寫與版本混用
假設提交端已把工作交給 scheduler,但回覆在網路上遺失。模型看到 timeout 後再次提交,兩個 worker 就可能同時跑同一候選,覆寫同一目錄,甚至在一份輸出尚未完成時,被另一個程序拿去計算 coverage。
因此我會把「提交去重」放在執行 adapter,而不是請模型記住不要重試。Adapter 在持久化登錄表中保留 request key、run ID 與 scheduler job ID;重複請求先查既有工作。若 scheduler 不支援冪等提交,而系統又在送出後、記錄 job ID 前崩潰,就存在無法單靠本地資料庫消除的模糊窗口。此時應先依外部標記對帳;無法判定就保留待確認狀態,不宣稱已做到 exactly-once。
輸出也要按 attempt 隔離。每次執行有獨立目錄及產物清單,寫完後才公布完成紀錄;驗收端核對全部檔案、輸入版本與目前允許的 attempt。舊 worker 即使晚到,也不能更新正式結果指標。這種 fencing 保護的是結果採納,並不自動停止舊工作耗用資源;取消與資源回收仍要另外處理。
另一種情況是 coverage model 已更新到 v4,模型卻拿著 v3 的缺口要求重跑。舊結果可以保留作歷史證據,但不能直接混入 v4 的收斂曲線。模型、資料集與驗收版本都會變,平台必須阻止「跨版本湊出的一個百分比」。
省 token,未必省下晶片設計成本
評估這類平台,最容易選錯分母。若模型花少量推理費,卻啟動大量沒有增量的回歸,token 成本再低也沒有意義。相反地,較昂貴的一次分析若省下很多無效模擬,整體可能更划算。需要一起量的是 CPU-hour、license-hour、儲存與傳輸、排隊時間、工程師介入,以及新增的有效證據。
用一個純假設算例:基準策略執行 100 個測試,每個使用 4 核心、跑 2 小時,合計 800 CPU-hours。候選策略只需 70 個同成本測試,再加 40 CPU-hours 的分析與前處理,總計 600 CPU-hours,計算資源減少 25%。但只有在兩者達到相同驗收目標、保留必要多樣性,且沒有漏掉基準會發現的失敗時,這個節省才有意義;它不包含模型服務費,也不是高通的結果。
即使 CPU-hours 下降,wall-clock 仍未必改善。若候選測試更集中使用某個稀缺 license,或者每輪都等待模型分析後才提交下一輪,關鍵路徑可能更長。實作上可以批次提案、限制每輪並行數,並保留 baseline 回歸持續運作;但批次越大,使用的 coverage 狀態越舊,後續測試互相重複的機會也越高。
選擇方法也應跟問題相符。現有測試已經充分涵蓋設計,只想移除冗餘,coverage-based test selection 或簡單啟發式可能足夠;刺激參數空間穩定且能大量取得回饋,專用最佳化器值得評估;缺口需要閱讀規格、理解錯誤訊息並提出新的測試結構,才更有理由導入 LLM。三者可以合作,沒有必要把每個迴圈都改成對話。
從驗證擴展到整個 CAD 平台,哪些能共用?
這套設計最有機會共用的是實驗身分、資料血緣、資源帳務、權限與結果驗收協定,而不是把每個 EDA 階段變成同一種分數。
在模擬中,要固定 RTL、testbench、assertion 與 coverage model;移到 STA,就要重新界定 netlist、SDC、library、corner 及寄生資料。AI 改動 SDC 後,WNS 變好可能來自合法修正,也可能只是刪掉約束。只有同時檢查約束語意與分析前提,QoR 改善才具有工程意義。這是沿用「不可由探索器擅自改題目」原則的設計推論,不是高通已公開的 STA agent 能力。
同理,formal 的 pass 取決於假設與所證性質,APR 的量測取決於輸入與工具設定。平台可以共用執行及追溯機制,domain owner 仍必須定義各自的驗收規則。共用太少會變成一堆孤立腳本,共用太多則容易把關鍵語意壓成一個失真的 success 欄位。
我會把未來六到十八個月的驗證順序分成三步。先把一小組真實但可安全使用的工程問題做成固定輸入、固定驗收的實驗集;再比較基準策略、專用最佳化與模型提案在相同預算下的差異;最後才擴大自動執行權限。這是建議的落地次序,不是高通公布的 roadmap。
最小實驗可以從上述 FIFO 開始:準備數個明確規格、刻意注入的錯誤與獨立保留的 seeds,每個策略重複執行多輪。量測到第一個有效反例的時間、固定測試預算下的新增 coverage、CPU/license 消耗,以及錯把不完整結果當成通過的次數。若增加模型之後沒有改善這些指標,就不應只憑生成的解釋更漂亮而擴大部署。
後續可追蹤的公開資訊
首先是 FunCovr.ai 後續是否公開更完整的方法與比較條件。能動態提出刺激很有價值,但仍要知道 baseline、測試規模、是否獨立保留驗收規則,以及改善能否跨設計重現。第一作者的後續材料比再一則「AI 加速驗證」標題更值得追。
其次是高通與 AWS 是否進一步公開 Bedrock 實際落在哪一層。用來查詢文件、提出修正、生成測試或直接推進流程,是不同的權限與風險等級;目前公告不足以區分。不能把合作宣布直接當成端到端自主設計已完成。高通公告的實際範圍
另一個指標是平台是否開始用「每單位成本新增多少可信證據」衡量成果,而不只量模型呼叫量或 test pass rate。高通歷史 ICO 案例提供了資源與收斂的具體觀察,新平台若要說服工程組織,還需要同樣清楚的條件、分母與失敗分析。既有案例
對 CAD 平台而言,比接進更多模型更優先的實驗,是拿一個會失敗的設計,確認 AI 能找到反例,平台能完整保存它,而且任何重試、版本變更或分數最佳化,都不能把那份反例悄悄消掉。
參考資料
- Qualcomm Announces Multi-Generational Product Collaboration with Amazon to Build Next-Generation AI Data Center Infrastructure — Qualcomm,2026 年 9 月 8 日。EDA/Bedrock 使用方向屬公告計畫。
- DVCon India 2026 Selected Papers List — 第 5 頁,1C1;Mahesh Shinde、Shashivardhan N A、Avinash Anantharamu、Nitin Neralkar、Veeraraju Potta,〈FunCovr.ai: AI that Generates Sharper Coverage & Smarter Closure〉。日期依最終第三日議程,2026 年 9 月 3 日。
- FunCovr.ai 第一作者的會後分享 — Mahesh Shinde;另見共同作者對高通團隊的確認。公開貼文說明研究方向,未提供完整可重現實驗。
- How Qualcomm Leverages AI for Chip Verification — Synopsys,2023 年,回顧 DVCon US 2023 高通 VCS ICO 案例。屬廠商公開的客戶成果,不是本文獨立量測。
- Unified Coverage Interoperability Standard — Accellera Systems Initiative,UCIS 1.0,2012 年。本文只引用其跨工具 coverage 資料互通目的。
- Return control to the agent developer — AWS,Amazon Bedrock 使用者指南,2026 年 9 月查閱。代表 AWS 公開介面能力,不代表高通已採用該模式。