
跨分區寫入如何取得唯一 ID:從取號需求到分配邊界
一個多租戶服務原本把所有訂單存進同一個資料庫,由資料庫自增主鍵識別。現在訂單、訊息與工作紀錄開始分散到不同資料分區,各分區都能獨立建立物件,卻可能同時產生 101。當資料匯入共用稽核平台,或 API 只用一個數字指定物件,這個識別就變得模糊。
我們要設計一種取號方式,讓不同寫入者拿到不會混淆的識別碼。先不決定是否需要共用服務:如果 API 永遠帶著分區或租戶,局部序號也許已足夠;如果只傳一個 ID,唯一範圍就得涵蓋所有分區。還要問它是否代表建立順序、能否出現缺號,以及節點失聯後是否必須繼續工作。這些答案會決定要把協調放在哪裡。
短網址服務用同一筆建立交易確認 slug 與重試結果。這裡延伸到取號與業務寫入位於不同權威邊界的情況:取得 ID 之後,物件仍可能沒有建立成功。
先看圖中的兩個寫入者:A 與 B 各自在自己的分區建立 101,局部使用原本沒有問題;送入共用查詢或稽核之後,單一的 101 卻不能辨認物件。待解的需求是唯一範圍與呼叫契約,接著才有理由比較複合識別、號段或時間型 ID。
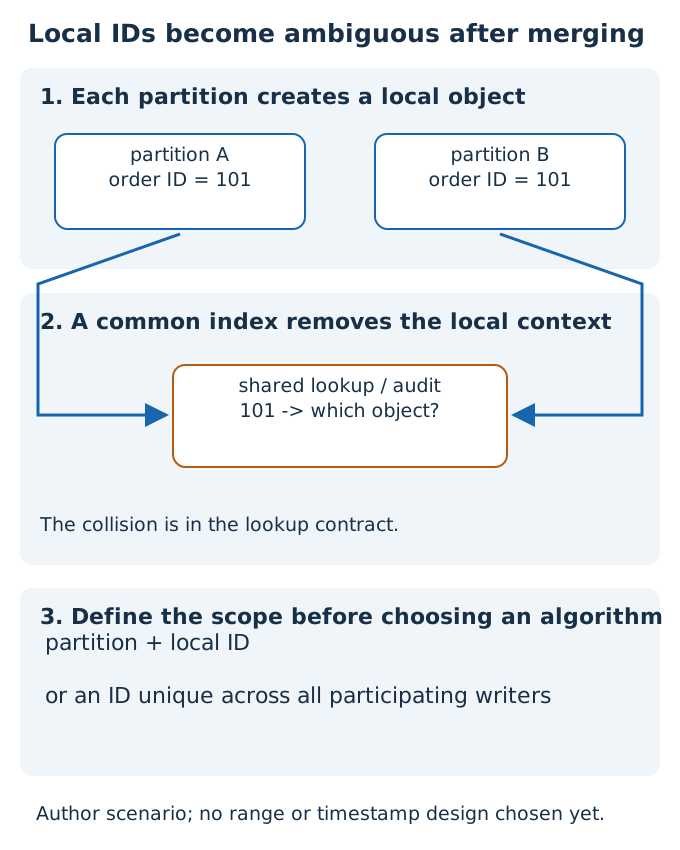
圖:作者設計的識別需求情境。局部取號機制參考:PostgreSQL Sequence Manipulation Functions;圖中尚未選定跨分區演算法。
不同分區要共用哪一種識別契約
先回答相容性問題。這個案例的既有資料與下游索引使用 BIGINT,因此第一版維持正的 63-bit 整數,不要求呼叫者一次遷移所有外鍵。呼叫者可指定經核准的 namespace,得到正的 63-bit 整數。目標是:同一 namespace 的每個成功發出的 ID 永不重複,跨 namespace 可用不同表或另帶 namespace 組成複合識別;若 API 對外只傳一個純整數,則所有租戶共用同一全域 stream,不能偷偷重用 namespace 內的值。以下算例採單一全域 stream。
功能範圍只有取號、讀取服務健康狀態與管理分配權限。ID 不編碼租戶權限,也不作授權憑據。不承諾無缺號、不可猜測、按照交易完成時間全域遞增,或在取號成功後自動建立業務物件。這些是不同契約:例如 A 先取得 101 後花三秒驗證,B 取得 102 並先提交,資料庫中的建立順序就和 ID 順序相反。若要做金融流水的無缺號序號,通常必須把編號放在同一筆業務交易的串行邊界,容忍那條路徑的延遲與可用性成本。
如果需要共用取號邊界,對業務 caller 的 API 可維持很窄:
POST /v1/ids
Authorization: Bearer <service-identity>
Content-Type: application/json

{"namespace":"global"}

HTTP/1.1 200 OK
{"id":"492081735200001"}
用十進位字串傳回,避免 JavaScript 對超過 2^53-1 的整數失去精度。X 在 2010 年公開 Snowflake 遷移資訊時也說明了整數與字串並行輸出的原因;那是當年的 API 相容性事實,不代表今天所有客戶端都只能處理 53-bit 整數。X Engineering:Announcing Snowflake(2010)、X 開發者遷移說明(2010)
取號成功表示「這個值已分配給這次呼叫」,不表示下游 INSERT 成功。若 HTTP 回應遺失,重試可能拿到另一個 ID;兩個都合法且一個可能成為缺號。若業務希望重試仍建立同一筆訂單,應讓建立訂單的 API 使用 Idempotency-Key,在自己的權威資料庫中原子保存 key、request hash 與物件 ID;不要把可重試的業務語義誤放在取號器上。這個界線和 AWS Builders’ Library 的 idempotent API 設計及前篇短網址的建立路徑相同。
作為假設設計目標,取號 API 在健康狀態下要有 99.99% 成功率、p99 低於 20 ms;取號之後的訂單提交另計。99.99% 若以 30 天計算,等價於約 4.32 分鐘全部不可用;真實 SLI 應以合法請求成功比例量測,並把超時算失敗。上游有自己的 deadline,取號服務的排隊與重試不能把它吃光。Google SRE:Service Level Objectives
控制面故障時能否暫停?假設業務允許短暫回 503,優先保持已發 ID 不重用;不要求無限離線產生。缺號可以接受,但重複不可接受。ID 也不必按建立時間排序,列表使用業務庫的 created_at 與穩定次排序鍵;若後來需要跨節點近似排序,再評估編碼。先排除這些額外承諾,才能用較簡單的分配規則完成第一版。
先用共同序號走完取號與業務建立
最小版本仍可用一個共同的資料庫 sequence。業務節點先向它取下一個數字,再寫入自己所屬分區;單一序號權威使各分區不再各自從 1 開始。若所有物件仍存在同一個業務庫,而且 ID 不需提前交給外部,用該庫的 sequence 更直接,甚至不必建立獨立服務。
但取號和訂單提交仍是兩件事。節點取得 101 後崩潰,101 成為缺號;取得 102 並提交訂單後回應遺失,caller 應由訂單的冪等鍵找回 102,而不是要求取號器撤銷數字。PostgreSQL 的 nextval 不會因交易 rollback 收回數值,官方文件也明確提醒 sequence 無法提供無缺號承諾。PostgreSQL:Sequence Manipulation Functions
這個版本的正常路徑是入口驗證服務身分、共同權威分配一個數字、業務節點用該數字提交物件、最後回應使用者。資料庫唯一約束仍保留,但只覆蓋自己的表;跨分區唯一性來自所有寫入者遵守同一分配邊界。漏接新服務、手動塞入 ID 或從舊備份啟動另一套取號權威,都會破壞這個假設。
現在才問容量。每個 ID 都經過共同邊界,是否把大量原本可獨立完成的寫入重新串在一起?若只是每秒幾百筆,這條路通常值得先驗證;是否能支撐接下來的量級,必須拆開網路、排隊與權威狀態更新成本。
尖峰流量能否逐個通過共同確認
假設每日分配 30 億個 ID,平均約 3,000,000,000 / 86,400 ≈ 34,722 IDs/s;尖峰是平均的 12 倍,約 416,667 IDs/s。假設有 64 個服務節點均勻承擔,尖峰每節點約 6,510 IDs/s。這些都是架構算例,不是任何公司的實際負載。若共同取號服務把每個 ID 都實作成同一列資料庫的持久化更新,權威序號列要承受約 42 萬次每秒的熱點更新,還要把 commit latency 加在每次呼叫上。
可以先比較兩條路:把 ID 改成較長的隨機值,讓節點免協調;或保留整數及確定的不重複契約,把共同確認的單位由一個數字改成一段區間。這裡選第二條,因為既有 BIGINT 與確定唯一性是需求。每次向權威庫預留 100,000 個整數,尖峰協調更新量變成 416,667 / 100,000 ≈ 4.17 次/s。節點熱路徑只需本機原子遞增。每個節點的區間在均勻尖峰約 100,000 / 6,510 ≈ 15.4 秒用完;在平均負載約 184 秒用完。因此要提前請領下一段,而不能等 next == end 才同步打資料庫。若在剩餘 40% 時啟動預領,尖峰只有約 6.1 秒的控制面恢復空間;這是一個可計算的故障預算,不是「有 cache 就高可用」。
號段大小牽動浪費和恢復時間。若每台只持有一段,64 台同時崩潰的未用 ID 上界不足 640 萬個;但加入預領後,必須連下一段一起算。本設計限制每台最多一個使用中區間加一個已預留區間,保守上界為 64 × 2 × 100,000 = 1,280 萬個,約每日 30 億個的 0.43%。若擴成 100 萬號段,控制面寫入變成 0.42 次/秒,兩段預留的報廢上界也增為 1.28 億個。這些空洞可能讓依 ID 估算業務量的人得出錯誤結論。PostgreSQL 官方文件明確指出 nextval 不會隨交易 rollback 收回,也不能提供 gapless sequence;這裡同樣選擇「不重用」換取唯一性。PostgreSQL 18:Sequence Manipulation Functions
這裡減少的是每個 ID 的權威寫入與 commit 等待,不是所有網路成本。若 caller 每次仍呼叫獨立的取號 HTTP API,約 42 萬 QPS 的入口、驗證與傳輸仍然存在,需要量測擴容;若允許將號段消耗器嵌入業務 process,才可拿掉這次網路 hop,但也要讓每個 process 成為獨立的號段 owner,限制每台預留總量。本案例用 64 個取號節點算預算,不能把 SDK 的數千個 process 偷偷代入而沿用同樣的缺號上界。
如何把一段數字安全交給單一節點
選擇預留區間後,問題變成如何證明任意兩次成功請領都不重疊。權威狀態可以小到一張表,並且只由一個可交易、持久化的寫入主節點負責:
id_streams(
  namespace PRIMARY KEY,
  next_unreserved BIGINT NOT NULL,
  version BIGINT NOT NULL
)

allocation_audit(
  allocation_id PRIMARY KEY,
  namespace,
  lo_inclusive,
  hi_exclusive,
  owner_instance,
  committed_at
)
這個範例只有 global 一列,partition key 是 namespace;64 台 worker 並沒有 64 份權威計數器。以交易鎖住 id_streams['global'],設舊值 N,驗證 N + 100000 不溢位,寫入 next_unreserved = N + 100000,再寫一筆 audit,交易持久化確認後把半開區間 [N, N+100000) 回給請領節點。allocation_id 由請領者產生並設唯一索引;同一個請領請求若在 commit 後丟失回應,重試先讀 audit 找回原區間,不能悄悄再把另一段交給它。audit 和 watermark 要在同一交易中提交。
每個節點握有 lo ≤ next < hi,本機 CAS 或受鎖保護的遞增操作保證同一區間內不重複。請領者不能把整段再分配給兩個未協調的 process。重試回應以 allocation_id 去重,同一段不能再次安裝並把 next 歸零;回應也要綁定請領時的 process incarnation。節點重啟後丟棄舊區間、忽略舊 incarnation 的延遲回應,並用新的 allocation_id 取新段。號段即使只用掉一個,也不回收。若業務要知道某個 ID 是否真的被建立,只能查業務資料庫,不能從 audit 中的「已預留」推定。
audit 不是無成本的附註。每天 30 億個 ID、每段 10 萬個,約有 30,000 筆 allocation/日,一年約 1,095 萬筆;若每筆粗估 96 bytes,單份原始資料約 1.05 GB/年,實際還有索引、WAL 與備援。這筆寫入量比逐個取號小五個數量級,值得保留足夠長的請領去重與稽核窗口。若因 retention 把舊 audit 刪掉,同一 allocation_id 在窗口外重試也只能得到一段全新、不重疊的數字;API 必須明確說明請領重試的保存期限,不能同時承諾永久找回同一段並無限期刪除映射。
預領還需要節流。權威庫修復後,64 台節點如果各開十條並行 retry,就會把原本每秒 4 次左右的穩態交易變成同一瞬間的數百次競爭;每台只允許一個 outstanding reservation,指數退避加 jitter,且不因 timeout 直接換 allocation_id。若一台節點因租戶流量偏斜從每秒 6,510 個升到 60,000 個,10 萬號段只撐 1.67 秒;它要能及早請領、更早報告剩餘秒數,必要時在節點入口限制該租戶。否則全站平均容量足夠,單一節點仍會先耗盡、排隊,最後把 timeout 轉成上游重試風暴。
圖 1|作者設計;號段交易與本機消耗的界線。序號允許缺口的語義參考 PostgreSQL sequence 文件。
寫入業務物件的端到端路徑因此是:gateway 驗證呼叫者 → ID 節點從本機區間取號 → caller 對自己的資料分區做 INSERT 並以主鍵/業務冪等鍵約束 → 業務交易 commit 後才回「物件已建立」。如果 caller 在取號之後、INSERT 之前崩潰,只留下缺號;若 INSERT commit 後回應遺失,業務冪等鍵找回原物件。取號器不擁有訂單狀態,沒有跨資料庫的「取號+建立」原子交易,也不需要為了一個可接受的缺口引入兩階段提交。
把一段拆成多個值沒有新的持久化交易。next 的原子遞增只對該 process 擁有的區間有效;它的唯一性依賴上游已持久化的排他分配。若容器映像或記憶體快照複製了仍有效的本機區間,兩個 process 就可能各自回同一數字。因此重啟、擴容與快照還原都必須請領新段,不能以保存本機計數器來延續 ownership。
主庫接手時,已確認的分配不能倒退
號段把低頻的權威交易留在控制面,卻讓已成功分配的數字迅速出現在許多節點。這使資料庫接手的確認界線比平常更重要。
此設計能接受單一權威寫入者,卻不能接受會倒退的已確認 watermark。假設主庫提交到 500,000 並回了一段 [400000,500000),但備庫只複寫到 400,000;主庫失聯後直接提升備庫,它可能再次分出同一段。唯一性已破壞,audit 也可能跟著消失。正確的 HA 契約是:分配交易的成功回應必須建立在故障接手仍可保留的持久化確認界線上;切換時先隔離舊主庫,確認新主庫含所有已確認分配,再開放服務。若選非同步備援且不能證明這件事,切換必須暫停、核對最高已發號段或從足夠高且持久化的安全水位開始;接受空洞,不能重放已發數字。把資料庫寫成「有 replica」沒有回答這個問題。
單一 stream 的 4.17 次/秒更新量很低,早期沒有必要分片。將來若同一筆交易要替 1,000 個 namespace 各保留一段,才可按 hash(namespace) 拆權威分區;仍要確認外部 ID 的唯一範圍是 (namespace, id),或將全域 namespace bits 納入 ID。業務資料則以 tenant_id 或物件 owner 分區,因為依租戶列出訂單時需要定址單一資料分區;拿生成器的單調 ID 當資料庫 partition key,會把新寫入集中在最後一片。ID 的順序、業務物件的局部性和索引的熱點,是三個不同問題。
需求增加近似時間排序,編碼需要改什麼
若需求改為 ID 本身可快速按建立時間近似排序,而且不願每個節點持續預領區間,可以把時間放進 ID。X Engineering 在 2010 年公開的 Snowflake 提案以 timestamp、worker number、sequence 組成大致可排序的 64-bit ID;當時文章也明說開源軟體仍屬 alpha,尚未用於 production,不能把提案直接描述為已驗證的今天架構。X Engineering:Announcing Snowflake(2010)
拿常見的 1 個未用 sign bit + 41-bit 毫秒時間 + 10-bit worker + 12-bit sequence 作設計算例:2^41 ms ≈ 69.7 年、1024 個 worker 身分、每個 worker 每毫秒至多 4096 個序列值。1024×4096×1000 是理論欄位上限,不是吞吐 benchmark;實際還受 CPU、網路、鎖、時鐘讀取與排隊限制。部署前要選 epoch,監控剩餘年限與 id 位元溢位,不能到 69 年後才發現 sign bit 要翻轉。X 開發者說明(2010)
節點本機維持 (last_ms, sequence)。當 now_ms > last_ms 時重設 sequence;相同毫秒就遞增;4096 個值用完後等待下一個毫秒或快速拒絕,不能回捲 sequence。只靠時間和 sequence 還不夠:如果兩個 process 同時自認 worker 17,完全相同的毫秒與 sequence 就會碰撞。這時協調端不再為每個號段寫 watermark,但仍必須對 worker 身分擁有可證明的排他權。
更微妙的是 now_ms < last_ms。允許倒退 20 ms 並把 sequence 歸零,會和先前同一 worker 在那 20 ms 內發過的組合重疊。保守做法是停止取號,直到牆上時鐘追上 last_ms;短回撥可在有界 deadline 內等待,長回撥應撤出流量、告警與人工處置。另一種方法維持 logical effective_ms = max(now_ms, last_ms),但必須有足夠 sequence 空間,並在重啟後保存或重建 last_ms,否則重啟會失去防重記憶。單調時鐘只能量測 elapsed time,不能單獨提供跨重啟的牆上時間編碼。
圖 2|作者設計;位元配置示例依 X 的 Snowflake 說明(2010),狀態轉移為本文的保守設計。
時間型 ID 只能說近似時間排序。同一毫秒裡,高位時間相同,後面的 worker bits 可能使稍晚的 worker 2 ID 排在較早的 worker 3 前;跨節點時鐘偏差會放大反轉。就算 ID 全域遞增,先分配仍不代表先 commit。如果產品規格要求 GET /events 嚴格呈現資料庫提交順序,應使用權威日誌 offset、資料庫 commit sequence 或該聚合內的版本,並把排序與可見性的責任留在那個提交系統。etcd 官方 API 文件說明了 revision 如何排序儲存狀態的更新;這種權威版本不能由一組應用節點的本機牆上時鐘替代。
因此這個需求變體改了兩個成本:不用一直請領區間,卻必須替每個 worker 的時鐘與 incarnation 建立安全規則。若排序只是管理頁的查詢需求,增加 (tenant_id, created_at, id) 索引往往比換全站 ID 編碼便宜;只有 ID 自身的近似時間局部性、獨立產生能力確實帶來收益時,才承擔下節的接手限制。
worker 身分到期後,舊 process 為何仍能發號
時間型編碼需要不同 process 不共享 worker bits,因此常見提案是 worker 啟動時向協調端取得 worker_id=17 的 lease,持續 keepalive;lease 到期便讓新節點接手。這有助於可用性,卻不足以單獨保證排他。假設舊 process 長時間 GC pause 或被網路隔離:協調端宣告 lease 過期,新 process 拿到 17;舊 process 恢復時可能還握著舊的本機計數器與待送回應。若它沒有在回應前重新查核權威 ownership,兩邊就能同時送出 worker 17 的 ID。即使查核,權威查核和回應之間仍有時序裂縫。etcd 文件也區分:lease 會依 TTL 到期、watch 不是 linearizable 的同步檢查;操作是否完成以共識提交及回應為界。etcd API Guarantees
若仍要採時間型 ID,最直接且容易驗證的版本,是將 worker 身分視為一個 process incarnation 的永久分配值:每次啟動取新的、從未用過的 worker 身分;舊 process 即使復活,也無法和新的 incarnation 共享 worker bits。這要求位元空間或外部世代規劃足夠,10-bit 上限不適合無限次重啟。另一種是編碼 generation/epoch 並減少可同時工作的 worker bits,搭配權威端原子增加世代、拒絕舊世代寫入與讀取;若舊 process 還能直接對 client 回應,單靠下游 fencing 又擋不住已曝光的重複 ID。回收 worker 身分前至少要證明舊 incarnation 已不能發出值,並處理在途回應與最遠的可接受時鐘偏差。無法建立這個證明時,選號段或較長的隨機 ID 更誠實。
lease、fencing token 有各自的位置。對可控的共享儲存寫入,在交易裡比較 monotonically increasing generation,舊 owner 即使醒來也會被權威儲存拒絕,這是有效 fencing;etcd 的 revision 可作為這種有序世代的基礎。etcd v3.6 API:Revisions 但一個已在記憶體組好的數字、已送到外部 client 的 HTTP body,無法事後收回。產生器的正確性需要把 epoch 編進 ID、不重用舊 namespace,或讓所有取號回應穿過會實際檢查 epoch 的權威閘口;後者也把中央協調放回熱路徑。這是按狀態擁有者拆開後的代價,並非多加一個協調服務就自然解決。
圖 3|作者設計;lease 到期與修改 revision 的基本語義依據 etcd API Guarantees與 etcd API,雙主反例是本文推導。
號段接手失誤與控制面失聯會留下什麼
先看號段庫切換失誤。T0:主庫把 [400000,500000) 的 next_unreserved=500000 與 audit 提交並回應,節點 A 已回出 430001。T1:備庫仍停在 400000,主庫失聯。T2:沒有核對確認水位就提升備庫,節點 B 請領到同一段。殘留狀態是 A 的本機區間、外部 client 持有的 ID、舊主庫上已確認的 audit,以及新主庫缺少該 audit。使用者可能在不同資料分區各建立一筆 430001,跨分區查詢才發現碰撞;若兩筆落到同一表,第二筆會被 unique key 拒絕,請求表現為錯誤而不是「自動修好」。
偵測要同時看 allocation_audit 區間不重疊檢查、promoted replica 的已確認水位,以及業務端 duplicate primary key/跨分區 ID collision 指標。恢復時立即停止新分配與受影響的建立路徑,隔離舊主庫,核對最高可能已曝光的上界,把新權威 watermark 推到該上界以上且持久化,再恢復發號;已撞號的物件需要依業務鍵對帳與修復,不能用改計數器消除。可用性暫時下降,但唯一性優先。預防之道是把確認後可安全接手的 durable commit寫成主從切換的門檻,並用故障注入驗證「commit 後斷線、備庫落後、舊主恢復」的組合。這不是籠統的「資料庫 HA」設定。
第二個情境是控制面暫停。64 台節點在尖峰各持有一段 100,000 個 ID,預領端因權威庫失聯 30 秒。每台最多約 15.4 秒就耗盡本段;如果已有第二段,時間可延長,但取決於故障開始時的填充水位。耗盡時快速回 503 加有限的重試建議,不能透支未確認區間,也不能回收其他節點的未用段。控制面恢復後每台以 jitter 重新請領,限制並發交易與重試預算,避免 64 台同時把恢復中的資料庫打回故障。若業務真的要求 30 秒控制面故障期間仍接受 42 萬取號/秒,就要提高預留總量至少 416,667 × 30 ≈ 1,250 萬個 ID,加上安全餘裕與偏斜負載;這會增加崩潰時的缺號上限,也應考慮改用另一種 ID 契約。
如果節點必須長時間獨立產生,改選隨機識別
另一個可行替代是 UUIDv7。2024 年的 RFC 9562定義 48-bit Unix 毫秒時間與其餘版本、變體、隨機/可選 counter 欄位,也討論同毫秒單節點 monotonicity 與 counter overflow。它使不同節點不必租用短 worker ID,但在純隨機配置下是高品質亂數支持的機率性唯一,不能說成數學上絕對不撞。以假設尖峰 42 萬/秒、均勻約 420 個/毫秒、可用 74-bit 獨立亂數估算,單毫秒碰撞機率近似 420×419/(2×2^74) ≈ 4.7×10^-18;若一年每毫秒都維持這種尖峰,上界量級約 1.5×10^-7/year。實務要考慮亂數品質、批次/counter 實作與時間分布;主鍵唯一約束仍是最後防線。其 16-byte 欄位及前述索引差額也是真實的選擇成本。
還有儲存代價。若改採 128-bit UUIDv7 而非 64-bit ID,單一欄位差 8 bytes;30 億筆/日光一份主鍵的原始差額就是 3×10^9 × 8 B = 24 GB/day。若主索引與兩個次索引都帶完整 ID,理想化原始索引負載多約 72 GB/day,尚未計頁面、填充率與複寫;一年約 26 TB 的原始差額。索引設計未必都複製整個主鍵,這不是資料庫總成本估價,但足以說明「免協調」可能把成本搬到儲存、網路和記憶體工作集。
若產品改成多區節點可長時間離線建立,且允許 128-bit 與機率性唯一,UUIDv7 更符合新條件:本機不必等待號段控制面,但亂數品質與重複處理成為責任。若仍要求確定的 63-bit 全域唯一,則不能把網路分割時的停止行為刪掉;可以預留更大、不重疊的區間來延長離線時間,代價是更多可能報廢的數字。兩者改的是契約,而非更換一個函式名稱。
如何導入新分配器而不重用舊數字
上線時可先將原本單庫自增 ID 的寫入者改為從新服務取號,但需保留主鍵唯一約束,並把新 stream 起點設在已存在的最大 ID 之上,預留安全間隔。雙寫或影子取號階段只比較「能分到互不重疊區間」與延遲,不把影子 ID 寫入真物件;切流時逐租戶/逐寫入者開啟,回滾仍使用原本那個不與新號段重疊的序號空間或保留新分配器,絕不能把舊 sequence 設回較小值。若已有多個獨立資料庫各自用相同的 1、2、3,先清點並轉換既有識別與外鍵,不能直接宣稱全域唯一。讀路徑若仍按 tenant_id 分區,切換 ID 來源本身不要求搬動既有資料。
以剩餘秒數與分配紀錄觀測服務
取號 endpoint 只允許已驗證的服務身分與准入的 namespace;租戶不能指定 raw worker ID、改 watermark 或任意請領巨大號段。對每服務設 QPS 與 in-flight 上限,audit 記錄請領者與區間,避免被攻擊者耗盡數值空間。時間型 ID 會洩露粗略時間與 worker 分布,順序號段會洩露發號量;公開可列舉資源若需防猜測,應另設隨機 opaque token 與授權檢查。對外 ID 長得亂,不等於有權讀那筆資料。RFC 9562:UUID security considerations
日常觀測要對準承諾:取號 p50/p99 與 5xx、每節點剩餘號段可撐秒數、預領延遲、權威庫交易 commit/promotion lag、已確認 watermark、同一 namespace 的區間重疊、耗號速率、業務表的 duplicate-key、時鐘 offset/回撥與 worker 身分衝突。壓測不只用均勻 64 台,要讓少數節點吃掉大部分流量,並在號段剩 1% 時注入資料庫中斷;把回應在 commit 後丟掉;在時間型方案中於發號、GC pause、lease 到期、舊 process 恢復與時鐘回撥之間插入故障。真正的驗收是證明已成功曝光的數字不重用,不是每秒產生了多少數字。
回到跨分區識別的需求
回到跨分區建立物件的問題,這個方案以一個權威 watermark 保證不同節點取得不重疊區間,節點再用本機原子操作消耗數字。取號成功和業務提交分開,缺號合法,業務重試由各自的冪等交易處理。號段把共同寫入由尖峰約 42 萬次/秒降到約 4.17 次/秒,但仍留下有限的離線預算與接手時的耐久性門檻。
若資料根本不跨分區共用識別,局部 sequence 加租戶識別可能已足夠;若不需要提前取號,直接在業務庫分配更簡單。時間型 ID 增加近似排序,必須管理時鐘與 worker 身分;UUIDv7 免去短 worker 的協調,則改用較長欄位及機率性唯一。沒有一種生成方式同時替下游承諾提交順序、授權與無缺號。
下一個問題是共享流量:當一個租戶把建立與取號請求推高,如何讓不同入口共同遵守配額,並避免其他租戶被拖累?多租戶限流服務從這個資源分配邊界接續。
References
- Announcing Snowflake — X Engineering,2010 年公開提案。
- Snowflake update and migration details — X 開發者說明,2010 年。
- RFC 9562: Universally Unique IDentifiers — IETF,2024 年。
- Sequence Manipulation Functions — PostgreSQL 18 官方文件。
- etcd API Guarantees — etcd v3.6 官方文件。
- etcd v3.6 API — etcd 官方文件。
- Making retries safe with idempotent APIs — AWS Builders’ Library。
- Service Level Objectives — Google SRE。