
Coverage Regression 的成本模型:AMD 測試組合與驗證證據
Coverage regression 可以視為在有限成本內取得驗證證據的組合問題。AMD 的四項 VSO.ai 實驗顯示,在所測設計與 coverage 目標下,較小的測試集合可以達到相同 coverage;這提供了重新安排計算的方向,也要求平台回答被刪掉的工作是否藏有其他價值。AMD,SNUG 2023、案例整理
晶片驗證需要反覆執行 simulation,成本受測試數、執行時間、license 與叢集容量限制。全跑既有清單容易管理,卻可能重複命中相同行為;只挑容易增加 coverage 的 tests,又可能忽略長時間、低頻率或歷史失效案例。Coverage 是證據的一種表示,不能自行代表全部 bug detection 能力。
這個問題值得從平台角度研究,因為選擇器改變了哪些證據會被產生。以下先拆解測試集合與刺激探索,再把結果接到版本、checkpoint、holdout 及失敗恢復。要保留的能力是用可比較的證據配置資源,而非只把 regression 的百分比或 job 數當成進度。
先看圖中的 test/bin 矩陣:T1 與 T2、T3 與 T4 存在重疊;在這個小例子裡,保留 T1 和 T4 就能命中原來四個 bins。這使縮小 regression 成為可研究的選擇問題,也提醒我們相同 coverage 並不能自行證明所有 bug detection 能力都被保留。
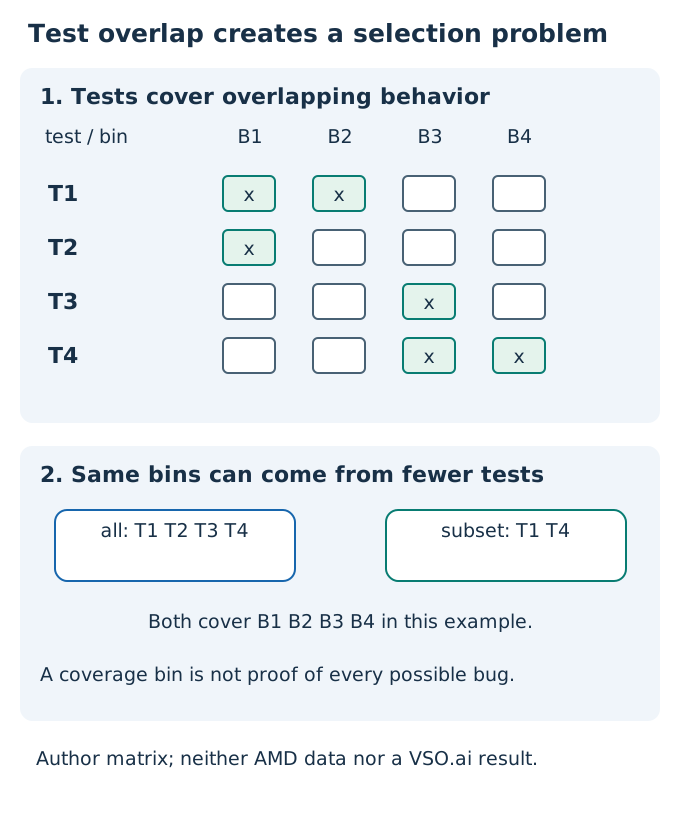
圖:作者假設矩陣,非 AMD 原始資料或 VSO.ai 實測;僅說明固定 bins 下的集合選擇。研究線索:AMD,SNUG 2023 Proceedings。
先把問題放回 R2G 的正確位置
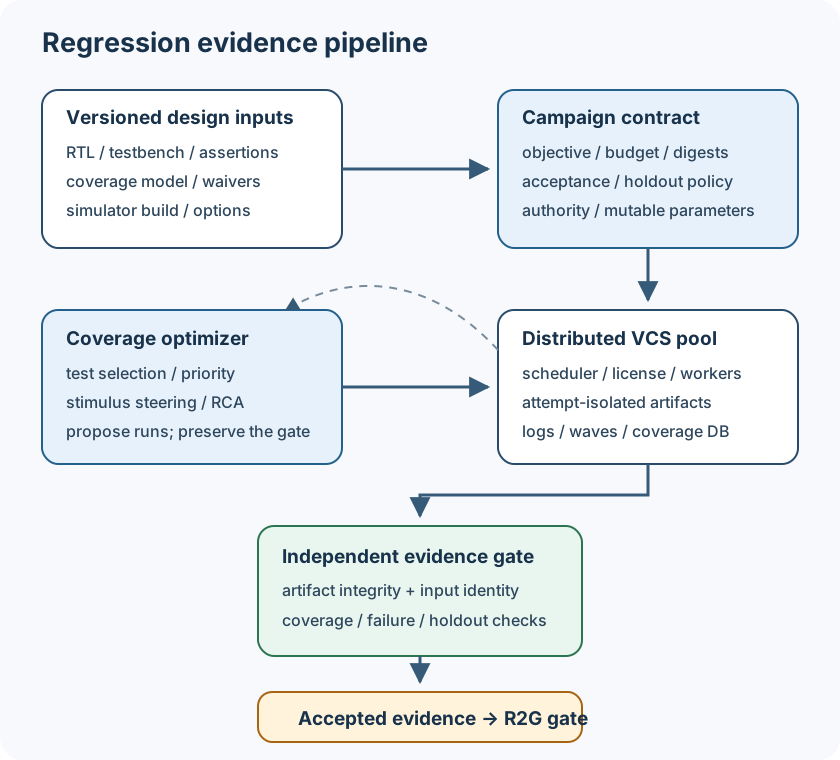
Coverage regression 位在 RTL/testbench 變更之後、功能驗證驗收之前。它接收 RTL、verification IP、assertions、coverage model、simulation build 與一組測試設定;輸出不只是 pass/fail,而是 assertion failures、waveforms、logs、functional/code coverage databases,以及「這些證據對應哪一版輸入」的關係。
這一段沒有直接改動 netlist、SDC 或實體設計,但會決定 RTL 是否有資格繼續往 synthesis 與後段流動。若平台用過期的 coverage model 宣稱收斂,或把缺檔的 simulation 當成 pass,後面的 R2G 流程即使全部綠燈,也只是對錯誤的前提做得很完整。
AMD 案例的目標寫得很清楚:在小幅 RTL 變更與 design variants 下,持續、自動且最佳化地達到 100% coverage。這裡的「100%」只對實驗採用的 coverage model 成立;它不保證規格沒有漏寫、checker 一定正確,也不等於 silicon signoff。這個限制不削弱結果,反而幫平台定義了可驗收的輸入與輸出。
機制一:從「全跑」改成有成本的測試組合
傳統 regression 清單隱含了一個保守假設:每個測試都有不可替代的價值,所以版本變更後全部重跑。實際上,多個 constrained-random tests 可能反覆命中相同 bins;某些 seeds 的邊際 coverage 幾乎為零,卻仍消耗 CPU、license 與排隊時間。
把一次 campaign 寫成矩陣會更容易看清問題。每一列是一個 test/seed/option 組合,每一欄是一個 coverage bin;hit[t,b] 表示測試 t 是否曾命中 b,cost[t] 則是執行時間、CPU-hours 或 license-hours。平台要找的是一組測試,在涵蓋必要 bins 與保留缺陷偵測能力的前提下,使總成本下降。
最小的啟發式可以反覆挑選 新增的重要 bins 權重 ÷ 預估成本 最高的測試。商用 VSO.ai 並未公開等同這段演算法;官方產品頁只確認它能依使用者選定的 objective,例如 regression CPU time、run count、simulation cycles 或 cycles-per-second,自動辨識與協調測試。AMD 簡報摘要另提到,傳統 URG 採 seed-based analysis,而 VSO.ai 採 probability-based grading。這表示平台不應把一次未命中直接解讀為測試無用,而要估計在多輪隨機執行中的命中分布與不確定性。
這裡有兩個容易被忽略的資料要求。第一,測試身分不能只有 test name;seed、compile options、runtime plusargs、RTL/testbench digest 與 coverage model version 都會改變結果。第二,coverage equivalence 必須在同一份分母上比較。若最佳化版本悄悄排除 unreachable bins,或基準與候選使用不同 waiver,測試數下降就失去意義。
AMD 的四項實驗也顯示,最佳化不能只服務最熟悉的設計。Inherited design 的工程團隊未必知道哪些 tests 是歷史包袱;若平台能用既有 evidence 建立 test-to-bin 關係,就能先找出低貢獻部分,再請 domain owner 審查。這比要求接手團隊重讀所有 testcase 更像可擴展的平台能力。
測試集合縮小後,如何證明沒有刪錯?
Coverage 相同只證明兩組 tests 命中同一份可觀測目標,不能證明 bug-finding power 完全相同。兩個 tests 可能命中相同 coverpoints,卻透過不同狀態路徑到達;一個會觸發 checker,另一個只在最後一拍命中 bin。若平台只保存 test-to-bin 的布林矩陣,就會遺失路徑、時間關係與 failure history。
因此 selection 的資料模型至少要分成三組特徵。coverage contribution 記錄 bins 與命中機率;failure contribution 記錄過去發現過的 unique signatures、與 RTL 變更的關聯;execution cost 保存時間、cores、memory、license class 與失敗重試率。實際排序可以因階段而變:日常 presubmit 優先 time-to-first-failure,夜間 regression 偏向 coverage gain,milestone gate 則提高歷史 fault detectors 與多樣性權重。
一個合理的驗收方法是 shadow mode。Optimizer 產生建議集合,但 full regression 照常執行數週;平台比較兩者會發現的 failure signatures、coverage frontier 與完成時間。接著把未被 selection 採用的 tests 當 holdout,而非立刻刪除。若 holdout 經常先找到獨特 failure,就表示模型過度依賴舊 coverage,應調高 exploration 或補入 design-change features。
還要處理冷啟動。新 IP、重大 microarchitecture 變更或重新撰寫的 testbench 沒有可靠歷史,舊的 test ranking 不應直接沿用。平台可回到分層隨機抽樣,等 evidence 足夠再逐步提高最佳化比例。這種降級路徑很重要:最佳化服務不可用時,團隊仍能回到固定 regression;缺少 fallback 的閉環會把單一模型服務變成 signoff 關鍵路徑。
機制二:在測試內調整刺激,再解釋尚未命中的原因
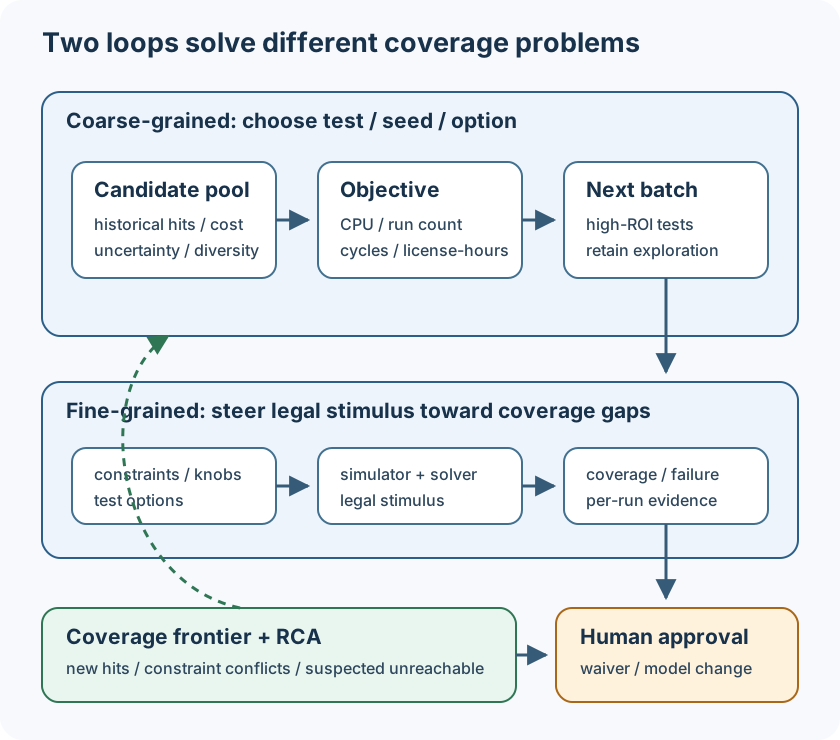
只刪除冗餘測試,能壓縮已知 evidence,卻不一定打開 coverage plateau。VSO.ai 的公開介面另有 fine-grained 路徑:在 simulator 內從 constraint solver、test 與 test-option 層級調整 constrained-random stimulus,朝尚未命中的 coverage points 前進;再對未命中 bins 做 root-cause analysis。Synopsys 的產品說明明列支援 covergroups、assertion coverage,以及 line、toggle、FSM 等 code coverage,而且不需要修改 design 或 testbench code 即可接入既有 VCS regression。
這個機制的價值是把兩種問題分開。第一種是 sampling 問題:合法情境存在,但目前 constraints 與 seed 分布讓它很少發生。第二種是 semantic 問題:兩條 constraints 衝突、bin 對目前 configuration 不合法、checker 被前置錯誤阻斷,或 RTL 根本無法到達那個狀態。前者適合重新分配刺激;後者需要診斷、修規格或修環境。
如果兩者混在一起,optimizer 可能對 impossible bin 無限加碼,耗盡運算預算;也可能把難命中的真實缺口錯標為 unreachable。平台因此要保留「模型建議」「工具執行證據」「工程師核准的 waiver」三種不同權限。模型可以指出 constraint conflict,卻不應自行修改 coverage 分母後宣布收斂。
一個完整案例:從 RTL 變更到可採信的 evidence
以下用一個可自行實作的 DMA command queue 說明平台契約;它不是 AMD 的設計。模組支援四個 channels,每個 channel 可 backpressure,reset 後要清掉尚未接受的 command。這次 RTL 變更修改了 arbitration,驗證計畫要求覆蓋 channel × queue_depth × reset_phase × backpressure_length 的交叉組合,並保留順序、資料完整性及 starvation assertions。
平台先固定輸入,而不是直接接受「替我跑 regression」:
campaign_id: dma-arb-rtl42-cov17
inputs:
  rtl_digest: sha256:rtl42
  testbench_digest: sha256:tb31
  assertion_digest: sha256:sva12
  coverage_digest: sha256:cov17
  simulator_config: vcs-2026.03-profile7
objective:
  preserve_bins: 1840
  minimize: license_hours
limits:
  max_parallel_runs: 80
  max_license_hours: 1200
acceptance:
  compare_with: full-regression-rtl41
  require_zero_unclassified_failures: true
  allow_waiver_change: false
第一輪先跑分層取樣,建立 test/seed 對 coverage bins 的命中關係,同時記錄每個 job 的 wall time、CPU time、退出狀態與 failure signature。外層 optimizer 找出大量重複命中正常 traffic 的 tests,把下一輪資源移到 reset 與長 backpressure 的交叉情境;內層則調整合法 stimulus parameters,提高該交叉組合的抽樣機率。
某個新 seed 命中 channel=3, depth=full, reset=deassert+1, bp=long,並觸發「已接受 command 不得遺失」的 assertion。結果不是 optimizer failure,而是一份高價值的 design evidence。平台保存 seed、波形、log、assertion ID、RTL digest 及最小重現命令,把 verdict 標成 design_failure。RTL 修正後建立新 campaign,先 replay 這個 seed,再跑最佳化集合與一組未參與學習的 holdout tests。
最後的交付包至少包含:已分類 failures、coverage database、每個 bin 的來源 runs、未命中原因、waiver 清單、holdout 結果與成本帳。只有 artifact integrity 通過、版本完全相符,且 domain owner 接受 coverage/assertion 結果,這份 RTL 才能進入下一個 R2G gate。
分散式 regression 的 checkpoint 不是一個目錄
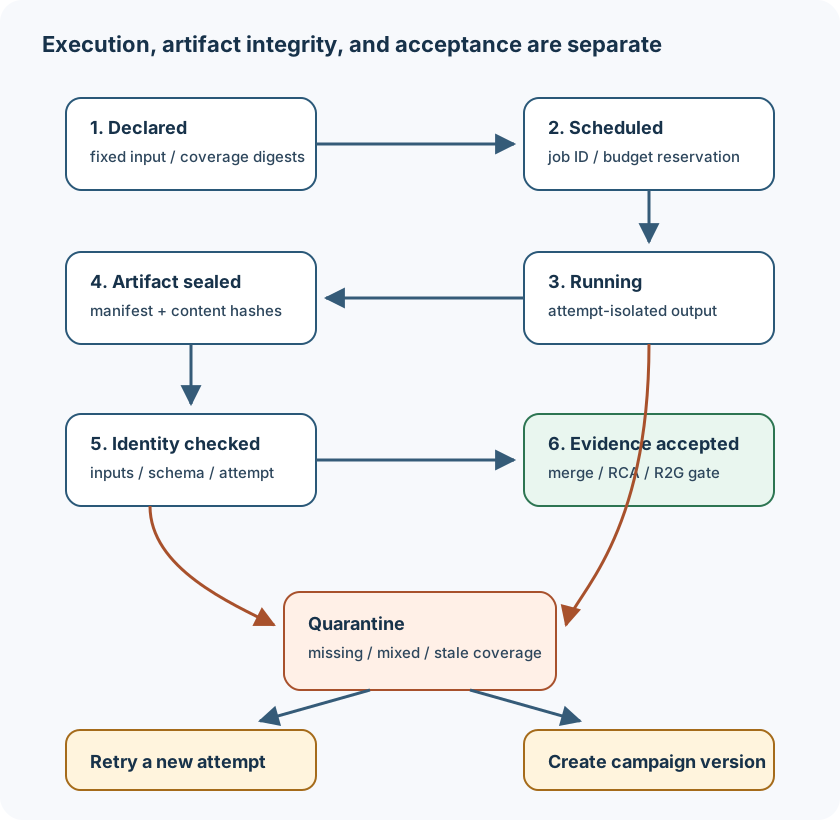
當數千個 simulations 分散到叢集,campaign state 至少分成三層:scheduler 的 job state、runner 產生的 attempt artifacts,以及已合併的 evidence state。三者更新時間不同,也可能彼此矛盾。
假設 worker 已完成 simulation 並上傳 coverage database,但在寫入 completion record 前中斷。Scheduler 可能顯示 job failed;直接重跑不會破壞正確性,卻會重複消耗 license。反過來,job exit code 為零但 coverage file 只寫了一半,若 merger 只看 scheduler success,就可能把損壞資料放進總分。
所以 checkpoint 應是一份帶內容雜湊的 manifest,而非共享目錄「看起來有檔案」。每次 attempt 寫入獨立、不可變位置,完整上傳後才發布 manifest;merger 核對 artifact digest、input digests 與 schema version。重試可以產生新 attempt,但只有通過驗收且被 fence token 採納的版本能進入 campaign evidence。
動態最佳化還多一個 checkpoint:optimizer state。它必須知道哪些結果已納入模型、目前 coverage frontier、剩餘預算與下一批已提交工作。若服務重啟後只讀合併 coverage,卻遺失 inflight jobs,就可能再排同一批 tests。比較務實的恢復語意是 at-least-once execution 加 exactly-once evidence adoption;前者允許重跑,後者阻止同一 attempt 重複計分。
Evidence 優先順序,不等於排程器優先順序
Optimizer 可能判斷某個 test 對 coverage 很重要,scheduler 卻只能看到 requested cores、memory、queue 與 license。若平台直接把 evidence score 映射成全域高優先權,單一專案就可能佔滿昂貴 license;若完全不傳遞,最佳候選又可能在長佇列尾端等待,閉環失去低延遲優勢。
較好的接口是由 campaign controller 提出「這批工作在本 campaign 內的相對價值」,資源管理層再套用跨專案 quota、fair-share、deadline 與 license policies。控制器可以選擇較便宜的替代 tests、降低並行度或延後低邊際工作,但不能自行繞過專案權限與資源配額。這讓演算法最佳化與組織治理分層:前者回答下一個最值得跑什麼,後者回答目前允許誰使用多少稀缺資源。
批次大小也會影響效率。一次只送一個 test,coverage feedback 最新,卻讓每輪模型計算、排隊與啟動延遲進入 critical path;一次送數百個,叢集使用率較高,但同一批內的 tests 可能互相重複。平台可以量測 evidence freshness:候選被評分時的 coverage frontier 與開始執行時已採納 frontier 相差多少。當 staleness 上升,就縮小 batch 或取消尚未啟動、預期邊際價值已降的 jobs。
取消本身也要保守。已取得 license、執行大半的 simulation 即使預期 coverage 重複,繼續完成也可能比中止便宜;而且它仍可能找到 failure。取消策略需要剩餘時間預估、preemption 成本與 failure value,不能只看 coverage gain。公開 AMD 摘要沒有這些排程細節,這裡是將其 test optimization 放進共享驗證叢集時必須補上的平台設計。
最危險的故障:coverage 分母在執行途中改變
假設 campaign 使用 cov17 已跑完 70%,此時驗證工程師在 cov18 新增 bins、修正一個非法 bin,並調整 cross coverage。若平台把後續 jobs 的 cov18 databases 與早期 cov17 直接 merge,總 coverage 百分比可能看似合理,實際分子與分母已不一致。
殘留狀態包括舊版 results、已提交 jobs、optimizer 對 bins 的 learned weights、coverage merge cache 與報表。偵測點是每份 artifact manifest 的 coverage_digest;只要與 campaign 宣告不符,就進入 quarantine,不能自動採納。恢復方式有兩種:凍結 cov17 完成原 campaign,再另開 cov18;或取消未開始工作、保留可重用的 raw results,對能安全重算的部分重新 elaboration/merge。哪一種成立,取決於 coverage instrumentation 是否已編進 simulation build。
這個邊界無法靠「AI 更聰明」消除。若 coverage model 變更會影響編譯結果,舊 run 就不能被重新解讀;若只改報表分組,原始 database 也許能重算。平台必須知道 tool boundary,不能從檔名猜可重用性。
三種平台方案,差別在保證邊界
| 方案 | 計算成本 | 回饋延遲 | 正確性風險 | 維護與整合 |
|---|---|---|---|---|
| 固定 full regression | 最高;重複測試持續累積 | 受最慢批次與 queue 限制 | 行為單純,但仍可能混版或漏收 artifacts | 最容易接既有 farm;測試清單會膨脹 |
| Coverage-aware test selection | 可刪除低邊際貢獻 tests | 可先回高價值 evidence | 依賴 test-to-bin 歷史;設計變更後可能失準 | 需要版本化 coverage、成本資料與 holdout |
| Adaptive selection + stimulus steering | 有機會同時壓縮與探索新 bins | 以多輪閉環換取更早收斂 | 模型可能過度利用已知路徑,或錯判 unreachable | 要接 simulator、constraint solver、RCA、checkpoint 與權限閘門 |
Full regression 並非一定該淘汰。它適合當週期性基準、release gate 或 optimizer 的獨立對照。Adaptive flow 則適合每日 RTL 變更、coverage plateau 與固定預算下的探索。真正可維護的設計通常是分層:每次 change 跑被選中的快速集合,夜間或 milestone 保留較完整回歸,最後用 holdout 與不可由 optimizer 修改的 assertions 檢查偏差。
用公開數字做一個成本尺度
AMD 報告的 1.5–16 倍是「達到相同 coverage 所需測試數」的範圍,公開摘要沒有提供每個 design 的 test count、run-time 分布、CPU 或 license 價格,因此不能直接換算節省金額。
可以用一個明示假設的算例理解平台量級。假設基準 regression 有 12,000 個 tests,每個平均 20 分鐘、使用 4 CPU cores 與一個 simulator license,總計 16,000 CPU-hours、4,000 license-hours。若某個候選流程達到 4 倍 test-count reduction,只跑 3,000 個 tests,simulation 變成 4,000 CPU-hours、1,000 license-hours;再加上 200 CPU-hours 的分析,總 CPU 成本仍下降 73.75%。
這不是 AMD 的量測。真實收益會被長尾 tests、編譯攤提、license token 類型、queue wait、coverage merge 與多輪 adaptive synchronization 改寫。若被保留的 tests 恰好更長,test count 減少 4 倍不代表 wall-clock 或 license-hours 同幅下降。因此平台的 objective 要直接使用實際成本,不要只最佳化 run count。
Agent 應該接在哪裡
這個案例很適合 agentic workflow,但 agent 的價值不在代替 simulator。比較合理的任務是讀取版本化的 campaign 摘要、找出 coverage plateau、解釋 constraint conflicts、提出下一批 tests 或請工程師確認 waiver。執行 adapter 再把核准動作轉成不可變 RunSpec,交給既有 scheduler。
權限要隨動作分級。重排已核准 tests 可以低風險自動化;修改 stimulus parameters 要受合法範圍限制;新增 directed test 需要 code review;修改 assertions、coverage model 或 waiver 則會改變驗收題目,必須由 domain owner 核准。所有 agent 建議都要連回 evidence IDs,否則人只會看到一段說得通、卻無法重現的解釋。
治理也不應只記錄對話。更重要的是保留 decision record:讀了哪些 coverage/failure summaries、使用哪版 policy、提出什麼候選、誰核准、實際執行哪些 jobs,以及結果是否改善固定指標。如此才能在模型版本更新、專案轉交或錯誤 waiver 被發現時重播決策。
六到十八個月,平台團隊值得先做的三件事
第一,建立 regression identity 與 artifact manifest。先解決同名 test、跨版本 coverage、缺檔和重試重複計分,再談模型。這一層也能直接服務 formal、emulation 與後續 signoff jobs。
第二,把 test selection 以 recommendation-only 模式接入一個 block。每輪同時保留 full baseline、候選集合與 holdout,量測相同 coverage/failure evidence 下的 CPU-hours、license-hours、time-to-first-failure 及漏失率。AMD 案例證明 test-count reduction 值得追,但自己的 workload 才能決定投資回報。
第三,再加入 adaptive stimulus 與 RCA,並把 coverage model/waiver 改動留在人類審核域。當平台已能從故障恢復、重播 decision record,且候選策略在數個 RTL revisions 上穩定優於 baseline,才逐步擴大自動執行權限。
這三步可以用一組固定的 service-level indicators 驗收:從 commit 到第一個有效 failure 的時間、達到 coverage gate 的 wall-clock、每新增一個重要 bin 的 license-hours、未分類 failure backlog,以及 evidence 因版本或缺檔被拒收的比例。前兩項看速度,第三項看資源效率,後兩項則防止平台用錯誤資料換取漂亮的 throughput。
若要判斷這項投資能否往其他 R2G 階段延伸,最值得觀察的不是模型準確率,而是 contract 是否可重用。Synthesis 也有版本化 RTL、constraints、tool build、checkpoint 與 reports;STA 則有 netlist、SDC、libraries、corners 與 parasitics。共用層可以沿用 identity、artifact lineage、budget、retry 與 evidence adoption,domain-specific 層則各自定義什麼結果能通過。把兩層分開,才能避免平台最後只剩一個跨工具的「success」欄位。
一個不接觸 PDK 的最小驗證,可以用開源 simulator 跑小型 FIFO 或 DMA queue。建立約 200 個 test/seed 組合與 50–100 個 functional coverage bins,先完整執行取得 test-to-bin matrix,再以 greedy set cover 選出候選集合;對下一版故意植入的三個 bugs,比較 full、selected 與 selected+10% random exploration 的 coverage、time-to-first-failure 及漏失。若最佳化只會保住舊 coverage,卻漏掉新 bug,平台就還沒有資格擴大權限。
AMD 這份舊而扎實的案例,補上了 R2G 系列中一個重要交接:RTL 不是因為「回歸跑完」就能往下游走,而是因為版本化、完整且符合既定驗收規則的 evidence 已被接納。下一個工程問題則是把這套 evidence contract 往 synthesis/STA 推進:當輸入變成 netlist、SDC、libraries 與 corners,哪些分析能增量重用,哪些變更必須讓舊結果失效。
這也是平台團隊最能累積、且能跨專案複用的工程資產。
參考資料
- Drop the Blindfold: Coverage-regression Optimization in Random Simulations using Synopsys VSO.ai — Michael Chan、Eric Chew,AMD,SNUG Silicon Valley 2023;Top 10 Best Presentation。官方 proceedings 提供簡報下載入口。
- 客戶案例亮點:AMD 對新思科技 AI 驗證工具進行實測 — Synopsys Taiwan,轉載 2023 年 8 月 28 日 SemiWiki 案例整理;包含四項實驗摘要與 1.5–16 倍測試數縮減。屬供應商/合作案例的公開結果,不是本文獨立量測。
- VSO.ai: AI-Driven Verification Solution — Synopsys,產品技術頁,2026 年 9 月查閱;說明既有 VCS regression 接入、支援 coverage 類型、可選 objective、simulator 內 stimulus optimization 與 RCA。
- Accelerating Coverage Closure with AI-Based Verification Space Optimization — Synopsys white paper landing page,2026 年 9 月查閱;說明 coverage 與 bug discovery 的關係及保證限制。
- AI-Driven Accelerated Bug Discovery and Coverage Closure — Synopsys,2026 年 3 月 18 日;延伸到 design change 後的 test selection 與 project-wide verification history。此較新機制不是 AMD 2023 實驗的已公開組成。