
STORM 的 RNIC 排程:從請求大小與 Backlog 判斷服務順序
STORM 研究的是 RDMA 請求的服務順序:RNIC 已能觀察 transaction size 與 per-QP backlog,這些局部資訊是否足以改善整體完成時間?它把排程視為一個獨立於路徑選擇及速率控制的設計維度,讓相同網路資源可以用不同順序交付工作。STORM,SIGCOMM 2026
RDMA 減少軟體參與資料搬移的成本,但多個 QP 仍會爭用 RNIC 與 fabric。短 RPC、大型資料傳送及 collective 的相依步驟,對完成順序的敏感度不同。公平分配當下頻寬是一個合理基線,卻未必同時縮短短工作的等待,或盡早解鎖後續計算。這使尾端延遲除了壅塞,也受到請求排隊位置影響。
這題的前瞻性在於,以硬體本來可見的訊號近似工作急迫性,可能減少 application hints 的介面成本。以下先追蹤 size、backlog 與 priority 的映射,再檢查量化、in-order RoCEv2、公平性及 congestion control 的互動。論文結果與延伸到其他 AI 工作的架構推論會分開討論。
沿圖從多個 QP 走向同一條發送路徑:RNIC 能看見待傳請求與 backlog,排程器再決定誰先取得服務。注意順序選擇與 wire priority 的交接;這讓排程能影響完成時間,也必須與下游交換器的服務方式一起檢查。
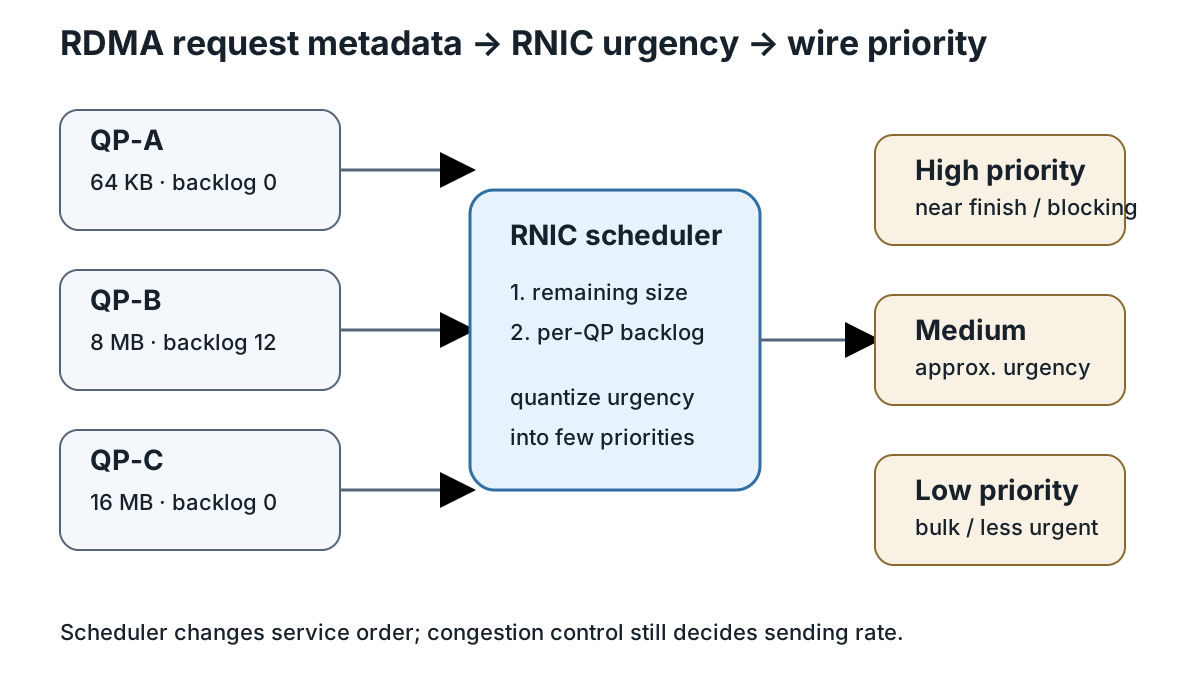
圖:作者整理;機制依據 STORM 論文摘要 與 Cambridge Systems Research Group 演講摘要。
公平共享在 RDMA 上丟掉了哪些資訊
先把問題拆乾淨。
假設一張 RNIC 上同時存在三個 queue pair:
- QP-A:一個 64 KB request,後面沒有工作。
- QP-B:一個 8 MB request,後面排著 12 個 request。
- QP-C:一個 16 MB request,後面沒有工作。
如果 NIC 只做 round-robin 或近似公平分享,三者都得到差不多的 service share。這個策略的優點很明確:簡單、穩定、不需要知道 workload 語意,而且不容易製造 starvation。
但它同時丟掉兩種很有價值的資訊。
第一種是 remaining work。64 KB request 幾乎已經在終點附近,讓它先完成,只需要極少的額外 service time,卻可能大幅降低 short-flow completion time。這也是 SRPT 類 scheduling 長期被研究的原因。經典的 pFabric 已經很清楚地說明,datacenter transport 裡「誰先被服務」與「每個 flow 最後拿多少 rate」其實可以分開處理。
第二種是 blocking externality。QP-B 的第一個 request 即使不短,它後面還有 12 個 request。只要 queue pair 的執行語意讓後續工作必須等前面的 request 送完,前面的 request 就不只代表自己;它還代表一串被擋住的工作。此時 queue depth 本身就成為一個粗糙但有用的 dependency signal。
STORM 的核心不是精準還原 application DAG。它接受資訊不完整,只問:如果 NIC 已經知道 transaction size 與 backlog,能不能只靠這兩個 local signal,把比公平分享更好的順序做出來?
答案至少在論文的 workload 裡是肯定的。University of Cambridge 的作者演講摘要 也直接指出,STORM 只依賴 NIC-visible information,不需要 application hint。
RNIC 其實已經知道足夠多
這裡的設計關鍵,在於「request size」對 RDMA 不是一個必須額外猜測的欄位。
對 send/receive 或 one-sided RDMA 操作來說,work request 被 post 進 queue pair 時,RNIC 本來就必須知道 scatter/gather list、length、opcode 與 destination-related state,否則根本無法產生 packet stream。STORM 沒有要求應用程式再提供一個新的 deadline API,而是利用 datapath 原本就有的 request metadata。
同樣地,QP backlog 也不是額外 telemetry。RNIC 自己必須管理 send queue / work queue 的 pending work。真正新增的工作,是把這兩個已存在的訊號轉成 scheduling decision。
可以把它抽象成一個函數:
priority = f(remaining_size, qp_backlog)
這個函數不需要知道「這是一個 AllReduce」或「這是一個 RPC」。它只需要讓兩種 request 更容易被提升:
- 接近完成的 request:remaining size 小,完成成本低。
- 阻塞更多後續工作的 request:backlog 大,提早完成可能釋放更多 queued work。
這個想法的好處,是 scheduling policy 可以停在 RNIC 這一層。它不需要穿透到 application framework,也不要求 collective library、storage engine、RPC runtime 都改 API。
代價也很明確:NIC 看不到完整 dependency graph,所以它只能用 backlog 當 proxy。兩個 backlog 都是 16 的 QP,背後可能分別是高度關聯的 pipeline 與 16 個獨立 request;NIC 無法知道差別。STORM 的設計不是消滅這個 ambiguity,而是接受它,換取 deployment simplicity。
從兩個訊號壓成少量 priority,難點在量化而不是分類
論文摘要特別強調「small number of extra priority levels」。這點其實比看起來重要。
如果 scheduler 可以給每個 request 一個精確 rank,再要求 switch 執行任意精度的 packet priority,問題會簡單很多;但真實網路能用的 traffic class / hardware queue 數量有限,而且 queue 數越多,buffer accounting、QoS configuration、PFC/ECN policy 與 operational isolation 都更難管理。
因此 STORM 做的是 quantization:把一個理想上可能是連續值的 urgency,壓成少數幾個等級。
這會產生兩個誤差。
第一個是 classification error。兩個 urgency 很不同的 request 可能落在同一級,仍然只能公平競爭。
第二個是 boundary sensitivity。如果 threshold 設在 256 KB,一個 255 KB 與 257 KB request 可能被分到不同 class,但它們實際上幾乎一樣。
所以少量 priority 的價值不是「完美模擬 SRPT」,而是找到一個 operationally cheap 的 approximation。STORM 官方摘要能同時看到 cloud workload 與 LLM training 的改善,代表這個 approximation 至少沒有只對單一 flow-size distribution 有效。Politecnico di Milano research record
我會把這件事看成一個 hardware scheduling 問題:當 priority budget 很小時,policy 的重點不是算出最精確的 score,而是找出最值得保留的 ordering information。
這不是 congestion control,也不是 load balancing
很容易把 STORM 跟 congestion control 混在一起,但兩者其實回答不同問題。
Congestion control 問的是:這個 sender 現在應該以多快的 rate 送?
Scheduling 問的是:在 NIC 當下已經有多個 request 都能送時,哪個先拿到 transmission opportunity?
Load balancing 又是第三個問題:這些 packet 應該走哪條 path?
這三件事在實作上會互相影響,但控制變數不同。STORM 最有價值的地方,正是它沒有嘗試重新發明整套 transport,而是在 RNIC transmission arbitration 這個位置插入一個新的 ordering policy。
這與 pFabric 當年「decouple flow scheduling from rate control」的直覺有延續性,但 STORM 的 deployment point 不同。pFabric 的理想化設計強調 packet priority 與 switch behavior;STORM 則把更多 decision 留在 RNIC,並試圖只用 NIC 本地資訊完成。pFabric 原始論文
這個位置選得好,因為 application 不必改,但又比 switch 更接近 request boundary。Switch 看到的是 packet;RNIC 看得到 request。
一個簡單算例:為什麼「先完成」與「先解鎖」可以同時成立
考慮一個 100 Gb/s link,先忽略 protocol overhead。100 Gb/s 約等於 12.5 GB/s。
現在有三個 request 同時 ready:
- A:64 KB,backlog = 0
- B:8 MB,backlog = 12
- C:16 MB,backlog = 0
64 KB 在 100 Gb/s 上的 serialization time 約 5.2 μs;8 MB 約 0.67 ms;16 MB 約 1.34 ms。
如果三者等權 fair-share,A 雖然很小,仍可能因為與兩個大 request 交錯而把 completion 延後數倍。對平均 bandwidth 幾乎沒有影響,卻把短 request tail latency 拉高。
如果只做 shortest-first,A 很自然會先完成;但 B 因為 8 MB 比 C 小也會先於 C。這已經不差。
現在把 backlog 放進來,B 的價值又多一層:它完成後可能釋放後面一串 work。假設後續 12 個 request 中有部分屬於同一個 fan-out/join 或 collective phase,那 B 的完成時間會影響的不只是自己,而是 phase progress。
圖:作者假設算例;排程概念依據 STORM 與 pFabric。圖中時間線不是論文實驗資料。
這個算例也說明為什麼 STORM 不是單純的 size-based scheduling。Size 只知道「快完成」;backlog 補了一個「完成之後能解鎖多少本地工作」的 proxy。
官方結果很強,但要先看它證明了什麼
官方摘要給出的兩個 headline result 是:
- LLM training iteration time 最多降低 12%。
- average 與 P99 flow completion slowdown 最多降低 90%。
這兩個數字不能混在一起解讀。SIGCOMM 2026 官方 program 與 Polimi research record 都把它們列為「up to」結果。
90% reduction 主要說明,當 workload 中存在明顯 request-size diversity 或 dependency-sensitive queueing 時,fair sharing 可能離好的 scheduling 很遠。12% training iteration improvement 則是另一種量級:AI training 的 step time 除了 network,還有 compute、kernel launch、memory、collective algorithm 與 synchronization overhead。即使 network scheduling 改善很多,最後映射到 iteration time 通常也會被其他部分稀釋。
會議期間的 SIGCOMM’26 scribe note 提供了更多細節,但這是二手會議筆記,不應與原論文同等視為 primary source。該筆記轉述作者使用 128-host、100 Gb/s spine-leaf simulation,並在 80% load 的一個案例中把 average / P99 slowdown 從 9.560 / 43.571 降到 1.230 / 6.355;也轉述 collective microbenchmark 對 AllReduce、ReduceScatter 有約 10% 與 15% 的最高改善。這些數字很有參考價值,但正式引用仍應回到 paper 本身。
另一個重要點是,官方摘要明確說明作者做了 FPGA NIC prototype,且 overhead negligible。這至少排除了「只能在 simulator 裡跑 scheduler」這種最基本的疑慮;但摘要沒有提供足夠資訊讓我們判斷,在 400/800 Gb/s merchant RNIC 上,queue state lookup、priority remap 與 arbitration 是否仍然維持同樣的 timing margin。因此我不會把 FPGA 可行直接外推成 production ASIC 成本已經解決。
in-order RoCEv2 是 STORM 最容易被低估的限制
如果 transport 可以接受 packet reordering,scheduler 想改 priority 比較自由。
但經典 RoCEv2 deployment 通常仍高度依賴 in-order delivery。這會讓 request promotion 變得棘手:同一個 QP 的 packet 如果在傳輸途中突然被切到不同 priority queue,而不同 queue 的排隊時間不同,就可能讓後發 packet 超過先發 packet。
官方摘要只說 STORM 同時支援 in-order RoCEv2 與 newer reordering-tolerant RDMA stacks;SIGCOMM scribe note 進一步轉述,in-order 版本採取較保守的 promotion guard,避免 scheduler 自己製造 reordering。
這裡反映的是一個很典型的硬體設計邊界:priority 本身不是免費的 metadata。只要 priority 會改變 packet 所經過的 queue,它就會碰到 ordering semantics。
因此 STORM 的效果,不只取決於「urgency function 算得準不準」,還取決於 transport 能容許 scheduler 多激進地改變 queue placement。
三個 failure mode 比 headline 數字更值得追
第一個是 priority collapse。
當大量 sender 都用相同規則,把「最急」request 推進最高 priority,最高 class 最後仍可能變成新的公平共享 queue。此時 scheduler 的辨識能力被壓回去。priority class 數量有限,這個問題本質上不可能完全消失。
第二個是 proxy mismatch。
QP backlog 大,不等於 application criticality 高。一個 bulk transfer pipeline 可能長期 backlog 很深;另一個只有一個 request 的 RPC,卻可能位於使用者請求的 critical path。STORM 選擇不要求 application hint,因此一定會承受這種資訊損失。
第三個是 fairness drift。
如果某類 workload 天生產生大量短 request,或者長期形成高 backlog,它可能系統性得到較高 transmission priority。只看 average FCT 可能很好,但 multi-tenant cloud 還要看 tenant-level fairness、bandwidth guarantee 與 admission policy。官方摘要沒有證明這些 operational policy 已經被完整處理。
這三點都不是否定 STORM;相反地,它們界定了 STORM 的適用範圍:它是一個用極低 semantic cost 換取明顯 scheduling gain 的 approximation,不是一個全域 optimal scheduler。
對 AI collective 的意義:straggler 形成的位置往 RNIC 靠近
AI training 最值得注意的不是「12%」本身,而是改善出現的位置。
Collective communication 的 step time 往往由最後幾個完成的 dependency 決定。當一個 RNIC 上同時有多個 communication request,如果 scheduler 可以讓 near-completion 或 backlog-blocking request 更早完成,它實際上是在降低 local communication DAG 裡的 straggler probability。
這裡不需要強行把它上升成 application-aware network。STORM 的設計反而證明,有些 dependency-aware 效果可以由非常弱的 local signal 近似出來。
但這個推論有邊界。
如果 workload 是高度對稱的大型 elephant collective,每個 QP 都有相似 size、相似 backlog,scheduler 幾乎沒有資訊優勢;所有 request 看起來都一樣急。STORM 最有利的環境,應該是 workload heterogeneity 足夠高,或者同一 NIC 上不同 QP 的 blocking state 差異夠大。
換句話說,STORM 的收益來源不是「AI」這個標籤,而是 heterogeneity + dependency。
我的判斷
第一,RNIC scheduling 會變成 AI datacenter network 一個更獨立的設計維度。過去大家把注意力集中在 congestion control、adaptive routing、packet spraying;STORM 顯示,即使 path 與 sending rate 都不變,只改 request service order 仍有可觀收益。
第二,最值得研究的不是增加更多 priority,而是找出最小充分訊號。STORM 用 size + backlog 已經得到很強的結果。如果再加入 completion probability、collective phase、deadline 或 tenant class,效果可能更好,但 deployment cost 會快速上升。真正困難的是找到資訊增益與介面成本的 Pareto frontier。
第三,reordering-tolerant RDMA transport 可能讓這類 scheduler 更有空間。這不是說新 transport 一定比較快,而是 ordering constraint 放鬆後,scheduler 可以更自由地改變 packet priority 與 transmission order。這一點值得和未來 UEC、multipath RDMA 類設計一起看,但目前仍是架構推論,不是 STORM 論文已證明的結論。
第四,production ASIC 的真正問題會落在 arbitration timing、per-QP state scale 與 QoS isolation。FPGA prototype 證明演算法不是純 simulation artifact,但還沒有回答 800 Gb/s 甚至更高 line rate 下,scheduler state machine 是否能在功耗、SRAM access 與 critical path 上維持便宜。
接下來真正值得驗證的問題
我會優先追四件事。
其一,STORM 與 modern congestion control 疊加後,priority promotion 是否會放大某些 queue 的 burst,進而改變 ECN marking 或 PFC behavior。
其二,當數萬 QP 共存時,per-QP backlog state 的讀取、更新與 arbitration 是否仍能在 RNIC pipeline 裡以固定成本完成。
其三,多租戶環境如果需要 bandwidth guarantee,urgency scheduling 要如何和 tenant-level weighted fairness 共存,而不讓短 request workload 長期壓制 bulk tenant。
其四,在真正的 LLM expert parallelism、pipeline parallelism 與 disaggregated KV/cache traffic 混合環境中,size + backlog 這兩個訊號還能保留多少 correlation。這會決定 STORM 是一個漂亮的研究結果,還是一個有機會進入下一代 RNIC scheduler 的 primitive。
STORM 最有價值的訊息,不是「NIC 可以再多一個 scheduler」。它把問題縮到一個更可工程化的尺度:當 request boundary、size 與 backlog 已經存在於 RNIC,資料中心不一定要等 application 把完整 dependency graph 告訴 network,才有資格做更聰明的 scheduling。
References
- STORM: Enabling Traffic Scheduling for RDMA — ACM SIGCOMM 2026.
- SIGCOMM 2026 Program: Datacenter Transport — RDMA & Congestion Control — ACM SIGCOMM, 2026.
- STORM research record — Politecnico di Milano, 2026.
- Enabling Traffic Scheduling for RDMA — University of Cambridge Systems Research Group Seminar, 2026.
- pFabric: Minimal Near-Optimal Datacenter Transport — ACM SIGCOMM 2013.
- STORM SIGCOMM’26 scribe note — community conference note; secondary source, 2026.