
AI collective 何時值得改接光路:相依步驟、壅塞與切換延遲的交點
把 AI 工作分散到更多 GPU,可以擴大可用算力與記憶體,但各顆 GPU 算出的局部結果仍須互相交換,才能推進共同的工作。例如,在使用 AllReduce 同步梯度的資料平行訓練中,每個參與者都要取得合併後的結果;若下一段計算依賴這個結果,資料交換就進入完成時間的 critical path。NCCL 的 collective 定義 說明了 AllReduce 如何把各 rank 的輸入合併,再讓所有 rank 取得相同結果。從系統角度看,增加 GPU 之後,必須一起考慮運算能力與結果交換所需的時間。
承接這些交換的一種基本架構,是在工作執行期間維持固定的實體連線。Collective algorithm 決定哪些 GPU 在哪一步交換資料,網路則透過既有鏈路與轉送路徑承載流量。這個分工有合理性:連線持續可用,通訊步驟可以重複執行,也不必在兩步之間等待實體網路重新接通。但 collective 的通訊夥伴可能逐步改變;固定拓樸能否有效承接每一步,取決於連線數、路由與共享鏈路的負載。
當每個 GPU 的可用 port 少於可能的通訊夥伴數,固定連線便無法同時為所有夥伴提供專用直達路徑。若拓樸較稀疏、且系統支援中繼轉送,某些步驟需要多跳傳送,多組交換也可能爭用同一條鏈路。提高每 port 的速率可以縮短傳送時間,但有限連線應如何分配,仍是另一個設計問題。這正是可重配置光互連值得研究的動機:若通訊需求有可預知的步驟,能否把有限的實體連線,在需要的時間接給需要的夥伴?
先看下面的四節點示意:GPU 先各自計算,再交換局部結果。固定 ring 中,藍色的 0→1→2 與橘色的 1→2→3 共用 1→2;改接後可為這兩組夥伴建立直達路徑,但下一批資料要先等路徑就緒。這只是刻意選定路由的教學案例,用來說明取捨,並非任何 AllReduce 都會產生相同競爭。
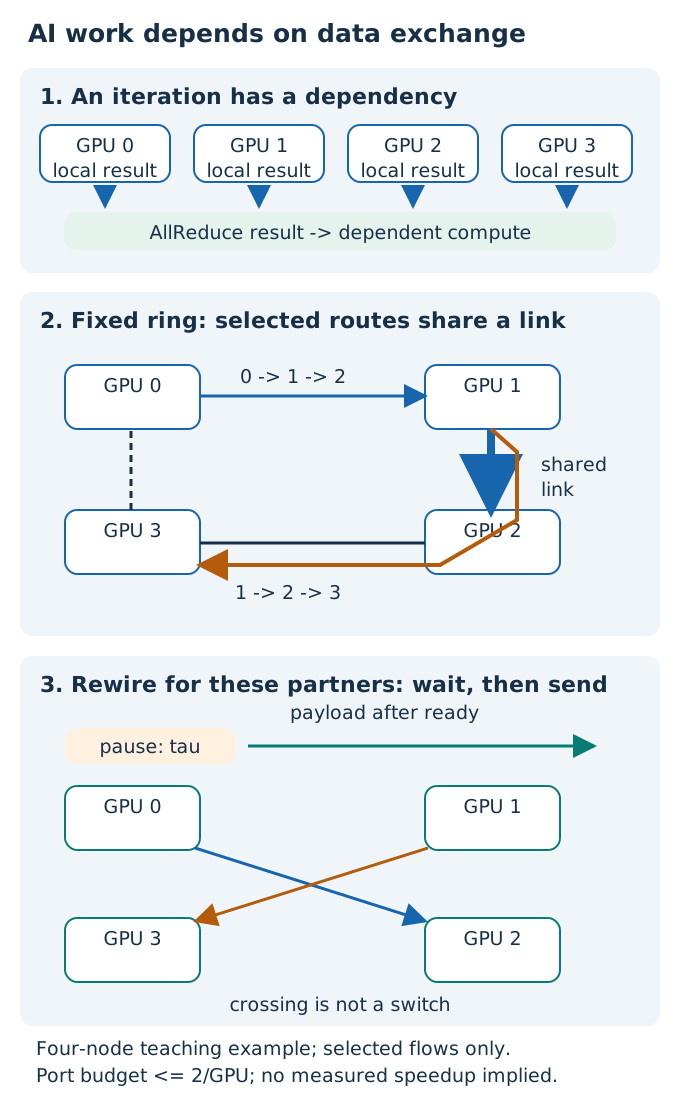
圖:作者設計的四節點背景示意,只畫出選定的單向流量,交叉線不代表交換節點;每 GPU 至多兩個 port,未使用的連線省略。概念依據:NCCL Collective Operations、Harvest。
光纖本身提供傳輸媒介;加入可重配置的光路,才讓系統能在執行期間改變端點之間的連線。這使網路多了一個設計自由度,也引入新的等待:受影響的舊交換須妥善收尾,光路與接收端須就緒,下一步才可安全開始。因此,較合適的拓樸不一定帶來較短的完成時間;它省下的多跳與壅塞時間,必須足以支付切換造成的停頓。
Harvest,SIGCOMM 2026 把這個取捨收斂成一個具體問題:在單一 scale-up 域內,給定 collective 的通訊步驟與每個 GPU 的有限 port,決定哪些連續步驟共用一張拓樸,以及何時值得改接光路。它的研究價值,在於讓 collective 的資料相依、拓樸的轉送負載與光路的切換時間,能放進同一個完成時間模型。如此才能比較增加 port、提高鏈路速率與改變連線時機各自能解決多少瓶頸。
核心判斷是:當實體連線可以隨通訊步驟改變,網路架構就需要同時決定頻寬的配置與配置生效的時間。切換越快未必就該每一步都換;連線越快,也未必能消除拓樸造成的競爭。以下從八個 GPU 的分階段 AllReduce 出發,追問哪些步驟值得共用連線,以及切換收益在什麼條件下足以抵銷成本。
固定拓樸為何會拖慢分階段通訊
AllReduce 讓每個參與者取得所有輸入的 reduction 結果;API 規定的是結果,沒有規定唯一的傳送順序或物理路徑,可對照 Open MPI 的 MPI_Allreduce 文件。實作會把交換拆成有相依關係的多個步驟。以八個 rank 的一種 recursive doubling 實作為例,夥伴依序可由 rank XOR 1、XOR 2、XOR 4 指定;第二輪送出的部分結果,需要先等第一輪完成。Open MPI collective 原始碼 可作此夥伴規則的參照。這只是展示依賴結構;Harvest 論文 分析固定 ring 時採用的是 cyclic variant,不能把兩種實作的實測結果直接混用。
先讓八個節點固定成一圈,每個節點的連線數不隨步驟增加。初期交換可能由近鄰直達,後期夥伴變遠,資料便要經過中間節點;多筆流量在同一條實體鏈路上重疊。Harvest 的八節點 ring 範例 中,第三步相對第一步的最大 congestion factor 從 1 增為 4。這個 4 是該拓樸與夥伴排程的鏈路競爭倍數,不代表任何八 GPU AllReduce 都必然慢四倍。端點 injection、routing、訊息長度與 collective algorithm 都會改變完成時間。
增加固定連線、改用更適合拓樸的 collective,或讓流量由 packet fabric 繞路,都可能緩解問題。Swing,NSDI 2024 便是最佳化固定 torus 上夥伴選擇的例子。光交換提出另一種可驗證選項:在下一組夥伴需要通訊前改變實體連線,把原本爭用同一個 cut 的 flow 分開。這個選項有代價:舊流要安全結束,新光路與接收端要就緒,所有參與者才可繼續。若連線數本來已足以同時容納主要夥伴,切換可省的時間就可能太少。
這也是 Mahir Rahman(Purdue University)等人的 Harvest,SIGCOMM 2026 值得研究的原因。它將「固定不換」和「每一步都換」之間的策略變成可求解的排程問題:給定 collective 的步驟與資料量,在每段連續步驟共用一張拓樸,選擇何時切換,最小化通訊與重配置的總時間。這個工作的長期研究價值,在於把 optical device 的切換時間、網路的 degree/forwarding 能力與 collective 的資料依賴放進同一個可反駁的成本式。這使「提高每 port 頻寬」與「改變連線時機」成為可比較的架構選項,也指出未來必須量測哪些參數。
Aggregate traffic matrix 丟掉的資訊
先考慮三個節點與兩筆等大的傳輸:A→B、B→C。假設 B 必須收到 A 的結果才能計算送往 C 的內容。另一個工作則是 B 早已備妥資料,兩筆傳輸可以同時開始。
這兩個工作有相同的 aggregate traffic matrix,卻有不同的 earliest start time。第一個工作若先把 circuit 接成 B→C,鏈路會等待尚未產生的資料;第二個工作若有足夠獨立 port,兩筆傳輸可以重疊。矩陣保留 bytes,沒有保留資料何時可用。
這是作者構造的反例:它不否定 traffic matrix 對穩態容量規劃的用途,而是證明相同矩陣不足以唯一決定有相依工作的最短完成排程。若一個 scheduler 已額外加入 release time 或 DAG,它就不再只有矩陣資訊,不能把它與純 aggregate scheduler 混為一談。
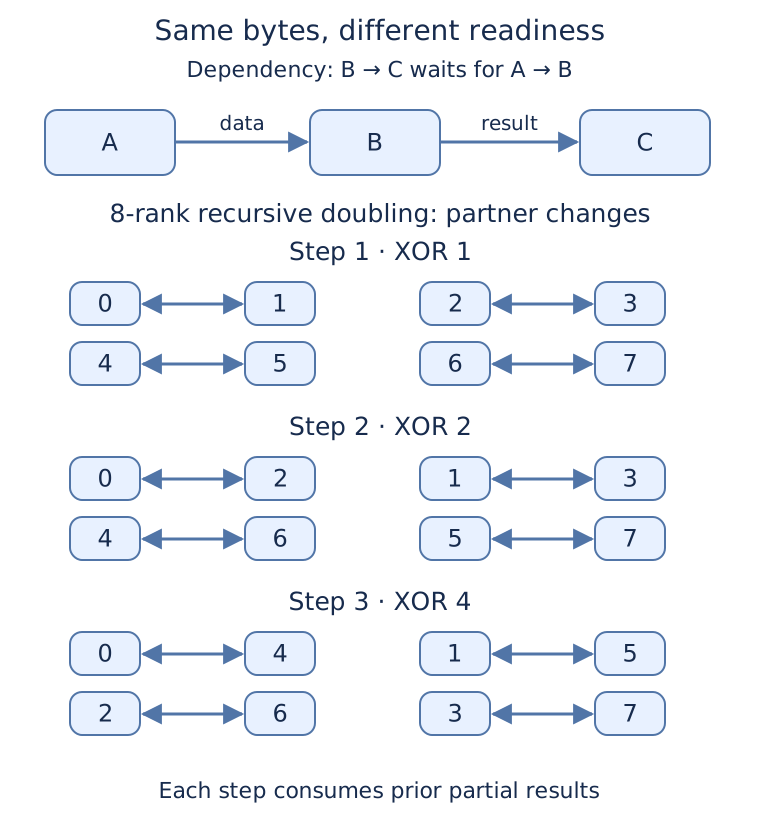
圖:作者整理;資料來源:Open MPI collective 原始碼。A→B→C 反例為作者設計。
直連、省 hop 與省時間是三件不同的事
若一條路徑跨越多個 endpoint,中間節點需要某種 forwarding 能力。這是要明確寫入系統模型的硬體要求,不能因為 GPU 都連上光纖,就假設任意 GPU 能像 router 一樣轉送其他 GPU 的資料。
對一個理想 cut-through 路徑,長訊息可以流水傳送;路徑有 h 個 hop,不代表最後一個 bit 的時間必然是 h×訊息序列化時間。但每條經過的鏈路都要承載 bytes,可能與其他 flow 分享同一個 bottleneck。相反地,若中間節點必須整塊收進 memory,再重新發送,store-and-forward 會把傳輸與 memory 操作串入 critical path。
以下採用作者的簡化流體模型。令第 i 步的 flow f 有 Dᵢf bytes,選定路由後流經 edge e 的量為 Lᵢe,該 edge 的有效 payload rate 為 Cₑ bytes/s。則:
Tᵢ ≥ maxₑ(Lᵢe / Cₑ)
這是容量下界,不是完成時間等式。若再用 startup latency αᵢ 與路徑延遲項 δᵢ 建立估計:
tᵢ(G) ≈ αᵢ + maxₑ(Lᵢe(G) / Cₑ) + δᵢ(G)
模型依賴已選的 route、可用容量與近似流水傳輸;沒有包含 packet burst、有限 buffer、reduction compute、流控死鎖或 receiver stall。最長路徑與最忙 edge 也可能不屬於同一個 flow,所以把各項相加只是保守近似的候選,不是一般定理。要用它做選型,必須先以 trace 校準。
在這個模型裡,新 topology 的價值有兩個來源:減少鏈路上的重複負載,以及縮短資料經過的 forwarding path。兩者都可能降低 step time,但都受 injection bandwidth、receiver rate 與 routing 實作限制。只要 endpoint 已經飽和,再增加 circuit capacity 就沒有同等收益。
固定拓樸仍有最佳化空間。Swing,NSDI 2024 探索在 torus 上改變 AllReduce 夥伴以降低 hop 與鏈路分享。它提醒我們:比較可重組 fabric 時,baseline 應包括合理的 topology-aware algorithm;否則測到的收益可能包含「修正不合適演算法」的部分。
把重配置當成一筆必須支付的時間
令 τ 表示完成一次 topology transition 後,受影響 communication 真正可恢復的時間。若六個通訊步驟依序執行,選擇的拓樸是 G₁…G₆,最簡單的 serialized objective 是:
T = Σᵢ tᵢ(Gᵢ) + Σᵢ₌₂⁶ τ · 1[Gᵢ ≠ Gᵢ₋₁]
此式假設切換不能與其他通訊重疊、切換代價固定、初始 topology 已預先就緒,且沒有跨步驟的並行 flow。若初始建立也計入,所有方案都應用相同規則;若其成本依目標 topology 改變,就必須逐一計算。
對單次切換,採用條件可以直接寫成:
後續通訊時間的減少量 > 暴露在 critical path 上的切換成本
「暴露」很重要。若另一組獨立 port 可在 computation 期間預先配置,只有未被重疊藏掉的部分需要支付;但當下 circuit 若仍被未完成 flow 使用,不能憑空把整段 τ 塞到 computation 背後。
一個更方便比較設備的無因次比值是:
ρ = τ / (D / C) = τC / D
D/C 是一次理想直連傳輸的序列化時間。假設 C=100 GB/s,τ=10 μs,則 D=1 MB 時 ρ=1;D=100 MB 時 ρ=0.01。這是十進位單位的作者試算,沒有包含 startup 或壅塞。相同 switch 在不同 message size 下,切換代價的重要性相差百倍;而 C 提升、τ 不變時,重配置反而更難攤平。
六步試算:最佳切換次數會隨 τ 改變
以下四張候選 topology 的每步完成時間以 μs 表示。成本已包含該步路由、startup 與 serialization 的估計,獨立作為輸入;它不是 Harvest 的輸出,也不是任何實體 OCS 的 benchmark。
| 候選 topology | 步1 | 步2 | 步3 | 步4 | 步5 | 步6 | 全程固定 |
|---|---|---|---|---|---|---|---|
| A | 14 | 14 | 20 | 20 | 14 | 14 | 96 |
| B | 10 | 10 | 12 | 12 | 22 | 22 | 88 |
| C | 22 | 22 | 12 | 12 | 10 | 10 | 88 |
| D | 22 | 22 | 10 | 10 | 22 | 22 | 108 |
只逐步選最低通訊成本,會得到 B、B、D、D、C、C:通訊60 μs,但要切兩次,總時間60+2τ。
若把中段也留在 B,直到最後兩步才換 C,通訊成本是64 μs,只切一次,總時間64+τ。全程固定 B 或 C 則是88 μs。把四個候選的全部4⁶=4,096種序列逐一計算,可以核對:
| τ | 最佳成本 | 一個最佳序列 | 原因 |
|---|---|---|---|
| 1 μs | 62 μs | B B D D C C | 兩次切換值得支付 |
| 10 μs | 74 μs | B B B B C C | 放棄中段4 μs收益,省一次切換 |
| 30 μs | 88 μs | B B B B B B | 保持固定 topology |
三個下包絡線60+2τ、64+τ、88在τ=4與24 μs交會。邊界上有多個等價最佳解;不能把某個單一 schedule 宣稱為唯一答案。若 τ 的估計誤差足以跨越交點,選擇較少切換的方案通常更容易操作,但這是 robustness policy,要另外算收益代價。
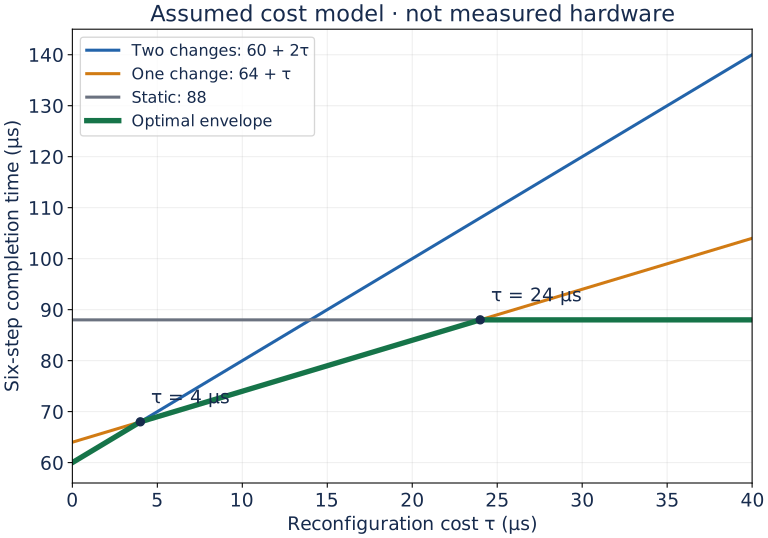
圖:作者整理;資料來源:Harvest 的排程問題。曲線與所有數值為作者假設試算,非論文實驗圖。
這個有限候選問題可以用簡單 recurrence 求解。令 Fᵢ(g) 是前 i 步、末步使用 g 的最低成本:
F₁(g)=t₁(g)
Fᵢ(g)=tᵢ(g)+minₕ{Fᵢ₋₁(h)+τ·1[h≠g]}
存下 predecessor 就能回推 schedule,時間複雜度為 O(S K²),S是步數、K是候選數。這是上述作者模型的 exact solver;它只證明在這些候選與成本中最優,沒有替所有可能的 degree-bounded topology、routing 或 collective algorithm 找到全域最優。
若兩張圖的 transition cost 不同,用 τ(h,g) 替代常數即可;若有尚未送完的 packet、重疊 computation 或 buffer occupancy,F的state必須包含這些資訊。只保留末張圖,便可能把未來影響不同的兩段歷史錯當成同一個 state。
Port 與 cut 的下界,限制排程能救多少
前述成本表刻意把topology成本當輸入。若要從硬體直接估計,還要檢查兩個下界。對節點v,若它必須發送Dᵥ bytes、只有d個可同時使用的port,每個payload rate為C,則單靠injection就需要至少Dᵥ/(dC)。任何切換都不能把這個下界降掉,除非增加port或減少資料量。
對一個節點集合U,令本步必須離開U的資料為D(U),跨cut的所有可用鏈路容量合計為C(U)。在沒有壓縮或in-network reduction改變資料量的假設下,完成時間至少D(U)/C(U)。重配置能把有限port重新分配到忙碌cut,但提高一個cut的capacity,可能同時縮小另一個cut;不能只檢查被最佳化的那組夥伴。
這也說明bandwidth density與schedule是不同設計旋鈕。更多port能讓多組夥伴同時存在,降低切換需求,卻增加transceiver、光纖、package escape與控制成本。更快的單port保持degree限制,可能讓序列化更短,反而放大τ的重要性。比較方案時應把port數、port rate、切換domain與endpoint forwarding能力列成四個獨立欄位。
還有一個可直接量測的resource overhead:若某sender在切換時繼續產生資料,輸入速率λ、暫停服務時間τ,且沒有其他出口或上游backpressure,buffer最低增量是λτ。以100 GB/s與10 μs的假設值,增量是1 MB;若八個流共同落到同一buffer,必須按合計arrival rate計算。這不是平均queueing分析,也不是buffer sizing的完整答案,但已足以檢查一個「切換期間照常發送」的設計是否自洽。
Harvest 的證據成立在哪個範圍
依 Harvest 原文,§3.1、§6.1與Figure 6,模型假設 endpoint 具備 cut-through forwarding。論文分開採用 8–64 GPU、每 port 800 Gb/s 的 packet-level 模擬與數值求解,以及 8 GPU、BlueField-3、100 Gb/s optical transceiver 的硬體模擬。後者透過 GPUDirect RDMA、NIC eSwitch 與分步執行 NCCL 量測通訊時間,再加上設定的固定重配置 penalty。論文報告跨多種 collective 的最高約 2 倍改善,是與 static 或每步切換兩種策略中較好的 baseline 比較;這是特定模型與參數空間的最高值;硬體實驗採用可重配置互連的 emulation,不能把固定 penalty 當成已量測的光路端到端切換時間。
這個方法能檢查通訊成本趨勢,卻不能同時證明光路失鎖、receiver recovery、所有port重配置成功率或長時間運作可靠性。把模擬的 τ 從10 μs改成10 ns,也不會產生一套已經量測過10 ns恢復的硬體系統。
公開artifact 提供synthesis、Astra-Sim、hardware-emulation與compute-sync路徑,並說明一般topology synthesis需要Gurobi;現成topology可以用於模擬。復現時應分開記錄「重新求解排程」與「重播既有排程」,兩者驗證的能力不同。這裡沒有宣稱已完整執行該artifact。
Optical switching time 不能直接填入 τ
Deeksha P Rao(Purdue University)的公開研究頁 把重配置延遲視為request到communication恢復的端到端屬性,包含host/controller、控制處理、電訊號與光切換。頁面標示的是HotNets 2026、11月的工作;在9月的此時,只能視為作者已公開的待會議呈現工作,不寫成會議已完成。
以下是一條作者設計的保守控制路徑:停止受影響的發送、確認舊flow完成、發出新epoch設定、等待optical與receiver就緒、核對所有必要port、再允許新step進入。每一項未必串行;實際τ應取這些事件的critical path,不能把能重疊的項目重複加總。
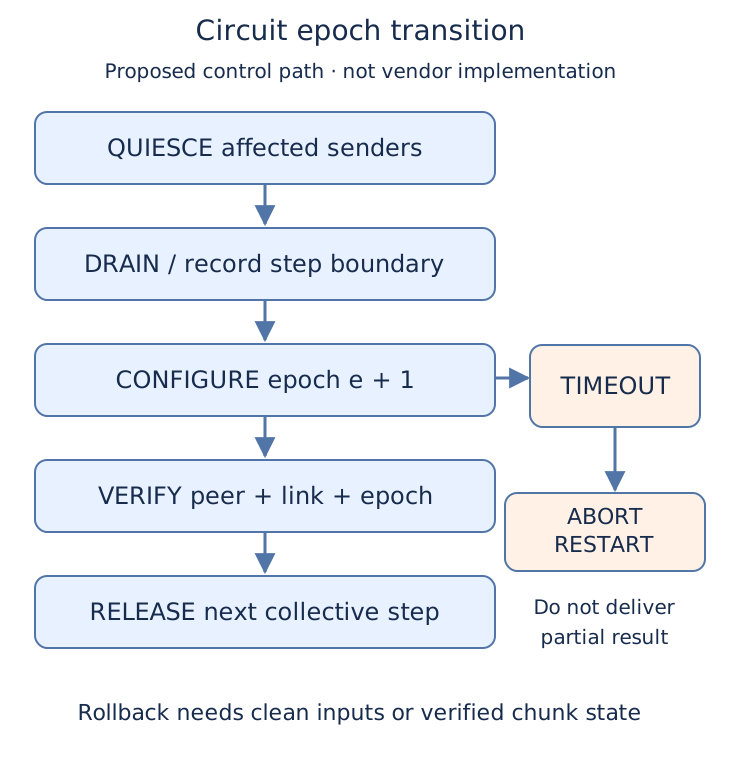
圖:作者整理;資料來源:端到端重配置研究問題。epoch、驗證與失敗處理為作者設計,非廠商官方實作。
量測起點若放在controller送出command,會漏掉request排隊;終點若放在switch ACK,則可能早於payload真正可傳。選型至少要同時記錄device時間、request-to-ready時間、p50/p99,以及切換時可繼續服務的port比例。當job每輪通訊都必須等待最慢參與者,平均τ也不能直接代表job看到的暫停。
一次部分失敗,會留下哪些狀態
假設B→C的切換只有部分port成功。controller認為epoch e+1已發布,但其中一個receiver仍停在舊設定;部分endpoint開始送下一步,其餘endpoint仍等待。
在作者設計的恢復方案裡,首先需要把「配置已送出」與「資料可安全進入」分開。每個受影響endpoint回報epoch、peer identity與link readiness;完整參與集合尚未確認前,runtime不放行。超時後停止該operation,保存已完成step與未完成step的界線。
尤其reduction已覆寫buffer時,不能只恢復舊circuit後重送全部資料。某些貢獻可能已納入partial result,重送會重複加總;若無法證明chunk完成state,安全策略是從未被污染的輸入或checkpoint重啟collective。代價是多一次通訊,保證則是避免把半完成結果交給上層。
fallback也要有資源:預留packet fabric會增加成本;原地保留舊topology需要port與切換能力;直接abort job則降低局部恢復複雜度,但擴大failure domain。這些是三種不同設計,沒有免費的第四條路。
採用時要比較的三個方案
| 設計 | 主要收益 | 要付的成本 | 比較有利的條件 |
|---|---|---|---|
| 固定packet fabric+適配collective | 容許較多即時交通變化 | port、buffer、routing與功耗預算 | concurrent jobs多、流量難預知 |
| 固定optical topology+多hop | 避免執行途中切換 | endpoint forwarding與路由負載 | 夥伴穩定、切換成本高 |
| 依step重配置optical topology | 在需要時建立更合適路徑 | synchronization、transition與recovery | 步驟可預知、獨占資源、收益可攤平 |
此表是作者的工程比較,必須在相同endpoint bandwidth、port數、可用容量與故障要求下驗證。若可重組方案多出一組完整光學鏈路,就不能只把完成時間改善歸因於排程。
另一個邊界是完整job。collective縮短不必然等比縮短iteration;若通訊原本就被computation遮住,最佳化可能只增加idle gap。Flux,2026年9月22日arXiv preprint 進一步用workload DAG、compute dependency與switch assignment共同排程;其目標涵蓋計算與通訊的共同排程,應與本文固定 collective 步驟的問題範圍分開比較。
我的判斷與下一個可驗證問題
以下三點是作者推論。
第一,可重組interconnect的採用門檻會隨message size、effective bandwidth與端到端τ共同移動。設備資料表應能對應到這個三維空間;只有lane rate與一個switching time,資訊不足以決定runtime策略。
第二,最先值得投入的場景是通訊步驟穩定、資源隔離清楚、可重複使用排程的domain。這能讓offline synthesis攤平,也讓failure recovery的state範圍可管理。多租戶或動態MoE traffic不是不能做,而是需要不同的state與不確定性模型。
第三,optical schedule可能成為runtime contract的一部分。tensor size、rank mapping、algorithm、topology version或forwarding能力改變時,舊schedule應重新驗收;只保存一串switch command,無法證明它仍對目前的communication DAG有效。
下一步最值得測四件事:以真實request-to-payload-ready分布替代固定τ後,最佳分段方式是否穩定;注入一個port延遲或失敗,能否阻止partial reduction被錯誤交付;與最佳化過的固定fabric及collective比較後,仍剩多少收益;加入computation overlap與第二個job後,整體iteration p99是否改善。
可長期保留的insight是:通訊需求除了「多少bytes、送給誰」,還包括「何時產生、依賴誰、切換後何時可安全繼續」。當topology可被程式改變,這些時間與正確性資訊便成為網路架構輸入。
References
- Harvest: Adaptive Photonic Switching Schedules for Collective Communication in Scale-up Domains — Purdue University / Microsoft Research, SIGCOMM, 2026.
- Harvest Experimental Artifacts — STyGIANet, 2026.
- MPI_Allreduce — Open MPI, online documentation.
- AllReduce Collective Implementations — Open MPI, source code.
- Swing: Short-cutting Rings for Higher Bandwidth Allreduce — NSDI, 2024.
- What Is Reconfiguration Delay, Really? An End-to-End View of Photonic Switching — STyGIANet, public research page; HotNets 2026 work scheduled for November.
- Flux: Optimal Scheduling of Optical Circuit Switches for LLM Training — University of Antwerp / imec, arXiv preprint v1, 2026.
- Collective Operations — NVIDIA, NCCL User Guide, online documentation.