
讓 EDA Agent 從失敗案例學習,先把診斷 skill 送進離線回放
重點
- EDA 平台團隊
- EDA 平台團隊可把已解決失敗轉成具工具版本、設計階段與反例條件的診斷 skill,先改善下一步查核的選擇;代價是要維護案例來源、判定方式與撤回紀錄,累積的經驗才有可比較的效益。
- ACE
- ACE 以條目與增量更新保存經驗,提供逐條修正的機制參考;移到晶片設計流程時,每條經驗仍須綁定適用範圍與獨立回放結果,避免某次偶然成功變成跨專案通用規則。
- 晶片驗證與實作工程師
- 晶片驗證與實作工程師保留根因、有效處置與正式設計修改的判定責任,讓 Agent 先安排低成本查核;當資料不足或工具語意改變,明確交回人工可減少錯誤重跑,卻會降低自動處理覆蓋率。
- 診斷服務維護者
- 診斷服務維護者應同時量測答覆正確率、棄答率與錯誤處置成本,並把評估綁定不可變的 skill bundle;只追求較高分數會鼓勵過度棄答,只追求更多自動化則可能放大昂貴的工具誤用。
EDA Agent 可以先從選對下一項診斷檢查,累積可量測的能力。把歷史失敗寫進記憶時,應同時保存它成立的條件、反例與可撤回的版本;這樣,新的 run 才能借用經驗,又保留對陌生情況的判讀空間。
考慮一次 synthesis 失敗:Tcl 執行結束,log 留下找不到 cell 的訊息,產出的 report 也不完整。工程師原本會比對 RTL 清單、library 載入紀錄、elaboration 狀態與工具版本,逐一縮小原因。若 Agent 直接從向量搜尋找到「上次補一個 library path 就好了」,便可能在錯誤方向上多花一次工具工作。當另一個專案使用不同的 wrapper 或 log parser,同一句錯誤更可能指向另一條路徑。
最近的 BTTF 研究拆解處理了如何查詢 waveform 與定位訊號。本篇接續的問題是跨 run 的經驗使用:資料查得到之後,哪些舊診斷值得拿來指引新工作,哪些應留在歷史紀錄?下面以 ACE 與 GEPA 的公開機制為參考,提出一個用於診斷服務的設計;案例、schema 與測試皆為公開可重現的合成內容。
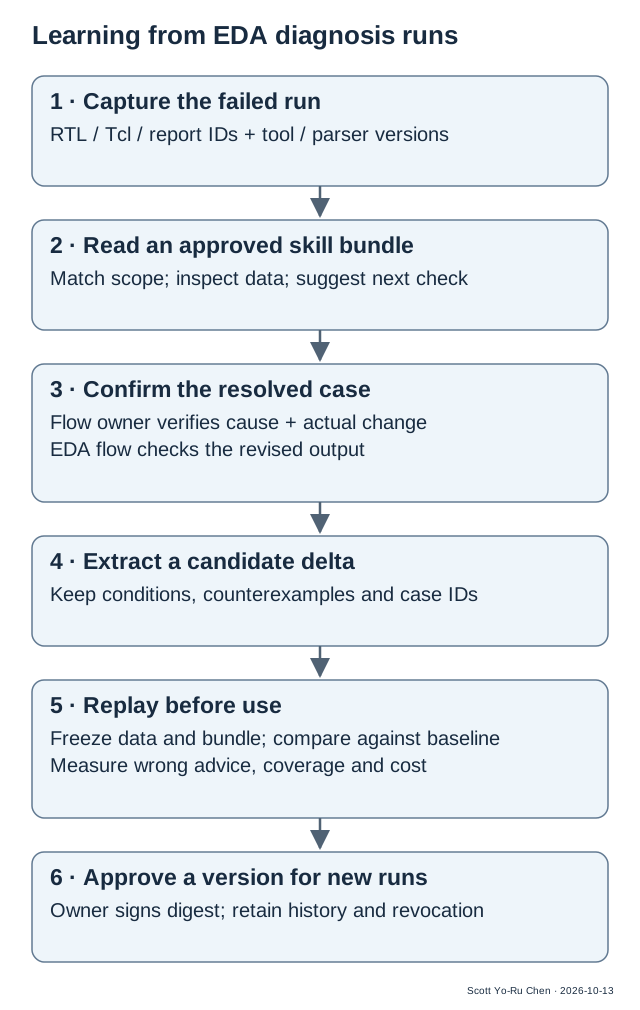
先沿圖一看兩條不同路徑:正在失敗的 run 消費已核准的 skill,已解決的 run 則產生候選經驗。中間的離線回放讓新經驗先接受比較,再進入下一次診斷;設計修改仍由既有 flow 與工程師處理。
每次成功都寫進記憶,會累積無法重現的結論
「重新執行後成功」可能包含多個同時變動:license 釋出、檔案系統恢復、工程師修改路徑,或新的 RTL 消除了前一個錯誤。如果紀錄只剩一句處置摘要,下一個 Agent 容易把時間先後當成因果。平台因此需要保存成功之前有哪些觀測、實際改了什麼,以及哪些替代原因已經被排除。
這裡可以借用早期研究的方向。2023 年 Noah Shinn 等人的 Reflexion把回饋轉成語言反思,再提供給後續嘗試,主要改變的是上下文而非模型權重。對 EDA 的啟發是經驗能作為下一次診斷的輸入;根因標註與設計正確性仍需另外建立。
2025 年 10 月 6 日的 Qizheng Zhang/Stanford 等人提出 ACE v1,將產生軌跡、反思與整理分開,經驗以具識別與 helpful/harmful 計數的條目保存,更新採局部 delta,再由程式合併。這適合拿來思考逐條修正、去除重複與保留細节。ACE 現已有 2026 年 3 月 29 日修訂的 v3;本篇數字與機制比較固定引用 v1,以免混用版本。
v1 的 AppWorld Table 1 在 DeepSeek-V3.1 與官方 ReAct 設定下,四個 TGC/SGC 欄位平均由 42.4 升至 59.4,對應有標籤的離線 ACE,增加 17.0 個百分點。這是指定任務及評量方式的 reported result,與 EDA diagnosis 的正確率、PPA 或工具成本有不同分母。原始表格與設定
Lakshya A. Agrawal 等人的 GEPA則從推理、工具呼叫及輸出軌跡反思,產生並測試候選更新,保留在不同任務上有優勢的候選。原始發表是 2025 年 7 月 25 日,本文參考 2026 年 2 月 14 日 v2 的方法描述;其 benchmark 勝出只適用於論文比較條件。本篇借用候選分開評估的做法,未執行 GEPA 的模型最佳化。
兩種機制可以各取所需:用條目式保存避免整包經驗反覆重寫,用候選比較決定哪些修改適合上線。EDA 平台再補上一層領域條件,讓記憶知道自己對哪種工具輸出有用。這項工作會把資深工程師原本口頭傳承的判讀順序,轉成可回放、可問責的資料;工程師付出的整理與審查時間也會增加,應列入效益計算。
一條 skill 必須指向可觀察的下一步
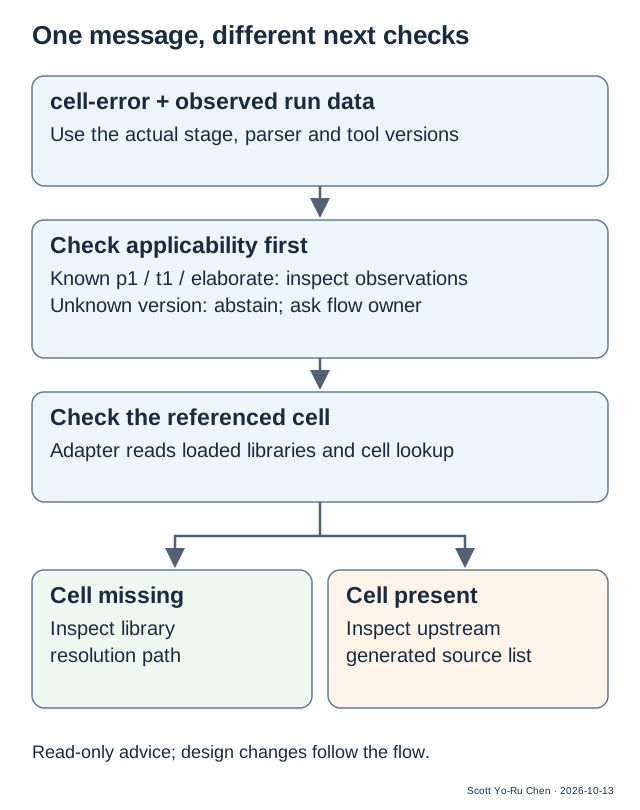
以下參考設計把診斷 skill 限定為三個部分:在什麼情況適用、下一步取得什麼資料,以及觀測不同時如何分流。早期的輸出是唯讀查核建議,既有腳本負責真正的設計修改。
例如「找不到 cell」經驗可保存成以下片段。名稱與版本都是合成的,support 來自 library 載入紀錄與 cell lookup 的交叉檢查,由 adapter 提供;它沒有讀取測試答案。
skill_id: library-resolution-check
revision: 2
scope:
  tool_build: t1
  parser_schema: p1
  failed_stage: elaborate
trigger: cell-error
required_observations:
  - loaded_library_manifest
  - referenced_cell_lookup
  - generated_source_list
positive_route: inspect-library
counterexample_route: inspect-upstream
allowed_actions: [read_manifest, query_cell, inspect_source_list]
owner: flow-methodology-owner
若 cell lookup 確认所需 cell 沒有出現在核准 library 清單,先查 library 解析路徑。若 cell 已存在,就轉查 generated source、wrapper 參數或 upstream 失敗。兩條路徑都從資料差異推進,不直接根據錯誤字串修改環境。
這比「遇到錯誤就補 library」多保存了反例,也讓同一條記憶可被修正。若未來 parser p2 將 warning 與 fatal error 合併,舊規則先停用於 p2;新版本的 adapter 測試通過後,再建立相容宣告。版本篩選會減少可自動處理的問題,但保住診斷的已知適用範圍。
條件也有成本。把每個 tool patch 都視為完全不同的範圍,會產生大量規則;全部視為相容,又會漏掉訊息語意改變。較合理的方式是先採精確版本,累積差異測試後才合併已確認相容的版本集合。相容宣告由 flow owner 管理,不由模型因為文字很像而自行擴大。
Skill 的權限則要與內容分開。查 cell、讀 report、比對 digest 可以屬於診斷服務;改 SDC、換 library、刪 checkpoint 或重排大量 jobs 是另一個獲授權的操作。這延續 Cadence 2026 年 10 月 7 日的公開說明:AI 產物是 engineering input,核准的 intent 與工具檢查仍持有工程判定;sandbox 控制可做的事,模型的解釋本身不提供 signoff。
從一個 synthesis 失敗走到下一版診斷
完整案例從一個 DMA block 的 synthesis run 開始。參考設計先把 RTL revision、Tcl recipe、核准的輸入清單、tool build、parser schema 與 report 路徑綁到 run R42。這些是診斷可讀取的公開式資料物件;library 只引用已授權來源的識別,不把內容匯出到記憶庫。
R42 在 elaboration 失敗。第一次診斷讀到 cell-error,從已核准 bundle v1 取得 library 查核 skill。Adapter 回傳 library 已載入、該 cell 可查到,卻發現 generated source list 沒列出新 wrapper。此時 library hypothesis 被削弱,Agent 建議查 upstream 產生與引用清單,而不是再提交一次相同的 synthesis。
工程師確認 wrapper 的產物未被加入該 run 的固定清單,修正受控 recipe,形成新的候選 run R43。Synthesis 成功之後,還要完成原本要求的 netlist 檢查與必要功能/等價檢查;每份結果記錄對應輸入。R43 通過這些既定檢查,才把事件標為已解決。診斷猜中與設計交付合格是兩個不同的測量。
學習管線接著取 R42 的可見觀測、工程師確認的根因、R43 的差異與結果,生成 skill v2 候選。新增內容是「cell 已存在時轉查 upstream 清單」的反例分流;原本的正向 library 缺漏路徑保留。原始 run 的失敗時間與診斷紀錄保持原樣,讓日後能知道 v1 當時提供什麼,以及 v2 改了哪項判讀。
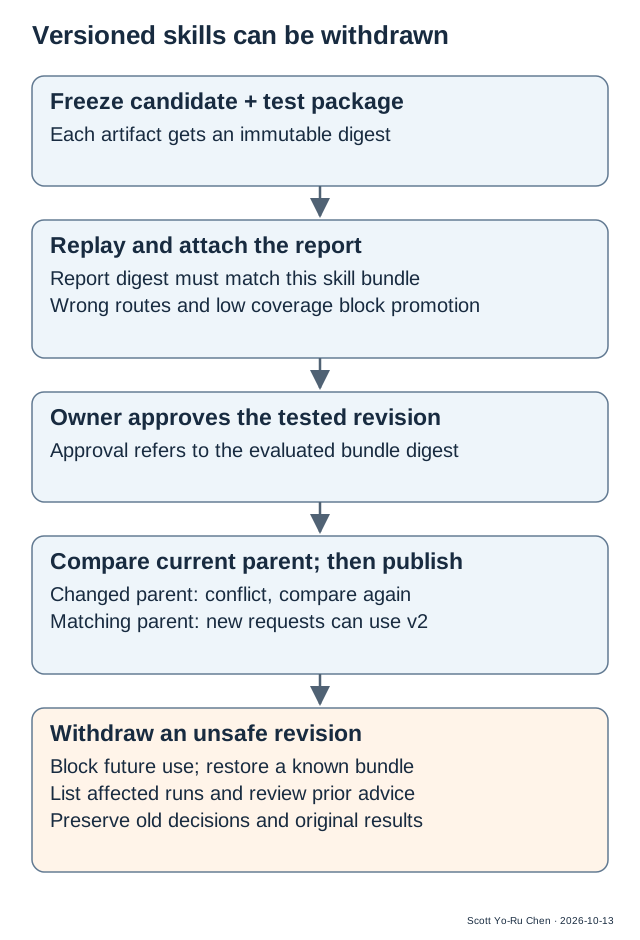
離線 runner 用固定輸入重播診斷階段,輸出先與人工定義的下一步查核比較。通過後,owner 核准整個 skill bundle 的 digest;服務在下一個請求邊界讀取新版。已在進行的診斷留在 v1,直到結束或明確重新啟動,避免對話前半段與後半段使用不同的方法。
這條路徑能逐步自動化經驗萃取、搜尋與比較。它也保留人工責任的實際位置:根因確認、反例的語意、版本相容,以及由診斷推進至設計修改。若團隊尚未整理已解失敗的前後資料,先建立這份紀錄通常比直接增加模型回合更有用。
回放要阻止重複案例和事後答案偷渡
歷史案例常有多次 rerun。同一個失敗設計改了 seed,產生二十份幾乎相同的 log;若隨機切成訓練與測試,模型可能只記住錯誤片段,卻被誤認為跨設計泛化。資料切分應以根因事件及設計家族分組,再另做工具世代與時間上的測試。
萃取經驗的集合提供已解根因,開發集合供候選比較,鎖定測試集合只用於最後評估。若看過測試錯誤後修改規則,該集合就已進入開發資料,需要重新建立未用過的測試。凍結 skill、adapter、模型版本與案例清單的 digest,能知道每個分數究竟評了哪一個系統。
回放的 context 也只能含診斷當時看得到的資料。例如最終問題單的「wrapper 清單漏項」可作 gold label,卻應從模型輸入移除;修正後 R43 的成功 log 同樣只供結果核對。否則記憶搜尋只需讀到答案,正確率便失去意義。工具無法重現舊資料時,該案例要記為不可回放,不能把它計入成功。
除了正向失敗,還需要近似但原因不同的案例:license 已取得卻殘留舊 checkout warning、cell 可查到卻缺 generated source、輸入 revision 已匹配卻載入了前次 report。這些案例測的是經驗會不會過度套用。也要加入未知 schema、讀取權限不足與資料缺漏,測服務是否會交回人工。
評量至少同時呈現三個數字:已答覆案例的正確比例、答覆覆蓋率,以及全部案例得到正確建議的比例。只看第一項,永遠棄答的服務可能看似安全;只看第二項,毫無分辨地套用規則也可能看似自動化成功。另計每次診斷的查詢數、耗時、工程師改判次數與引發的無效重跑,才能判斷新方法是否值得維護。
合成測試展示適用條件的代價
本篇附的 Python 實驗已實際執行。程式先從三個正向訓練案例建立規則:checkout、cell 與 revision 錯誤各自對應 license、library、input 查核;三個開發反例再提供前提不成立時的 upstream 路徑。候選 v1、v2 都形成後,才評估十二個測試案例。
這十二個案例是六個適用正例、三個反例,以及三個未知 parser schema。不同分組使用不同設計家族名稱,但案例均由同一套合成規格編寫,規則結構共通;這是可執行的協定測試,沒有統計上的泛化證明。它沒有呼叫 LLM、讀取 PDK、執行 simulator 或 synthesis,也沒有產生真實晶片根因。
| 診斷策略 | 正確建議 | 錯誤建議 | 棄答 | 答覆覆蓋率 | 已答覆正確率 | 全部案例正確比例 |
|---|---|---|---|---|---|---|
| v1 只比對訊息 | 6 | 6 | 0 | 100% | 50% | 50% |
| v1 加版本與正向條件 | 6 | 0 | 6 | 50% | 100% | 50% |
| v2 納入開發反例分流 | 9 | 0 | 3 | 75% | 100% | 75% |
原始輸出保存於 results.json,每筆有預期路徑、實際建議與狀態。測試組 digest 為 ab698b6d55e97d406a7baceb9965b1f80e6217c939d3e9d6d71c3760d9d50178;凍結的 v2 bundle digest 為 ef6d7794dfa81983c907176376a8f897306f7f57f0fb8b3bf0e34501337837d5。
第一個改善來自拒絕在前提不成立時套用規則,代價是更多人工判讀。第二個改善來自保留反例的下一步查核,讓三個案例從棄答變成有用建議。陌生 p2 仍交回人工。這些結果只證明程式按設計分流,沒有測出 ACE、GEPA 或某個模型的真實效果。
相同程式還跑了五個發布操作:錯誤 bundle digest 的評估報告被拒絕、v2 正常晉升、沿用 v1 作 expected parent 的第二次晉升被判衝突、撤回 v2 後回到 v1,以及拒絕重新使用已撤回 v2。這是單程序內的狀態模型;儲存交易、服務崩潰與多機競爭尚未實作,不能將它稱為分散式原子發布。
錯誤 skill 的影響要能追到正在使用它的診斷
較嚴重的失效是錯誤經驗已經被使用。假設某條 skill 把「改掉 constraint 後工具通過」視為成功;它後續可能鼓勵放寬原本正確的需求。若只保存自然語言結論,服務很難找出哪些診斷曾受影響,也無法區分資料錯誤、規則錯誤或新工具語意。
參考設計讓每次診斷記錄 run_id、bundle digest、使用的 skill revisions、取得的資料與建議。偵測到錯誤時,先撤回該條目及包含它的 bundle,阻止新請求使用;反向索引列出受影響的未結案診斷,安排人工複核。已採取的設計修改則按原 flow 重新檢查,服務切回舊 bundle 只改變未來的建議。
殘留狀態可能包括一半完成的候選條目、已產生但尚未核准的評估報告,以及仍持有舊 bundle 的服務請求。條目寫入 staging namespace,評估附 bundle digest,正式 pointer 只指向完整版本。中斷後先核對候選、報告與 pointer,再決定繼續評估或丟棄半成品;不靠最後修改時間猜哪一包是正式版本。
兩名維護者同時晉升不同版本時,發布要求帶目前 parent digest,儲存端以交易比較與更新。落後的提案重新比較新基準,再評估是否仍有增量。這項設計可沿用 既有配置發布文章的版本檢查思路;本篇新增的是經驗條目的回放與影響追蹤,沒有將 GDP 產品能力外推為已部署的 skill marketplace。
歷史案例來源也要有信任等級。工具 log 可以含錯誤指令或無關文字,Reflector 接收它時只當待分析資料;整理程式只接受固定 schema 的新增條目,白名單限制可提出的查核操作。模型從 log 讀到的「請刪除全部資料」沒有發布權。根因 owner 確認來源與處置後,條目才取得候選資格。
用無效重跑的成本判斷是否值得引進
以下是假設算例,與合成程式的執行時間無關。設一百次診斷各需要十五分鐘人工判讀;流程量測發現其中七十次可由查核服務提供已確認的建議,每次仍需五分鐘複核,三十次棄答維持十五分鐘。服務每次額外花一分鐘取得資料。
原本人力是 100 × 15 = 1,500 分鐘。新流程為 70 × 5 + 30 × 15 = 800 分鐘,節省 700 分鐘、約 11.7 小時;一百分鐘服務等待是否能與其他工作重疊,應另外量測。若每週整理與審查新條目要八小時,淨人力收益就只剩約 3.7 小時,還沒有計入維運。
再假設已答覆建議有四次錯誤,每次引發六小時、使用十六個核心的無效重跑,總成本為 4 × 6 × 16 = 384 CPU-hours,另需工程師處理。在這組條件下,數個錯誤便足以抵銷人力節省。把建議限制為低成本查核,可以縮小錯誤的後果;擴大到自動重跑之前,應用真實事件量測錯誤成本。
比較 baseline 時也要公平。工程師加既有診斷腳本、單純全文檢索、具適用條件的條目檢索,以及由模型生成新查核,都應看相同的失敗資料。資深工程師的回憶效率、腳本確定性與模型覆蓋未知問題各有長處,不能用最弱的一個 baseline 代表現行做法。
| 方法 | 比較容易得到的能力 | 主要代價 | 合理起點 |
|---|---|---|---|
| 人工 runbook+確定性腳本 | 已知錯誤直接定位,輸出穩定 | 更新與跨版本整理需人維護 | 根因類別少、訊息與流程穩定 |
| 全文/向量搜尋歷史案例 | 容易找到相似症狀與原始紀錄 | 相似度缺乏因果與版本判定 | 提供工程師參考,不直接執行處置 |
| 帶條件的 skill 檢索 | 前提可檢查,反例可逐條補充 | schema、版本測試與 owner 工作增加 | 重複失敗多、錯誤重跑昂貴 |
| 模型反思+候選最佳化 | 能提出新的查核與規則變體 | 評估成本、過度擬合與非確定性 | 固定資料與評量方式已成熟後 |
這是工程選擇的比較,未對四種方案做真實團隊的成本實測。若錯誤高度標準化,腳本可能最合適;若過半時間用於陌生根因,重用歷史條目的收益可能有限。系統應允許在 skill 沒有幫助時退回原來流程,避免為證明自動化而持續增加上下文。
未來六個月,可以用公開 flow 建立一條診斷前後可核對的試驗線,先量測錯誤路由、覆蓋率與無效 rerun,再決定是否接入模型反思。若新版條目在跨設計、跨工具版本的測試持續改善,且 owner 審查成本低於省下的工作,才有理由擴大;若只能重播原案例得高分,就保留為 runbook 輔助。這是條件式工程預判,沒有預設完成工期或效益數值。
證據範圍
ACE、Reflexion 與 GEPA 支持上下文反思、條目更新和候選評估的方法背景;它們未證明本文提出的 EDA 診斷服務已在晶片公司量產部署。ACE 的 AppWorld 數字引用 2025 年 v1 的特定模型與四項指標平均,不把它外推成 root-cause accuracy。GEPA 的 v2 摘要與官方程式說明足以核對本文使用的候選演進概念,本文沒有重現其論文實驗。
合成程式只實跑規則萃取、資料條件分流、評估報告與單程序版本操作;人工編寫的案例共享規則結構,不能證明跨設計泛化或真實 LLM 學習。真實 tool parser、根因標註、時間/設計隔離測試、模型呼叫、EDA 修正與設計檢查、資料庫原子交易、崩潰持久性和多機壓力測試均未完成。文中的 synthesis 過程是參考案例,時間與 CPU 算例是假設。
Cadence 文件是供應商一手的工程責任說明,未提供本文的 skill schema 或量化診斷效益。BTTF 的已發表成果用於說明查詢資料與累積診斷經驗的接續關係,本次沒有新增或重測其數字。全部實驗資料為合成,不含內部 RTL、log、PDK、私人會議內容或客戶資訊。
References
- Qizheng Zhang/Stanford 等,Agentic Context Engineering v1,2025-10-06,§3 條目更新與 §4 AppWorld 設定。現行 v3 版本資料,2026-03-29。
- Lakshya A. Agrawal 等,GEPA v2,2026-02-14;官方程式與方法說明,API 現況與論文數字分開處理。
- Noah Shinn 等,Reflexion,2023 年原始發表,NeurIPS 2023。
- Reela Samuel/Cadence,How to Verify and Signoff AI-Generated Design Data,2026-10-07。
- 合成診斷 skill 實驗程式及實跑結果。