
多人、多工具如何交付同一顆晶片:NVIDIA 使用的 GDP 與配置式設計管理
大型 IC 設計團隊需要共同確認「正在交付哪一版晶片」:RTL、IP、SDC、實體 view、工具設定與驗收報告,必須能回到同一份配置。多家 EDA 工具可以各自保有原生資料庫,工程師也可以平行開發;真正要統一的是版本選擇、相依關係與放行決策。把所有檔案搬到同一個目錄,仍可能交付一個從未一起驗證過的組合。
這個問題在 R2G 中尤其昂貴。RTL 團隊修正介面,verification 團隊更新 checker,實作團隊調整約束,STA 團隊分析另一份寄生參數。每個局部成果都合理,整合時卻可能沒有一套能同時成立的假設。值得研究的是:平台如何讓多人保有工作自主權,又讓跨工具交接能被機器檢查,而不靠最後一週的人工對帳。
NVIDIA 是 IC Manage GDP 的具名使用者。供應商公開了 NVIDIA 的 Ajay Chandna 對跨站點使用、check-in/check-out 與晶片交付的說明;這支持 GDP 確實進入過 NVIDIA 的設計協作流程,但證言未標明原始日期與工具版本。本文不據此推定 NVIDIA 今天的完整內部架構。NVIDIA 使用證言與 GDP 產品頁
分析主體則是仍在演進的配置式設計管理:IC Manage 於 2024 年 10 月 1 日公布 GDP-XL 的資料庫、plugin 與追溯更新;目前 GDP-AI 官方文件進一步說明多家工具整合、階層 BOM、原子提交及唯讀 AI 資料存取。以下把「NVIDIA 使用事實」「供應商公開能力」與「作者提出的 R2G 交接方案」分開,追蹤一個配置如何成為可交付的設計。2024 年原始公告、目前平台文件
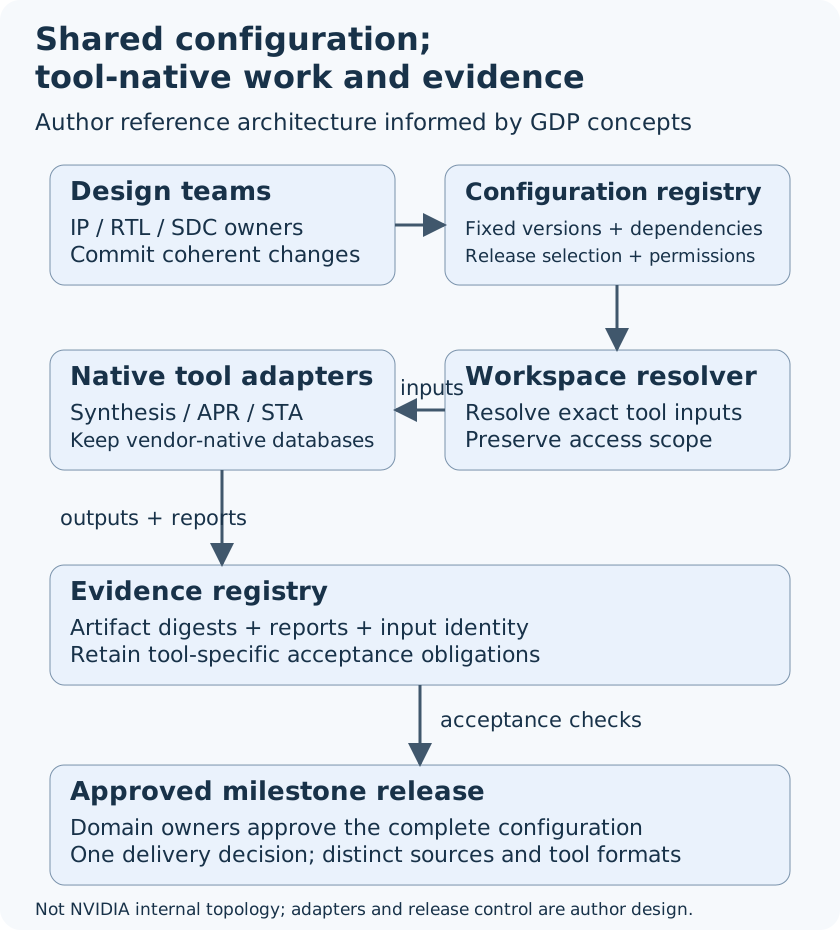
團隊共用的設計,為什麼不能只用一個 branch 表示
軟體 branch 通常表示同一棵來源樹的演進;IC 設計的配置還需要選擇多個 IP 的版本、同一 IP 的不同 views、工具 recipe,以及驗收所依賴的條件。一個 block 可能同時有 RTL、抽象幾何、timing model 和驗證環境。它們不是只要名稱相同就能組合:pin、位元寬度、電源語意或 clock 假設不同,下游工具仍可能讀得進去,卻在處理另一個工程問題。
IC Manage 的公開資料用階層 BOM/configuration 描述這個組合,涵蓋 RTL、analog、軟體、driver、CAD 與 EDA 工具;配置記錄元件版本和依賴,並可與其他資料管理 repository 連接。這是一種將各領域版本組裝成設計狀態的方法,不是要求所有內容只能用同一種檔案格式。階層 BOM 與配置管理
由此推導,single source of truth 應有兩個不同層次。元件的權威來源回答某個 RTL 或 view 的內容;配置的權威紀錄回答這次組裝選了哪些內容,以及誰核准這個組合。把兩者混在一起,會導致兩種相反錯誤:為統一平台而強迫所有工具遷移,或容許各團隊各自維護一份「正式清單」,最後沒有共同基準。
作者建議把每個來源表成帶型別的物件:project / component / view / revision / digest / owner / access_scope。revision 方便人理解演進,digest 核對實際內容;兩者都不能取代相容性條件。例如 RTL 與 LEF 的 pin 集合可以比較,但 netlist 的階層命名可能經綜合改寫,不能要求字串完全相等。每條依賴都要說清是內容相依、介面相容,還是驗收證據相依。
一份配置也要區分開發狀態與交付狀態。工程師可以在開發配置中追蹤新 release;一旦啟動可比較的 run,就必須解析成固定版本。latest 適合探索,不適合重現。即使某個 repository 日後重新標記 release 名稱,既有 run 的 resolved manifest 仍應指向原內容,避免昨天的 report 在今天默默換了輸入。
配置解析還需要處理依賴圖,而非只儲存一張清單。作者方案為每個 component 建立到所需 view、constraint 和 recipe 的有向邊,解析時以拓樸順序取得固定版本;遇到循環、缺少來源或無權存取,就停止物化,不讓工具自行猜一個替代值。圖的節點與邊數為 V、E,單次遍歷的基本成本是 O(V+E),實際延遲常由來源存取與權限查詢主導。
同一個版本被多個 block 使用時,反向索引能回答變更影響誰。假設只有 DMA 的介面改版,平台先找消費這個介面的整合檢查,再沿相依邊標記衍生成果失效;與它無關的控制 block 回歸可以保留。若相依資料不完整,應保守重跑而非樂觀重用。增量執行的收益取決於相依圖是否可信,不能只以 job 數下降當成成功。
版本固定也不保證執行可重現:工具會讀環境變數、預設初始化腳本或未列入 manifest 的外部路徑。可先記錄 tool build、recipe 及允許的檔案來源,對缺少宣告的讀取產生診斷;暫時無法做到完整封閉環境時,明確標示可重現範圍。這個機制比要求工程師每次手動抄寫十幾個版本欄位更有價值,但攔截與紀錄同樣有執行成本。
此外,內容相同和權限相同是兩回事。兩個 workspace 可以引用同一 digest,仍需各自具備存取許可;能共用快取不等於可以跨客戶共用內容。配置解析應將無權限的物件視為不可取得,查詢也不能先回傳敏感屬性再讓使用者自行過濾。這是作者提出的權威邊界,不代表供應商已公開了每種部署的內部隔離拓樸。
原子提交保住完整性,驗收再判定工程正確性
多人編輯時,最基本的失敗是局部更新被別人看到:新的 schematic 已提交,對應 symbol 尚未提交;新的 RTL 已交付,constraint package 還停在舊版。工具可能成功開啟它們,錯誤卻已跨過團隊邊界。這種失敗不需要模型或演算法出錯,只要一次傳輸中斷或錯誤的發布順序就足夠。
GDP-AI 的 Virtuoso 文件公開了相關物件的一次原子 check-in、release snapshot、跨團隊同步狀態,以及保留 exclusive checkout 的 staging 分支。其作用是把相關設計物件成套提交,並為不適合一般文字 merge 的資料保留受控替換路徑。原子 check-in 與 staging
但原子性只承諾「沒有半套提交」,不承諾 schematic 與 layout 在電氣上相符。因此作者提出兩個分離的門檻:先提交一個完整候選,再由 domain owner 的工具證據決定是否放行。LEC、LVS、時序或介面檢查各自回答不同問題;平台不能把它們壓成沒有條件的 passed=true,也不能因單一檢查通過就宣稱完整 signoff。
提交粒度則有取捨。整顆 SoC 一起鎖住,最容易得到共同快照,卻讓互不相干的 block 等待同一把鎖;每個檔案獨立提交,平行度高,卻容易失去相關 views 的完整性。比較合理的起點是由 IP owner 定義 coherent change set,SoC owner 再選取已核准的 release 組裝配置。大鎖縮小為元件內的相容性單位,整合仍要付出跨元件檢查成本。
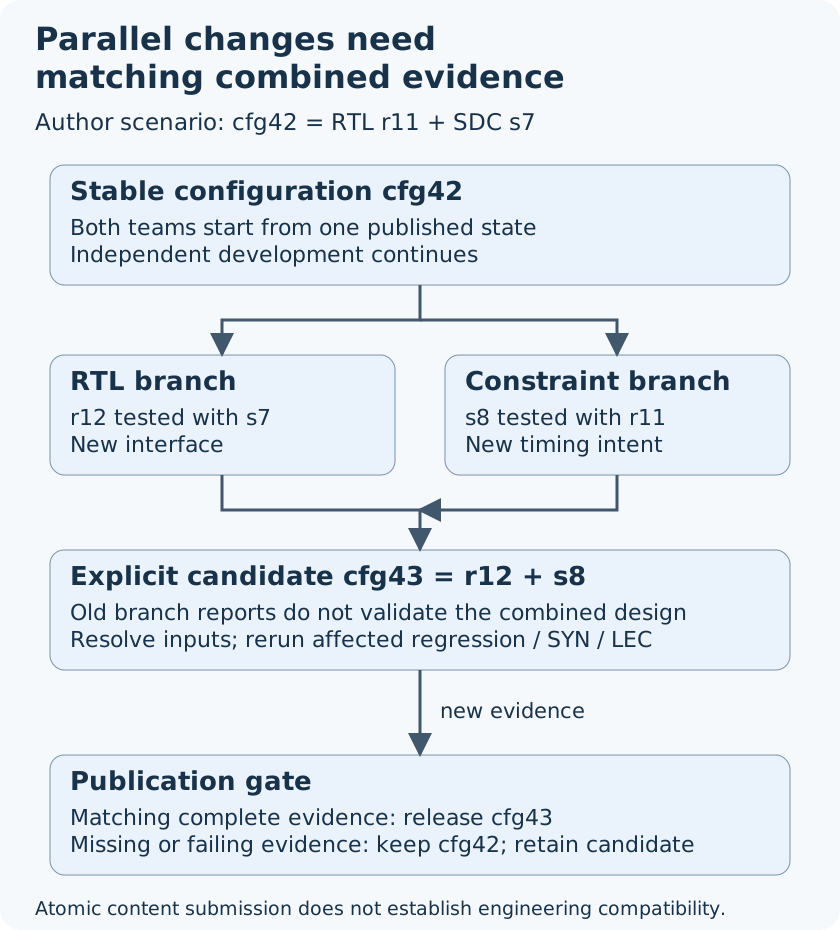
假設 baseline cfg42 使用 RTL r11、SDC s7。RTL 團隊建立 r12,SDC 團隊另建立 s8;平台可以保存兩條分支,但不能從各自最新值自動拼成 r12+s8,再把兩個舊 report 算成這個組合的證據。這裡缺的不是檔案,缺的是對 r12+s8 的驗證。正確做法是形成新 candidate configuration,列出受影響工作,等對應證據完成才成為下一個 release。
多家工具共用身分,保留各自的語意與資料庫
GDP-AI 產品文件列出 Cadence、Siemens 與 Synopsys 的 custom-design 整合。這能支持「供應商提供多工具接點」的主張,不能證明 NVIDIA 某個專案同時用了哪幾個接點,也不能推定每一種 APR/STA database 都能相互轉換。多家工具整合範圍
對 R2G 平台而言,更實際的 multi-vendor 目標,是讓不同工具知道自己消費哪一份設計、產出什麼證據。作者建議每個 adapter 接收相同的 configuration_id,再解析自己需要的 input subset;輸出則同時保留原生 artifact 與最小的可比較 metadata。這比先建一個包辦所有工具語意的巨型 IR 更容易導入,代價是跨工具差異必須顯式管理。
例如 synthesis 的交付可包含 mapped netlist、SDC、LEC 配對資訊與 unresolved references;APR 接收其中一部分,加入 floorplan、library views 和自己的工具 checkpoint;STA 再使用適當 netlist、SDC、Liberty 與 parasitics。這是作者提出的典型交接模型,並非 NVIDIA 公開的工具清單。檔名相同不足以建立依賴,輸出必須記錄 producer、tool build、recipe、input digests 與 scope。
共通 metadata 也要節制。可以統一 run ID、版本、單位、狀態與來源路徑;不應在沒有語意轉換的情況下,把各家工具的 WNS、coverage 或 DRC count 直接相加。SDC 解讀、分析 corner、setup/hold、路徑集合與報告方式不同,數字即使都叫 WNS,仍可能不是同一個測量。Adapter 的責任是保留差異,指出可比較範圍,無法比較時回傳原因。
工具內的修改也不能遺失。一個工程師在 Tcl shell 中作 ECO,若只保存最後的 checkpoint,而沒有對應 netlist、操作紀錄與重新驗收,其他人無法判斷它是原配置的派生結果,還是新設計狀態。平台可以讓原生工具持有編輯中的狀態,但 release 時必須把變更表達成新候選;不能一面允許任意修改,一面仍宣稱來源配置完全未變。
從三個團隊走到一個可交付配置
以下是一個作者設計的假設案例,用來具體說明 GDP 類能力可以如何接到 R2G;不是 NVIDIA 內部 trace。SoC 含 DMA block、控制 block 與 SRAM interface,RTL、verification、implementation 三個團隊平行工作。目標是發布 DMA 的新介面,同時維持其他 block 的可重用性。
輸入先固定在 cfg42。RTL owner 提交 dma:r12;verification owner 提交與新介面匹配的 testbench t9;implementation owner 提供已核准的 constraint package s8。配置管理者解析每個來源,建立 cfg43-candidate,保留 SRAM view 的既有識別;本次不接觸或改動任何製程資料。需要取得哪些 library inputs,仍由具權限的既有 flow 決定。
configuration: cfg43-candidate
parent: cfg42
components:
  dma: {rtl: r12, interface: i4, testbench: t9}
  control: {rtl: r5, interface: i2}
constraints: {release: s8, approved_by: constraint-owner}
views: {sram_release: existing-approved-reference}
run_contract:
  recipe: flow-r6
  tool_versions: resolved-at-launch
  input_digests: resolved-and-frozen
acceptance:
  policy: gate-v3
  required: [interface_check, regression, synthesis_check, lec]
這份 schema 是作者方案。required 只代表本次假設的 SYN 交付,不冒充完整 APR signoff。平台先檢查介面與來源完整性,再將 cfg43 的固定輸入投影到三個隔離 workspace:功能回歸、綜合及等價驗證。每個 run 的結果寫回自己的 namespace,以配置識別和實際 digest 綁定,避免工具 A 的 report 覆寫工具 B 的同名檔案。
Tool evidence 要能回答具體問題:regression 是否完成指定 test set、失敗是否留下 trace;synthesis 是否仍有 unresolved reference、交付 netlist 與 SDC 是否成套;LEC 比較了哪一對來源與產物。這些報告回到 cfg43 的 evidence set;只有假設的 gate-v3 全部滿足,才發布 SYN handoff。APR 階段接受的仍是候選輸入,其實體與時序義務尚未完成。
結果可以有三種。檢查通過,形成可移交的 cfg43 release;檢查失敗,保留候選與反例,不移動 release pointer;來源完整但工作未結束,維持 incomplete,不能把缺報告算成通過。下一階段只讀 release manifest 和其中列出的物件,不再臨時抓各團隊的最新目錄。多人分工因此有明確接點,而非要求大家停止開發等待整顆晶片。
最危險的故障發生在「結果回來」與「版本放行」之間
假設 cfg43 的綜合已完成,report 正在寫入時 worker 中斷。殘留狀態包括部分輸出、完整或不完整的 tool log,以及一個尚未提交的 evidence set。若控制程序只看 netlist 存在,就可能放行缺少對應 SDC 或 LEC 的成果。作者方案要求先寫完整 artifact manifest,再提交 result-complete marker;validator 同時核對檔案 digest、必要 reports 與 run identity。
重試則使用同一個穩定 request key,查詢既有 attempt,避免產生兩個都自稱正式的結果。若工具本身無法接續 checkpoint,可以建立新 attempt 重跑,但保留原 attempt 的失敗資訊;平台承諾的是只有一份被接納的交付,不是每個商用工具都具備 exactly-once execution。
另一個故障是兩位整合者同時發布。A 和 B 都以 cfg42 為基準,A 先放行 cfg43,B 隨後完成 cfg44。若 B 直接覆寫指標,可能讓 A 的新版本被悄悄略過。作者建議發布操作包含 expected_parent=cfg42,在單一權威交易中檢查與更新 pointer;A 成功後,B 收到衝突,必須重新比較 cfg43,再決定重組或保留另一條產品分支。
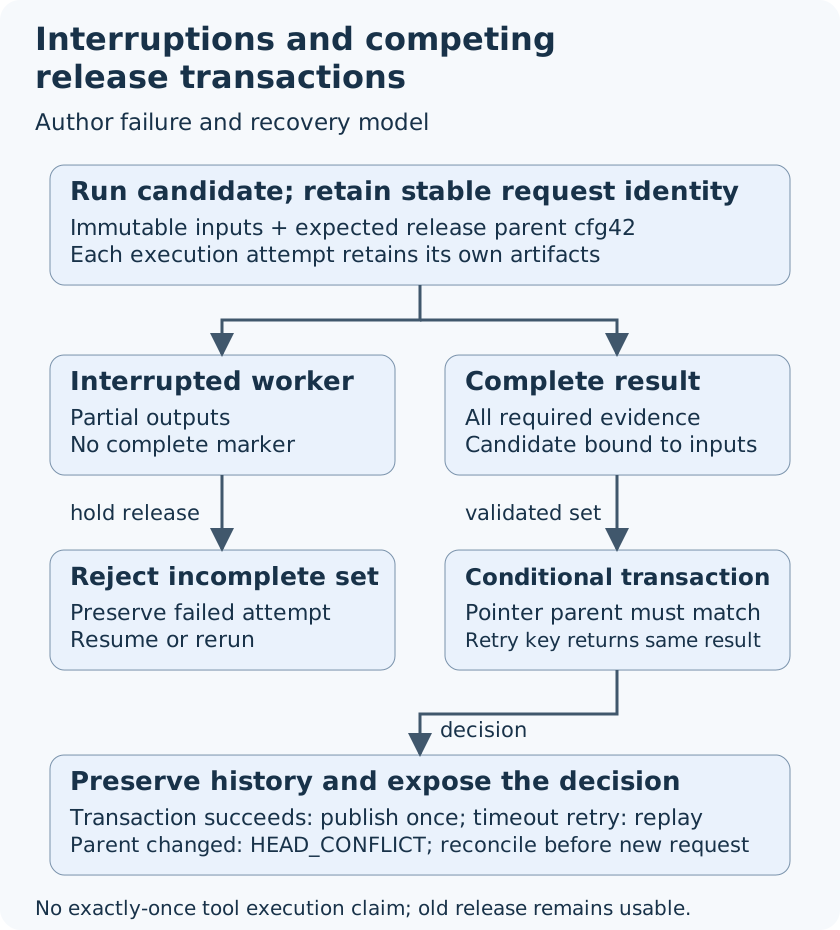
跨站點副本的延遲也要明說。遠端站點若只看見 cfg43 的 metadata,卻尚未取得某個物件,應停在 materializing,而不是退而選用同名舊檔。可允許網路斷線期間編輯私有分支,但新的全域發布需要權威端確認;如果宣稱離線也能任意放行,就必須另外解決衝突與分支權威,不能把快取直接當成最新真相。
Rollback 同樣不是刪除 cfg43。正確的回復是保留 cfg43、失敗證據與核准紀錄,發布一筆回指先前已知可用配置的決策;已在跑的下游 jobs 依明示政策取消或隔離。回復 pointer 不會自動撤回已傳出去的資料,也不會把已完成的工具工作抹掉,這是平台保證的實際邊界。
集中管理、配置聯邦與共享目錄的代價
| 方案 | 正確性與多人協作 | 成本及延遲 | 維護與整合代價 |
|---|---|---|---|
| 共享 NFS+各團隊腳本 | 起步快;需另定快照與發布規則 | 本地存取便宜,跨站點同步及人工對帳可能昂貴 | 對既有 flow 干擾少;權威清單容易分散 |
| 集中式設計資料管理 | 原子 change set、版本及 owner 容易共管 | 遷移、服務可用性與全域 metadata 操作有成本 | 需要工具原生整合、二進位資料策略與完整備份 |
| 配置聯邦+既有 repository | 各領域保留來源,以固定 manifest 共同交付 | 解析、授權與 materialization 增加啟動成本 | Adapter 與跨 repository 的完整性驗證較複雜 |
這些是作者的架構比較,不是三種商用產品的實測。集中式方案可以減少權威分裂,但不能取代各 domain 的驗收;聯邦方案減少一次性遷移,卻要承擔來源可用性和版本保留責任。若某個來源允許重寫歷史,單純記住 release 名稱就不夠,需要受控保留或可驗證的內容快照。
效能也應按操作類型判斷。IC Manage 的 2024 公告報告一百萬筆元素壓力測試:包含逐筆安全規則檢查及 graph records 傳回,GDP-XL 為 19 秒,對比典型競品 20–30 分鐘。換算約 63–95 倍;對手版本、硬體與完整測試程式未公開,不能外推成 R2G 周轉時間加速,更不是 NVIDIA 的量測。原始條件與數字
另一個假設算例更貼近平台選擇:一份穩定輸入 100 GB,20 個隔離 workspace 各新增 5 GB。完整複製需 2,100 GB;共享唯讀基線加各自 delta 的理想值是 200 GB,少約 90.5%。這忽略 metadata、壓縮、備援、變更粒度及實際讀取 pattern;它只說明為何值得區分不可變來源與可寫產物,不是特定產品的容量保證。若執行時幾乎全部資料都會改寫,優勢就會大幅縮小。
AI 可以查詢真實配置,發布權仍屬於工程流程
GDP-AI 的 AI 文件公開了自然語言查詢、workflow script 生成與文件檢索;結構化資料則透過 MCP 的安全唯讀工具讀取。IP lifecycle 文件另說明,AI 可整理 IP package,經 IP owner 審核後發布。兩者分別對應資訊取得與受控工作流,不能從唯讀 MCP 推定 agent 已有任意設計寫權。AI 資料介面、IP package 核准流程
作者建議先讓 agent 回答配置與相依問題:哪個 release 使用了有缺陷的 IP、哪些 reports 因 SDC 換版而失效、哪個候選缺少必要 evidence。這些查詢容易對照權威紀錄驗證。生成的新腳本則先成為 proposal,記錄允許修改的物件、預算與預期輸出;不能因腳本語法正確就直接更新正式配置。
權限也要跟著資料投影走。對某個 project 有權讀 metadata,不代表可讀全部 RTL;對某個 workspace 有寫權,不代表可發布 SoC release。平台應在解析 manifest、物件下載與發布交易各自檢查實際 caller,不讓 adapter 或 agent 用共用帳號擴大權限。快取鍵包含存取範圍,撤權後既有副本如何處置則需另定政策。
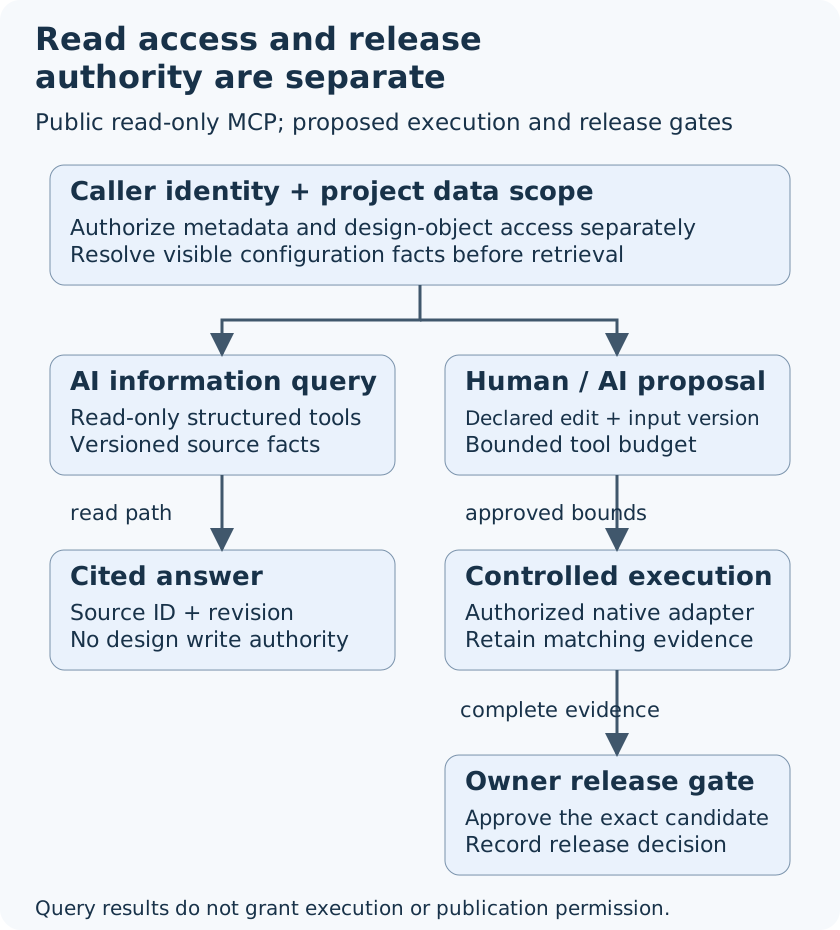
未來六到十八個月,最有價值的能力依序是:把 resolved configuration 與工具證據連成可查詢關係;讓跨工具 adapter 保留原生語意並核對交接;最後才擴大 agent 的修改與發布範圍。若一套平台還無法辨認 report 屬於哪份設計,更強的模型只會更有效率地使用錯誤前提。
本文附的無 PDK 最小實驗以虛構的 RTL/SDC/report metadata 和 SQLite 模擬四種情境:版本混用、部分結果、重複 request、競爭發布。它驗證 manifest 與 pointer 的邏輯,不執行 EDA、不量測 PPA,也不重現 GDP 的商用實作。下一步應把同一契約接到一條可公開的 SYN flow,測量啟動 overhead、錯配拒收率與重現成功率。
這項建議也可以被推翻:若既有 flow 已完整保存輸入快照、所有交接皆有穩定身分,且錯配問題極少,新增管理層的成本可能高於收益。真正需要補的是目前無法回答的工程問題。多家工具的共同平台應讓每份成果能回到同一個可核准配置,同時保留每個工具與 owner 對正確性的責任。
參考資料
- GDP-AI: Design & IP Management — IC Manage,目前官方產品文件,原始發布日未標示;包含 NVIDIA/Ajay Chandna 使用證言。證言版本與原日期未公開。
- IC Manage Extends GDP-XL Design and IP Management Leadership — IC Manage,2024-10-01;資料庫壓力測試、plugin、Time Machine 與安全機制公告。
- GDP-AI for Silicon and IP Lifecycle Management — IC Manage,目前官方文件,原始發布日未標示;階層 BOM、release、IP approval、跨 repository 與治理。
- GDP-AI for Virtuoso — IC Manage,目前官方文件,原始發布日未標示;原子提交、staging、snapshot 與跨站點同步。
- AI-Driven Design Management — IC Manage,目前官方文件,原始發布日未標示;唯讀 MCP、script 生成與 RAG。
- A Blueprint for EDA Infrastructure for 2021 and Beyond — Anthony Galdes 等,IC Manage,2020 年 7 月文件;第 3–7 頁為設計資料、IP 相依與團隊協作背景。本文不把其歷史容量估計當成當今 NVIDIA 規模。