
Sonnet 5.5 升級牽動 Agent 的推理設定、工具回合與模型切換
AI 模型進入工作平台之後,一次升級會同時改變三件事:能解哪些問題、如何呼叫工具,以及原有工作能否接續。最近幾天的發布把這個差異拉得更清楚。Gemini 4 Argon 宣布了更長的輸出能力,但一般開發者仍須等待擴大開放;Sonnet 5.5 已提供開發介面,卻改動了推理與工具設定;Qwen3.8 的公開權重則讓團隊可以自行部署,部署端的限制仍需要另外驗證。
這對 Agent 平台有直接影響。原本正常的程式,可能在換上新 model ID 後收到參數錯誤,也可能繼續回傳成功,卻沒有使用先前保存的推理狀態。若只看排行榜或 HTTP 狀態,這兩類變化都容易漏掉。模型的工作能力,需要沿著輸入、推理、工具、狀態與交付物的完整路徑評估。
先看以下背景圖。平台把使用者問題轉成模型請求,模型提出工具動作,工具產生外部證據,再回到下一輪推理。本文關心的兩個機制就在接點上:請求設定與回應區塊的契約,以及對話歷史與推理狀態的相容性。圖中的平台是作者設計的通用案例,沒有假定廠商採用相同內部架構。
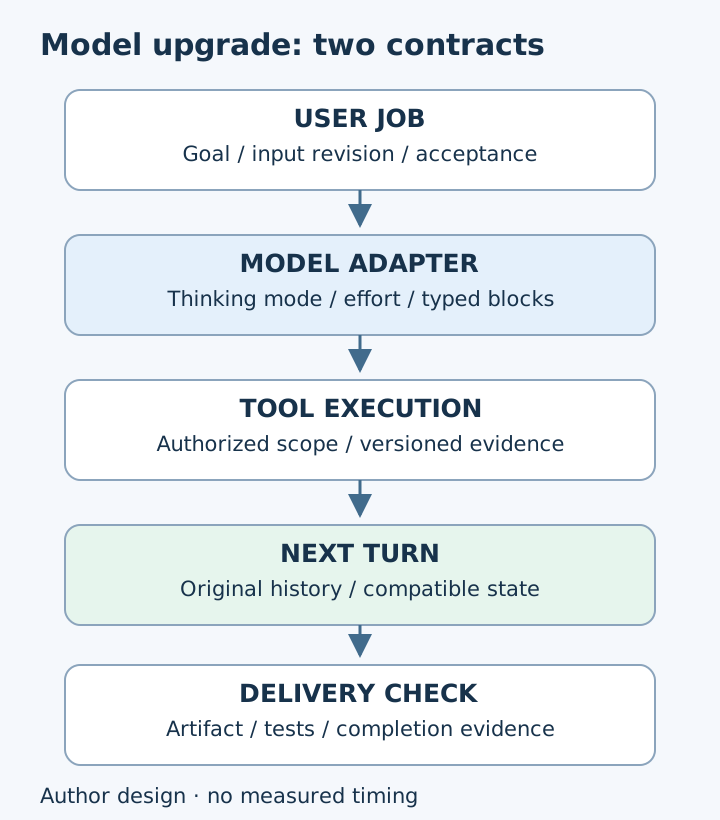
圖一:作者設計的工作路徑。模型介面的具體變更依 Sonnet 5.5 遷移指南與 Preserved thinking 文件;箭頭不代表實測時間。
三個進展帶來不同的採用條件
Google 於 9 月 30 日發布的 Argon 公告將最大輸出從先前 64K 提高到 1M tokens,初期透過 Fairwind Program 向受信任的資安防禦者推出,之後才擴展到付費 API 與 Google AI Ultra 使用者。這裡增加的是 output limit,不能改寫成相同數字的 input context,也不能把宣布視為一般帳戶已能呼叫。
較長輸出讓一次軌跡有更多思考與產生內容的空間,但它沒有直接證明任務品質會等比例提高。若任務失敗在讀錯檔案、操作未授權物件或漏掉驗收,即使允許繼續生成,仍可能延長錯誤路徑。對尚未取得存取的團隊,現在可以準備評估資料與驗收條件,實際速度、費用及恢復行為則等待可用介面再量測。
Anthropic 9 月 28 日的 Sonnet 5.5 公告報告其生成速度較 Sonnet 5 快逾 30%,部分工作每件成本最多降低 30%;API 一般 input/output 單價仍為每百萬 tokens 2/10 美元。這是廠商測試結果,成本改善包含工作使用的 tokens,不能把「每件少花錢」解讀成單價調降,也不能直接推成任何既有流程都會得到相同比例。
另一端,Qwen3.8-27B 官方 model card提供 Apache 2.0 權重,列出 27B dense 模型、原生 262,144 context,以及可擴展至 1M 的設定範圍。權重可取得與 hosted service 的能力是兩種交付;同頁將具更多功能的託管版本列為 coming soon。自部署應核對實際 runtime、量化、context 設定與可用工具,不能套用託管服務尚未交付的保證。
| 進展 | 現在可核對的證據 | 平台下一步 |
|---|---|---|
| Gemini 4 Argon | 官方宣布、輸出上限、分階段推出 | 先備妥工作樣本;取得存取後再做實測 |
| Sonnet 5.5 | 已提供介面、遷移規格、廠商測試 | 檢查請求、回應與歷史保存,再重建基準 |
| Qwen3.8-27B | 公開權重、model card、部署範例 | 固定權重與 runtime revision,量測部署能力 |
表一:依上述一手來源整理。這是交付狀態比較,不是跨模型能力排名;開放程度也不代表品質高低。
推理設定改變,回應解析就要跟著改變
Sonnet 5.5 的第一個遷移接點,是關閉起始推理的方式。遷移指南要求將舊的 thinking.type: disabled 改為 between_tools,搭配 high 或以下 effort;xhigh、max 必須使用 adaptive 路徑。這些設定不是可任意組合的獨立開關。
對平台而言,合理實作是把支援的組合放進每個模型版本的能力表。接到使用者選擇時,先檢查該模型接受的推理模式、effort 與工具設定,再建立請求。單一全域的「思考開/關」欄位不足以表示這些差異;直接把欄位原封不動傳給不同供應商,會把相容性問題留到執行時才暴露。
可用的最小設定形狀如下,實際 API 仍須由對應 SDK 建立。這是依官方介面整理的設定示例,本文沒有使用付費模型執行它。
{
  "model": "claude-sonnet-5-5",
  "max_tokens": 4096,
  "thinking": {"type": "between_tools"},
  "output_config": {"effort": "medium"}
}
第二個接點發生在回應端。Thinking 文件說明回應可以含 thinking、text 等不同區塊;隱藏推理文字時仍會保留 signature,相關 tokens 也仍計入輸出費用與 max_tokens。因此,讀取 content[0].text 的假設,以及用可見文字長度估計全部輸出費用的做法,都可能失效。
解析器應依區塊類型處理:可見文字交給介面,工具呼叫交給受控執行器,需接續的原始 assistant 區塊完整保存。這三條資料路徑分開,使用者就不會因為某個區塊沒有文字,誤以為模型什麼都沒做;保存層也不會因為只挑顯示文字而丟掉接續需要的資料。
這個分工有一個常見反例。某些 gateway 為了把所有供應商統一成字串,先把 assistant 回應轉成純文字,再於下一輪重新包裝。單次摘要可能看不出問題,但一旦工具回合需要引用先前的區塊,原有內容已經無法還原。平台可以提供統一的顯示介面,原始協定資料仍需要另外保存。
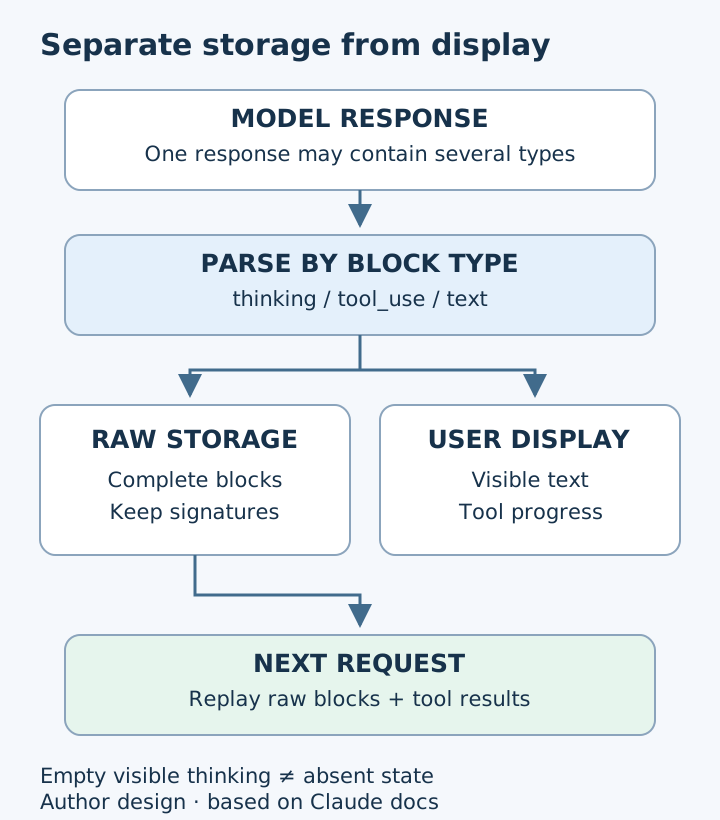
圖二:依 Thinking 文件整理的作者設計。原始區塊保存與對使用者顯示是不同責任;本圖不呈現或還原模型內部推理。
工具輸入合法,仍需要核對工具是否真的執行
同一份遷移指南列出另一項改動:Sonnet 5.5 不接受強制 tool_choice 的 any/tool 形式,需改用 auto。這改變了原本依靠請求參數強制呼叫工具的工作路徑。
Strict tool use 文件處理工具參數與 schema 的一致性。這個保證作用在產生的工具呼叫上;它不能代替「本次必須取得來源資料」的流程要求。選擇工具、參數合法、外部動作成功與成果成立,需要各自有證據。
以一個公開軟體的相容性分析為例。使用者要求檢查某個依賴升級是否改變 API 行為。模型產生符合 schema 的 read_file 呼叫,只證明呼叫形式合法;回應內容可能是舊版本、錯誤檔案,或明確的讀取失敗。若流程要求比較兩個版本,驗收應記錄兩個 revision 與實際讀到的內容,不能讓模型憑記憶完成後就結案。
這裡可以採兩種合理方案。讓模型自行選擇何時讀取,彈性高,也能避免多餘呼叫,但平台必須在交付前確認必需證據;或由程式先完成固定的資料讀取,再把結果交給模型分析,流程較容易核對,卻可能取回不需要的資料。當輸入集合明確、每次都必須核對版本時,後者通常更簡單;當探索路徑會隨結果變動時,前者較有價值。
兩種方案都應防止同一種錯誤:把「模型說已查過」當成讀取成功。必需工具失敗時,交付物要保留未完成狀態;若模型直接回答,也需要檢查本次是否確實具有足夠來源。使用者授權讀取,不會自動授權任意寫入或擴大範圍。
對話歷史成為有身分的狀態
第二個決定長程工作的機制,是歷史與推理區塊的相容性。Preserved thinking 文件說明較新的 Claude 模型會檢查區塊的模型相容性及其之前的 system、tools、messages;Sonnet 5.5 的區塊另有帳戶關聯。模型不相容時可能丟棄區塊而不報錯;前綴不相容則依適用的檢查與設定拒絕或丟棄。不能把「仍回傳 200」當成前一模型的推理已完整保留。
文件也指出,前綴檢查對 2026 年 8 月 31 日 00:00 UTC 起建立的帳戶預設生效,較舊帳戶的行為涉及是否選擇啟用檢查。因此,在一把舊 key 上正常的測試,不足以證明同一段客戶端程式能在每個帳戶安全接續。模型、平台、帳戶與設定都是重現條件的一部分。
以下案例是作者設計,假設 Agent 協助修正一個小型資料轉換工具。第一輪讀到檔案 A 與測試規格,第二輪提出修改,第三輪執行測試。平台保存了每輪原始回應,卻在每次呼叫前把 system 裡的目前時間更新。雖然對人來說只是時間提醒,新的請求前綴已和先前推理所對應的前綴不同。
這個故障留下兩種狀態:外部測試可能已執行,模型接續卻失敗。若平台把整個工作重跑,既有修改與測試可能被覆蓋;若只刪掉所有不認識的區塊重送,工作可能繼續,先前的推理相依也已改變。故障修復首先應回答已完成哪些外部動作,再決定要還原原始歷史,或明確開啟新的推理分支。
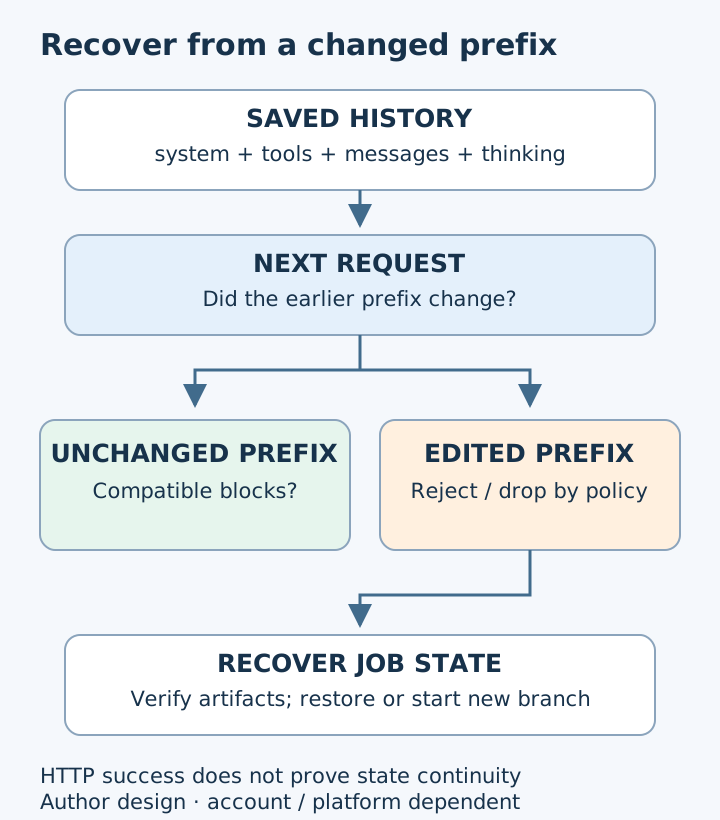
圖三:依 Preserved thinking整理的作者設計。實際是否拒絕或丟棄依平台、帳戶與設定;「新分支」是應用恢復方案,非官方交易保證。
對這個案例,平台應保存當時真正送出的請求,讓後續能比對差異,而不是從目前模板重新產生舊歷史。變動中的時間、工作進度或新來源放在新的訊息,既有證據保留原身分。若需要切換模型,先確認它能使用哪些區塊,再將可公開、可驗證的任務狀態移交:目標、版本、已變更檔案、測試結果與尚未完成的項目。
這份交接狀態不能只是一句「大部分已完成」。例如測試成功,必須附上它對應的 source revision;修改已提交,必須能找到遠端 commit;外部請求逾時,必須保留結果未知而非直接寫失敗。這些是作者提出的應用驗收設計,它們讓不同模型可以依同一份外部事實接續,不要求不同廠商共享內部推理格式。
恢復後也要檢查成果的有效期限。第一輪讀的依賴版本若已更新,保留原始對話只能證明歷史一致,不能證明分析仍適用現在版本。對話正確性與外部資料新鮮度是兩個條件;平台須以新的版本讀取重新建立相關證據,而不改寫舊輪次來假裝從未發生變化。
Effort 應以成功交付的成本重新校準
Sonnet 5.5 公告中一個值得注意的結果,是 FrontierCode 在 Max effort 的成績低於 Xhigh。官方註腳把部分原因連到額外 review、逾時與超出範圍的修改。這是特定評估的 reported result;它提示更高 effort 可能改變工作行為,但沒有建立所有任務都該固定降低 effort 的規則。
比較的單位可以是一批通過相同驗收的工作。令單次模型與工具費用為 C,成功率為 p;若假設每次嘗試成本相同、結果獨立,且失敗可重試,平均取得一件成功結果的呼叫成本為 C/p。這只是分析模型:真實失敗可能彼此相關,還會增加人工修訂與等待,不能把式子當成實際帳單。
以下是作者假設算例,不是任何模型的 benchmark。每一批有 100 件相同規格的工作,input 均為 20,000 tokens;使用每百萬 input/output 2/10 美元的示意單價,不計快取。方案 A 每件輸出 6,000 tokens、成功率 80%;方案 B 每件輸出 10,000 tokens、成功率 90%。輸出包含計費的推理,不能只算畫面顯示文字。
| 假設方案 | 單次費用 | 首批成功件數 | 首批費用/成功件 |
|---|---|---|---|
| A | 0.04+0.06=0.10 美元 | 80 | 10/80=0.125 美元 |
| B | 0.04+0.10=0.14 美元 | 90 | 14/90≈0.156 美元 |
表二:作者假設算例。單價與 Sonnet 5.5 公告的一般 API input/output 價格一致;tokens、成功率與方案行為全部是假設。未計人工、工具、快取、延遲與多次重試。
A 的成功交付呼叫成本較低,B 則少了十件需接手的工作。若每件失敗都需要五分鐘人工處理,兩方案首批分別留下 100 與 50 分鐘工作。假設人工每小時 30 美元,兩者合計費用便是 60 與 39 美元,除以已成功件數約為 0.75 與 0.433 美元。這個反轉來自人工成本假設,沒有證明 B 的模型一定較好。
同樣的道理適用於路由:較便宜模型先做,驗收失敗後升級,可能降低總費用,也可能增加重複讀取、重建狀態與等待。若驗收器漏掉錯誤,升級路徑根本不會觸發。部署初期可以先固定一個模型建立可解釋的基準,再用相同資料比較 effort;等成功與失敗都能可靠辨認,才加入模型路由。
另一個必須控制的變因,是任務範圍。有些工作只要修一個明確 bug,額外重構雖然看起來有幫助,仍可能提高回歸風險和審查成本。評估應同時核對要求的修改是否完成、無關範圍是否受到影響;單用生成程式量、工具呼叫數或主觀「看起來更完整」,容易獎勵錯誤的工作行為。
用一個完整工作驗收升級
實際試驗可以選二十件公開、已知答案的小型資料轉換或軟體修正工作。這是建議的下一個實驗,本文尚未對這些模型執行測試。每件固定輸入版本、工具權限、時間上限、輸出驗收與可接受範圍,再保存模型、平台、推理設定、原始回應與工具結果。
先完成一件正常工作:讀取目標與測試,產生修改,執行測試,核對輸出及版本,最後交付。接著對同一流程插入三種變化:工具回傳錯誤、保存後重新啟動,以及在新輪次改變模型或提供新的需求。每一次都要核對外部成果,而不是只確認對話仍能繼續。
對照組至少有兩個:原模型原設定,以及新模型的明確支援設定。若再加入不同 effort,先保持工具、資料與驗收不變。統計成功率、成功件成本、完成時間、需要人工修正的分鐘數,以及恢復後重複執行外部動作的次數。樣本少時保留各件結果與失敗原因,不能把一兩件成功寫成普遍優勢。
故障驗收應包含限制本身。參數被拒絕,就先修正介面組合;工具資料缺失,就保留未完成狀態;推理區塊被丟棄,就確認是否需要重新建立工作理解;外部結果未知,就先查詢同一工作。不同故障需要不同恢復,統一「換更強模型再試一次」會把問題藏在更昂貴的流程裡。
昨天的 DevDay 分析提出模型、執行與事件如何共同影響交付;今天新增的具體判斷是,模型升級需要同時驗收介面契約與狀態接續。Argon 的擴大開放、Sonnet 5.5 的設定變更與 Qwen3.8 的部署範圍,分別提供不同的採用條件。先把它們轉成可核對的工作與相容性紀錄,平台才有依據決定何時切換、何時保留原方案,以及哪些能力仍需等待實測。