
RTL-to-GDS 的狀態管理:重試、成果相依與工程驗收
RTL-to-GDS 平台需要管理的核心物件,是帶著版本、相依關係與驗收條件的設計成果。排程器能回答工作是否結束,卻無法單靠 exit code 判斷這份 netlist、placement database 或 timing report 能否交給下一階段。當工作需要重試、分支探索或人工修改,這個落差會直接形成重算與錯誤重用。
晶片實作原本就是一條逐步增加約束的流程:功能正確的 RTL 要經過 synthesis、實體佈局、時脈與繞線,再由相應證據確認是否符合需求。腳本能串接工具,工程師則負責辨認版本、判斷哪些成果失效及決定重跑範圍。這個分工在規模有限時合理;大量候選、長時間工作與 agent 自動操作,會把原本隱含的工程知識變成平台必須保存的狀態。
因此,值得研究的是如何在失敗後保留正確性,又避免每次從頭執行。下文將 Kubernetes controller、Temporal 與 bazel-orfs 作為機制參考,提出適用於 R2G 的設計;採用哪些產品則取決於既有流程與維護成本。
圖中的迴路把設計意圖、候選執行與驗收分開:工作產生 report 或 checkpoint,平台再依固定需求決定成果能否進入下一階段。先注意「工具完成」到「成果被接受」之間的邊界;這正是單純排程工作無法替工程師判斷的部分。
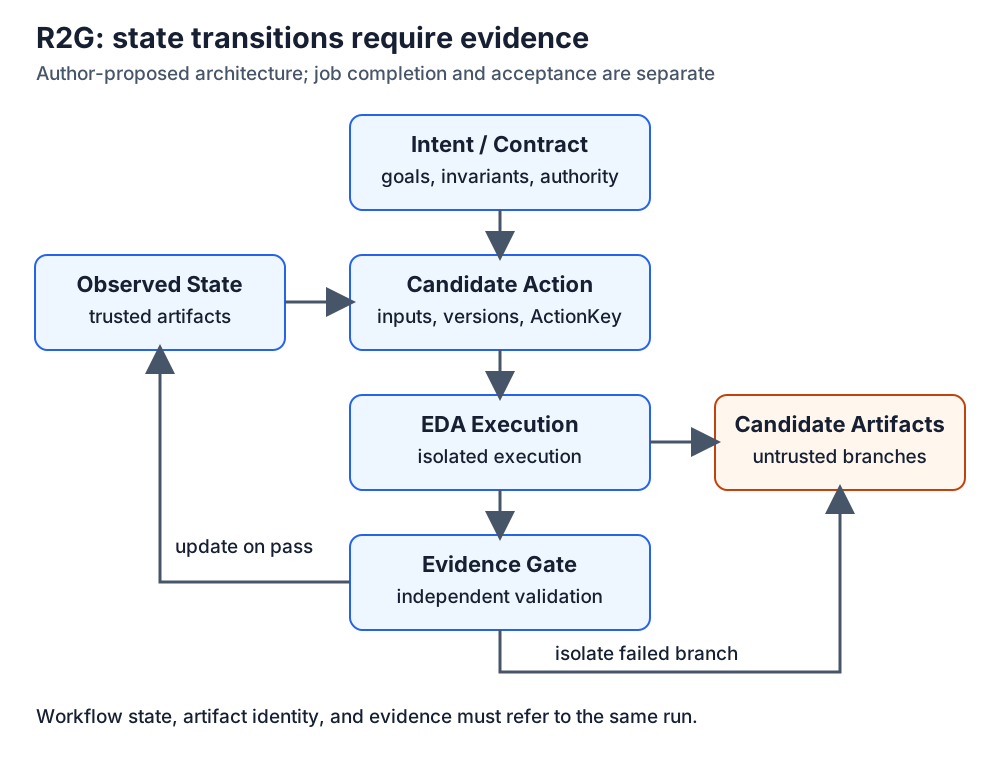
圖:作者設計;reconciliation、durable execution 與 artifact dependency 分別參考 Kubernetes、Temporal 與 bazel-orfs。
Scheduler 看不到的工程狀態
傳統 implementation flow 很自然會長成:
Makefile / Tcl / Perl
        ↓
      LSF
        ↓
Fusion Compiler / Innovus / PrimeTime / ...
        ↓
 log / report / output directory
這套架構在人類主導時可以工作,因為狀態機其實存在 senior engineer 腦中。
工程師知道:
- 哪一版 SDC 才是現在有效的
- 哪個 checkpoint 還可以 reuse
- 這次 timing regression 是 tool noise 還是真問題
- 哪個 stage 必須重跑
- 哪些 violation 可以接受
- 哪一個修改會讓 downstream result 全部失效
但 scheduler 不知道。
LSF 知道 job 是 Running、Done 或 Exit;它不知道「design 是否更接近可以 tape-out」。
要讓 Agent 參與工程閉環,第一件事是把這些隱性的工程狀態顯性化;增加更多 Agent 應排在後面。
R2G 應該有 Desired State 與 Observed State
Kubernetes controller 提供的機制參考是 reconciliation。
使用者宣告 desired state,controller 持續觀察 current state,再採取動作讓兩者靠近。
這個模型可以作為 IC design 平台的參考,但驗收還必須固定 constraints、工具版本與證據的相依關係。
例如一個 implementation objective 可以被描述成:
Desired State
- WNS >= 0
- TNS = 0
- DRC = 0
- area increase <= 2%
- clock definition immutable
- max transition / capacitance clean
而平台持續收集:
Observed State
- WNS = -83ps
- TNS = -4.1ns
- area = +0.7%
- 31 max transition violations
- route congestion hotspot in region X
Agent 的任務,不應是「把下一個 command 猜出來」。
它應該是根據 state delta,提出一個 candidate transition:
Observed State
      ↓
Diagnosis
      ↓
Candidate Action
      ↓
Controlled Execution
      ↓
New Evidence
      ↓
Observed State'
持有 state 的角色是平台。
這和「Agent 寫腳本」屬於不同的系統層級。
長時間 EDA Flow 需要 Durable Execution
長時間 agent workflow 的另一個根本問題是 failure。
worker 會死、network 會斷、license 會拿不到、queue 會塞住、EDA tool 會 crash、filesystem 會短暫不可用。
Temporal 的 Activity execution 將執行、timeout 與 retry 納入持久管理。但 workflow 能恢復,不代表外部工具的 side effect 恰好發生一次;這兩種保證必須分開。
但 EDA 比一般 SaaS workflow 更麻煩:很多 operation 有昂貴 side effect。
例如:
run_place()
run_cts()
modify_sdc()
write_checkpoint()
launch_500_cpu_job()
不能因為 orchestrator retry,就盲目再做一次。
因此 R2G 的 durable execution 必須建立在兩個條件上:
- 每個 action 有明確 identity。
- 每個 artifact 有可追溯 provenance。
理想上,每一次 stage execution 應該可以表示為:
ActionKey =
hash(
  input artifacts
  + tool version
  + PDK / library version
  + parameters
  + constraints
  + environment
)
如果 ActionKey 沒變,系統首先應該問:
已經有可驗證的 artifact 可以 reuse 嗎?
而不是直接重新執行。
Artifact Graph 與 Workflow DAG
Bazel 與 bazel-orfs 對 EDA 的啟發在這裡。
bazel-orfs 將 ORFS flow 納入 Bazel target 與 dependency 管理,提供 stage caching 與增量執行的參考。R2G 若採用相同思路,仍須先證明所有會影響成果語意的 inputs 都已被宣告;漏列相依關係會把錯誤重用變得更有效率。
這比「workflow DAG」更接近晶片設計需要的抽象。
Workflow DAG 通常描述:
synth → floorplan → place → CTS → route
但 Artifact Graph 描述的是:
RTL ────────┐
SDC ────────┼→ synth checkpoint
Library ────┘          │
                       ├→ STA report
Floorplan config ──────┤
                       ↓
                  placement DB
                       │
CTS config ────────────┤
                       ↓
                    CTS DB
兩者差別非常大。
如果只知道 DAG,我知道 stage 的順序。
如果知道 artifact dependency,我才能回答:
- 改了一條 false path,到底哪些 downstream result invalid?
- 換了一個 placement parameter,要不要重新 synthesis?
- tool version 沒變、input 沒變,可以直接 reuse 哪些 checkpoint?
- 同一份 synth output 能不能 branch 五組 placement experiments?
當 experiment cost 被壓低,Agent 就不必每一步都「一次猜對」。
它可以:
Generate candidates
      ↓
Cheap branch execution
      ↓
Measure
      ↓
Discard / cache
      ↓
Promote winner
這比期待 LLM 一次找到最佳 Tcl 更可信。
用 Policy 界定 Agent 的權限
進入 production 之後,還有另一個問題:Agent 不應該天然擁有與工程師相同的 authority。
NVIDIA OpenShell 提供 sandbox 與 policy 的參考;以下權限劃分是作者針對 EDA 提出的設計,並非該產品已具備的晶片設計驗收功能。
這種分層可以移植到 EDA。
例如:
Immutable Boundary
- project filesystem scope
- tool binary
- process capability
- PDK read-only boundary

Runtime Authority
- allowed design
- allowed stage
- allowed Tcl namespace
- resource quota
- LSF queue

High-Risk Action
- SDC modification
- clock definition change
- UPF modification
- signoff waiver
        ↓
Human approval
所以未來 Agent 權限模型不能只是:
can_run_innovus = true
而應該更接近:
agent:
  stage: post_cts
  can:
    - resize_cell
    - buffer_net
  cannot:
    - change_clock_definition
  limits:
    area_delta: 2%
  require_approval:
    - modify_sdc
autonomy 可以在這個框架下逐步放大。
State Transition 以 Evidence 為唯一依據
Agent 最大的錯誤之一,是把「我完成了」當成完成。
EDA 平台不能接受這件事。
Agent says done
      ↓
無效
state transition 必須由版本一致、符合驗收規格的 evidence 觸發。
例如:
Action
  ↓
Artifact persisted
  ↓
Clean validation
  ├─ STA
  ├─ DRC
  ├─ LEC
  ├─ power
  └─ QoR thresholds
  ↓
Evidence Gate
  ↓
State transition
LLM 可以判斷下一步值得嘗試什麼。
但「這一步是否成功」必須由固定規格下的工具結果與驗證器共同判定。STA 證據只涵蓋採用的 corners、modes、models 與 constraints,不能把報告通過寫成無條件的 engineering truth。Agent 的推測可以產生候選,驗收規格則需要獨立持有。
作者提出的 R2G Platform Architecture
回到開頭的狀態迴路,這些機制共同支撐 R2G 的成果管理與驗收。
這個架構裡,Kubernetes 不是必要條件,Temporal 也不是;Bazel 也不一定要直接導入。
重要的是它們背後共同的幾個系統能力:
- desired/current state separation
- reconciliation
- durable state
- deterministic replay boundary
- artifact provenance
- incremental invalidation
- policy-enforced execution
- evidence-based state transition
平台資產是這些能力。
一次 post-CTS 失敗如何恢復
以下是作者設計的案例。固定 RTL、library、SDC、tool version 與已驗證 CTS checkpoint,目標是修復 setup violation,允許 cell resizing 與 buffering,禁止更動 clock definition、exception 與驗收門檻。平台先記錄基準 checkpoint 的 digest、WNS/TNS、area、transition violation 與分析條件,再讓三個候選各自在獨立 workspace 執行。這個隔離單位要涵蓋工具資料庫、暫存檔及 report;只隔離 Tcl 名稱不夠。
假設候選 B 已經寫出新 database 與 STA report,但 worker 在回報完成前失聯。殘留狀態是「可能已有成果,控制面不知道是否完整」,不是「B 沒有執行」。若 timeout 直接啟動第二個 B,兩個 worker 可能同時寫同一目錄;晚回來的舊 worker 甚至可能覆蓋新結果。Scheduler 的 Exit 狀態也無法消除這個歧義。
我會將恢復切成查證與重算。新 worker 先依 ActionKey 查外部 job identity、成果 manifest 與持久 receipt。如果原 job 仍在執行,接管觀察,不再提交;如果成果完整,驗證 input digest、檔案 checksum、工具退出狀態與報告解析結果,再重新跑必要的 acceptance checks;只有找不到可用成果且確認舊執行無法再提交時,才允許新的 attempt。取消 job 與停止外部寫入要分別確認,不能把 orchestrator 的取消訊號當成 tool process 已停止。
為避免舊 attempt 恢復後污染主狀態,每次 attempt 使用遞增 generation,成果先放在獨立且不可變的路徑。Promotion 時以 compare-and-swap 檢查基準 state version 及目前 generation;版本不符的結果保留為支線,不自動接到主流程。這是作者提出的 fencing 設計,並不是靠 ActionKey 一個 hash 就能得到的保證。若 storage 本身沒有原子提交或可靠持久性,控制面也不能單方面宣稱成果發布具備原子性。
Promotion 還有另一個陷阱:候選 B 的 WNS 改善,可能同時讓 hold、transition 或另一個 corner 退步。驗收應讀取固定的完整條件集合,而非只找一行較好的 WNS。LEC、STA、DRC 與 power checks 何時必須重跑,取決於 stage 與 mutation;不能把「每次全跑 signoff」當成零成本,也不能因一個 timing 指標改善就跳過相應證據。通過的結果連同 acceptance-spec digest 一起發布,讓後續讀者知道它究竟通過了什麼。
| 失效點 | 留下的狀態 | 偵測與恢復 | 保證邊界 |
|---|---|---|---|
| Tool 尚未開始,worker 失聯 | 已提交 job,可能仍在 queue | 查 job identity,避免重複提交 | 查不到不等於不存在 |
| Checkpoint 寫到一半 | 部分檔案,沒有完整 manifest | checksum/manifest 拒絕重用,隔離 attempt | 需能判斷儲存完成 |
| 報告完成,completion receipt 遺失 | 可驗證成果,狀態未知 | 恢復驗收,再以 generation 發布 | 不要求重算來補回通知 |
| 驗收前有人改 SDC | 結果與目前需求不一致 | 比對 constraint digest,轉為支線 | 不允許新規格採用舊證據 |
重用的效益要用資源帳衡量
以作者假設的三個候選為例:共同的 synthesis/CTS 前綴合計需要 6 小時,每個候選的修復及分析需要 2 小時,三者使用相同的 compute 與 license 配置。全流程各跑一次是 3 × (6 + 2) = 24 個 job-hours;共用一次前綴,再各跑支線,是 6 + 3 × 2 = 12 個 job-hours。這是資源占用的加總,並非 wall-clock 必定減半。若三條支線能同時執行,理想 makespan 兩者都可能接近 8 小時;如果 license 限制只有一條能跑,reuse 才更直接影響完成時間。
因此平台應同時量測 compute-hours、license-hours、排隊時間、critical-path latency 與成果重用率。異質 job 不能只加總「小時」:還要以各自 CPU、memory 或 license unit 做加權。假設 manifest 解析、checksum、驗證與 metadata 管理額外花費 H,上述資源節省才是 12 − H;如果三條支線的 inputs 不同到無法共用前綴,預期節省就消失。這個算例沒有代入任何廠商 benchmark,只用來界定該如何量帳。
Cache key 也要對準語意。SDC 檔案沒改,但 Tcl include、環境變數、library search path、工具 patch 或隨機 seed 改了,結果仍可能不同。完整 key 不容易建立,尤其是有外部 side effect 的 legacy flow。我的建議是先選 inputs 可封閉的階段,遇到無法宣告的相依關係就停用該段重用;寧可多跑一次,也不要把不明來源的 database 當成可信基準。
哪些流程值得導入控制面
小團隊、單一路徑、很少分支的流程,用版本化腳本、清楚 output directory 與人工驗收,可能已有最好的成本效益。全面引入持久資料庫、controller 與 artifact service,會增加 schema migration、權限、備份與相容性維護;這些系統也會失效。工程師需要有能力在控制面停機時辨認已完成工作,而不是所有成果都被鎖在一套服務內。
值得投資的條件,是重複前綴昂貴、分支頻繁、失敗恢復耗時,而且錯誤重用的代價高。這時比較基準應該是改善過的腳本流程,而非刻意選最脆弱的現況。可以先加入 immutable manifest、輸入版本與獨立驗收,再觀察哪些狀態問題仍需要 reconciliation;不必一開始就把整條 R2G 變成分散式服務。
研究上還有三個未解問題:如何自動發現 Tcl 與工具資料庫的隱含 inputs;如何以最低成本證明跨 stage 的重用仍有效;如何在成果垃圾回收時保留足以重建決策的 provenance。Trajectory replay 也需區分「重播當時決策與證據」及「重新執行得到完全相同 placement」;後者受到工具與執行環境影響,不能從前者直接推出。
90 天內的驗證計畫
如果要快速驗證這個方向,我不會先做一個「全自動 APR Agent」。
我會先挑一個已經反覆發生、可以量化的 flow loop。
例如 post-CTS timing closure。
只做五件事:
- 定義最小
FlowSpec:objective、constraint、allowed action、acceptance criteria。 - 建立
ObservedState:WNS/TNS、area、violations、checkpoint、tool/version。 - 對每一次 action 建立 artifact lineage。
- 每個 transition 必須經版本一致、獨立持有規格的 Evidence Gate。
- 允許同一 checkpoint branch 3–5 個 candidate experiments,量 latency、reuse ratio、成功率與 cost。
如果這個 prototype 可以做到:
- process crash 後可 resume
- 相同 inputs 且驗收有效的 artifact 可重用
- failed experiment 可 isolated
- Agent 無法越權
- 每一次成功都有 evidence
- 可重播決策與證據,另行量測工具結果的可重現性
這些條件若通過實際故障注入,就能支持持久狀態與成果重用的設計。仍應量測新增 metadata、驗證與恢復的成本,再判斷是否值得擴展到其他階段。
我的判斷
未來 EDA Agent 的競爭不會停在「哪一個模型比較懂 Innovus」。
我的推論是,模型與 vendor-native agent 的選擇會持續變化;平台應避免讓成果身分與驗收規則依賴某一種模型。
難複製的是:
Engineering State
+ Artifact Graph
+ Policy
+ Evidence
+ Execution History
+ Organization-specific Methodology
如果 R2G 能把這些東西變成一套穩定的平台語意,那麼未來更換模型與 execution backend 時,就有明確的相容性邊界;仍需驗證工具介面、證據格式與版本相依,不能假設所有模型都能直接互換。
最後留下來的,是一套公司自己掌握的晶片設計控制系統。