
TPU v1 的起點:線上推論如何把晶片效率變成資料中心容量
TPU v1 值得回頭研究,是因為它把晶片設計目標直接接到線上服務的容量與成本。Google 在 2013 年面對的問題,是神經網路推論若進入大量產品,既有伺服器能否在使用者可接受的延遲內承擔需求。第一代 TPU 選擇專用 ASIC,並以低精度運算、規律資料流與既有伺服器整合,縮小完成這些工作所需的硬體預算。Jouppi,Google,ISCA 2017
資料中心的有效容量受到算力、記憶體、排隊與服務期限共同限制。通用 CPU/GPU 能服務較廣的程式,也提供成熟工具與彈性;但把 batch 放大以提高利用率,可能增加等待,未必符合線上推論的尾端延遲要求。專用硬體是否值得做,因而要先看實際工作負載、可接受的數值誤差與部署成本,才能回到乘法器數量。
這個案例帶來的長期理解是:加速器的效率必須在完整服務條件下比較。下文沿著容量需求推導 INT8、256×256 array、片上儲存與 PCIe 的選擇,並追問每個機制成功後,瓶頸會移到哪裡。
先沿圖中的服務路徑看:請求抵達之後,還要經過排隊、湊 batch 與實際推論,才能得到回應。小 batch 與大 batch 的時間分配不同;選擇專用硬體,是希望在服務期限內增加可交付的工作,而不只提高單一運算單元的峰值。
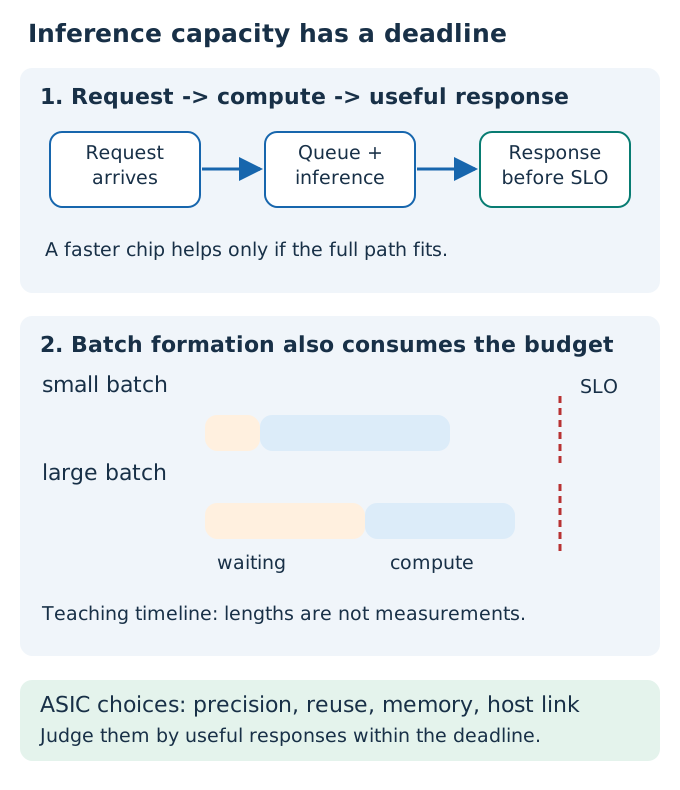
圖:作者整理的服務背景示意;時間條長度為教學假設,非 Google 量測。需求與架構依據:Jouppi,Google,ISCA 2017。
TPU 的起點:資料中心容量
2013 年的 Google 面對的問題是「如果 DNN inference 滲透到 Search、Translate、speech 等大量服務,現有機房能不能承受」,比「矩陣乘法能不能更快」範圍大得多。
如果只是單一模型速度不足,可以加 CPU、換 GPU、增加 batch size。但如果 workload 本身正在快速滲透所有產品,硬體效率直接變成資料中心的 CAPEX、電力、rack 數量和服務容量。此時,把每一次 inference 的成本下降 2 倍,效果會超出 benchmark 數字,可能等價於少蓋大量 server。
Google 的論文指出,第一代 TPU 服務的六個代表性 neural-network workloads,包括 MLP、LSTM 與 CNN,覆蓋當時約 95% 的 TPU inference workload。其中 CNN 當時只佔很小一部分;MLP 與 LSTM 才是實際資料中心的重要負載。accelerator 應該依實際 workload distribution 設計,當時最熱門的論文模型不一定具代表性。
TPU v1 因此沒有試圖成為萬用 accelerator。Google 把 training 留給現成 GPU,把第一顆 TPU 專注在 production inference。
服務端 KPI:P99 latency 與 GPU 利用率
線上 inference 有一個與 HPC 很不同的限制:使用者正在等答案。
一個 batch 越大,矩陣乘法通常越容易把 GPU 填滿,throughput 也越漂亮;但 batch 必須等更多 request 湊齊,queueing latency 會上升。對 Search、speech、Translate 這種 user-facing service,平均吞吐量高卻無法守住 tail latency,並沒有實際價值。
Google 在 TPU v1 論文中特別強調 99th-percentile response time。CPU/GPU 常見的 out-of-order execution、cache hierarchy、multithreading、prefetching 等機制,能提高平均利用率,卻也增加 execution time 的動態性。TPU 反過來選擇一個相對 deterministic 的 execution model。
這個取捨看起來「比較笨」,卻非常符合服務端 inference:
- 不追求所有程式都跑得好,只跑 neural-network inference。
- 不追求大型 batch 才能展現效率,而希望在 latency constraint 下仍維持高吞吐。
- 不需要複雜的 CPU-style speculative machinery,把 transistor budget 留給 MAC array 與 SRAM。
- execution 越可預測,scheduler 越容易估算 capacity,也越容易守住 SLO。
所以第一代 TPU 的設計目標是在 latency SLO 之內完成盡量多的 inference,「比 GPU 多多少 ALU」並不是衡量標準。
為什麼是 INT8:先把不需要的 precision 拿掉
training 與 inference 的數值需求不同。
訓練時需要更新 weights、累積 gradient,dynamic range 與數值穩定性要求高;但模型訓練完成後,許多 inference workload 可以透過 quantization,把浮點權重與 activation 轉成較窄的 integer representation。
TPU v1 因而把主力資料路徑設計成 8-bit multiply。Google 當年的論文引用硬體成本比較指出,8-bit integer multiply 相對 16-bit floating-point multiply,可以顯著降低 energy 與 area。
影響不止於「INT8 比 FP16 小一半」。
假設晶片面積與功耗預算固定,單一 MAC 越便宜,就可以放越多 MAC;同時 SRAM 與資料搬移也能用更窄的 datapath。因此 quantization 除了是 software optimization,也直接改變 silicon economics。
TPU v1 把這個優勢推到很極端:核心 Matrix Multiply Unit 是一個 256 × 256 的 MAC array,總共有:
256 × 256 = 65,536 MACs
晶片運作在約 700 MHz。如果一個 multiply 與一個 add 各算一個 operation,理論峰值就是:
65,536 × 700M × 2 ≈ 91.75 TOPS
這就是論文所報告約 92 TOPS 的來源。
92 TOPS 本身沒有神秘之處。工程上的選擇在於 Google 願意犧牲 general-purpose flexibility,換來 65,536 個低精度 MAC 可以在很小的控制成本下規律運轉。
256×256 systolic array:減少資料搬移
如果只把 65,536 個乘法器堆在晶片上,還不會自然得到高效率。能量與頻寬的主要消耗往往在 data movement,arithmetic 反而便宜。
從 SRAM 讀一次資料所消耗的能量,可能比一次窄位元 multiply-add 高得多;更不用說從 off-chip DRAM 搬資料。於是 TPU v1 使用 systolic execution:資料像波一樣穿過規律排列的 processing elements,讓同一份 weight 或 activation 在 array 內被重複使用,不必每次 MAC 都回 Unified Buffer 重新讀取。
TPU 的 MatrixMultiply 指令可以把一個 B × 256 的 input,乘上一個 256 × 256 的 weight tile,輸出 B × 256。weight 從 array 上方載入,activation 從另一方向流入,partial sum 沿規律路徑累積。
把它想成工廠輸送帶會比較精確:零件沿著固定路徑經過每一站,每一站只做自己那個 MAC,65,536 個工人都不必各自跑去倉庫拿零件。
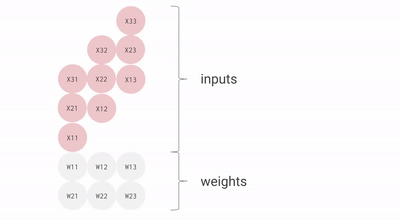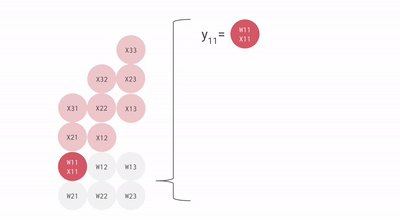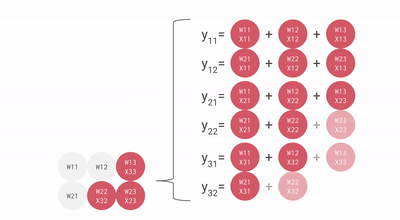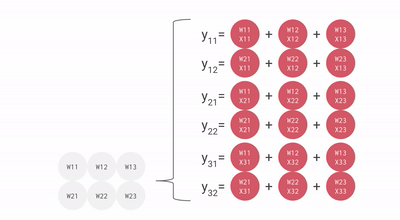
這帶來幾個效果:
- 大量 MAC 可以共享資料流,降低 SRAM read/write 次數。
- control logic 可以非常小,因為資料與計算模式高度規律。
- compiler 可以把較大的矩陣切成固定 tile,再安排 double buffering 與資料搬移。
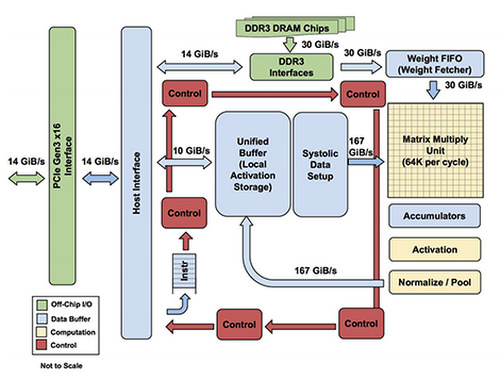
論文公開的 floorplan 很能說明設計哲學:control 只佔很小比例,大片面積留給 Matrix Multiply Unit、Unified Buffer 與 accumulators。這幾乎就是 domain-specific accelerator 的視覺化定義。
24 MiB Unified Buffer:TPU v1 與 memory wall
TPU v1 常被記住的是 256×256 systolic array,但如果只看到 compute,會漏掉下一代 TPU 為什麼必然出現。
第一代 TPU 具有約 24 MiB 的 on-chip Unified Buffer,用來保存 intermediate activation;另外有約 4 MiB accumulator memory。加總起來,論文摘要稱為約 28 MiB software-managed on-chip memory。weights 則主要放在板上的 8 GiB DDR3 Weight Memory,透過 Weight FIFO 餵給 Matrix Multiply Unit。
這個 hierarchy 大致可以看成:
Host DRAM → PCIe → Unified Buffer → Matrix Unit → Accumulators → Unified Buffer
另一條 weight path 則是:
8 GiB DDR3 Weight Memory → Weight FIFO → Matrix Unit
這是一個重要的架構分界。CPU 習慣讓 cache hierarchy 猜測什麼資料接下來會被使用;TPU 更傾向讓 software/compiler 明確安排資料的位置與搬移。代價是 compiler/runtime 必須更懂硬體,收益則是 predictability 與更低的硬體控制成本。
Google 的實測顯示六個代表 workload 中有四個受到 memory bandwidth 限制。論文甚至估算,如果把 TPU 的 memory system 換成當時 K80 等級的 GDDR5 bandwidth,實際 TOPS 可以大幅增加。
第一代 TPU 把 MAC 做得極度便宜之後,立刻撞上 memory wall。
之後 TPU v2 採用 HBM、走向 training,是順著這個瓶頸的下一步;單純把 systolic array 再放大解決不了問題。
PCIe 卡形式與既有伺服器整合
TPU v1 還有一個容易被忽略的設計決策:它是一張 PCIe Gen3 x16 coprocessor card,可以插進既有 server。
就 accelerator integration 而言並非最理想,但從 time-to-deployment 看是很好的決策。
Google 當時最重要的是快速把 inference capacity 拉上來。如果第一代 TPU 同時要求新 host CPU、新 motherboard、新 rack、新 network 與新的 programming model,整個專案可能來不及解決 2013 年看到的容量問題。
因此它採取一個很務實的切割:
- host server 繼續處理大型 application 與 control flow;
- TPU 執行神經網路的主要 tensor computation;
- host 透過 PCIe 把指令送進 TPU;
- TPU 儘可能一次把整個 model 從 input 跑到 output,減少 host-device interaction。
甚至 instruction fetch 都沒有設計成完整 processor 的樣子,由 host 把 TPU instructions 送進 instruction buffer。整顆 TPU 更接近一個大型、可程式化的 matrix coprocessor,和 CPU 相去甚遠。
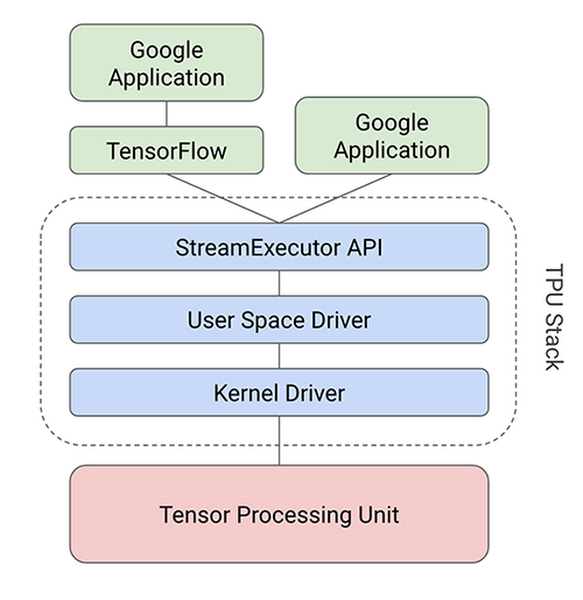
這個決策反映出一個系統原則:第一代專用硬體的最佳架構,往往是能最快嵌入既有 production system 的那一個,理論上最漂亮的架構未必適用。
TPU v1 刻意留下的未解問題
TPU v1 的成功不代表它已經是一個完整 AI supercomputer。
它沒有把 training 當成主要目標;沒有 HBM;沒有 TPU-to-TPU scale-up fabric;沒有後來的 Pod;沒有今天針對 MoE、KV cache、decode、collectives 的專門機制;sparse support 也因 time-to-deploy 而沒有放進第一版。
但這些「缺少的東西」反而很適合拿來理解 TPU 演化。
第一代先證明一件事:把 neural-network inference 的核心 operation 固定下來,可以用 ASIC 把 cost-performance 拉開一個數量級。當 compute 變便宜之後,瓶頸依序往外移:
MAC → on-chip memory → HBM → chip-to-chip interconnect → pod topology → compiler sharding → datacenter network → power/cooling
到了 2026 年,Google 已經公開第八代 TPU,並第一次把同一世代分成偏 training 的 TPU 8t 與偏 inference / post-training 的 TPU 8i;第七代 Ironwood 則已在 Google Cloud GA。Google Cloud TPU|第八代 TPU architecture deep dive
從 v1 到 TPU 8,比 TOPS 增幅更值得追蹤的,是每一代 TPU 如何處理上一代成功之後暴露出的下一個瓶頸。
下一篇就從這顆晶片最具代表性的結構往下拆:256×256 systolic array 如何讓 65,536 個 MAC 在每個 cycle 持續工作,以及 tile、weight reuse、accumulator 與 double buffering 如何共同決定實際效率。