
HLS 改變 Agent 的設計搜尋:抽象層、低階修正與成果驗收
EDA Agent 的設計能力,取決於模型與它能操作的設計空間。HLS 把 scheduling、parallelism 與 RTL generation 的部分知識放進 compiler,讓 agent 用較少決策表達可實現的計算;低階 refinement 再補回抽象層未涵蓋的選擇。這個分工的價值,應以相同需求、實際成果與完整探索成本衡量。
在晶片設計流程中,specification、程式、RTL、netlist 與 physical database 代表不同層次的承諾。抽象層提高,工程師可以先談功能、資料流與限制,細節由工具展開;抽象層降低,就能直接控制 cycle、儲存體、邏輯和時序。原本這是設計方法與工具的取捨,agent 加入後,還多了搜尋效率與有限驗證時間的問題。
這使「agent 要從哪一層開始」具有研究價值。自由度太大,可能把時間耗在機械細節;限制太多,則可能排除最好的架構。值得理解的是設計知識如何被介面保存、哪裡需要逃生口,以及驗收如何不受候選自己修改。這些問題會長期影響 EDA 平台,個別模型更新也不會讓它們消失。
圖中從相同 specification 分出 direct RTL 與 HLS 路徑,最後回到相同的成果驗收。先把搜尋介面與驗收邊界分開看,就能理解抽象層為何可能減少探索成本,以及後續 RTL refinement 為何仍須重新驗證。
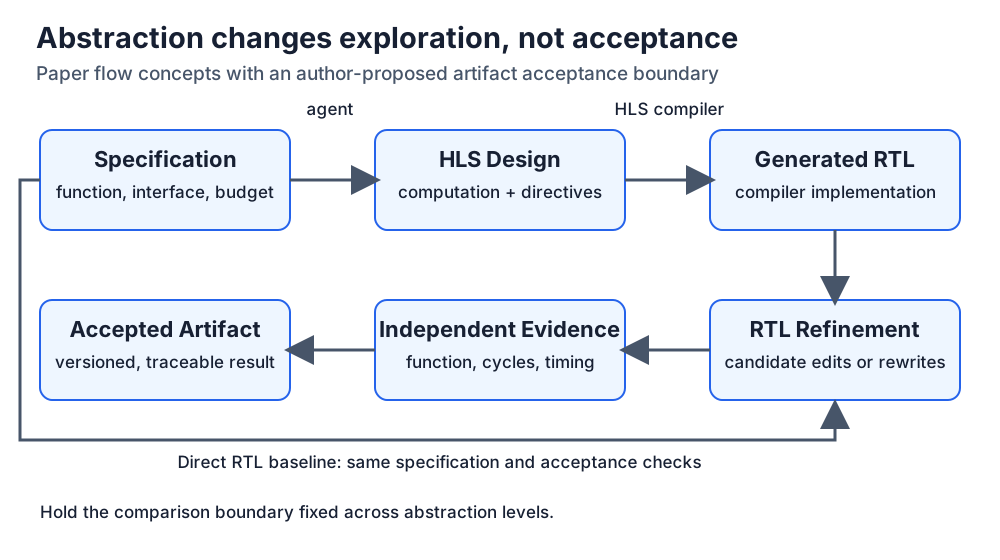
圖:作者整理;HLS/RTL flow 概念依據 AHRR 論文,成果版本與獨立驗收邊界為作者設計。Direct RTL baseline 也必須使用相同 specification 與 acceptance checks。
研究比較的是設計介面與 compiler 分工
UCLA 的 Zijian Ding 在 Can Agents Design Better Chips with a Higher Level Abstraction? 比較直接 RTL、agent-based HLS 與 compiler 產出後的 refinement。AHRR 組合 HLS 設計與後續 RTL 修正。論文於 2026 年 9 月公開,列為 ICCAD 2026 invited paper;本文討論已公開的工作,不把尚未舉行的會議寫成已發表演講。
其 11 個任務的 FPGA 實驗使用 Alveo U55C、Vitis 2025.2,採 out-of-context、沒有 shell 的評估。目標 clock period 3.33 ns,資源上限為各類資源的 60%;每階段最多五輪、每輪 agent 一小時,另有工具及總 timeout。功能以 C/RTL simulation 檢查,效能以 cycle count 乘 post-route clock period 與 target 的較大值。實驗設定
| 論文比較 | 相對 Direct RTL 的 geometric mean | 納入的有效 task/model pairs |
|---|---|---|
| Agent-based HLS | 2.31× | 15 |
| AHRR:HLS 加 RTL refinement | 2.62× | 13 |
表:依 論文 Table 3 整理;只納入有有效 Direct RTL baseline 的配對,每次實驗執行一次。這些是特定任務與條件下的 reported results。
兩列的樣本集合不同,不能把 2.62/2.31 當成 refinement 的普遍增量。Geometric mean 描述有效配對上的比例,也不直接表示完整 flow 的成功率、重試次數或 cost per success。相同 round 設定更不代表組合 workflow 的總資源成本相同:先完成 HLS,再做 RTL refinement,需要把兩段探索與工具驗證一起量帳。
這項研究支持的問題是抽象層與 compiler 知識如何幫助搜尋。將這個洞見延伸到 ASIC R2G 時,還要重新選擇設計物件與驗收方法;FPGA 的資源、memory mapping 與 routing 結果,不會自動給出先進製程 APR 的效能預測。
高階表示為什麼能縮小無效搜尋
以下先從通用設計模型分析。對一個 loop,HLS 程式可以表達計算、array partition、unroll 與 pipeline 意圖;compiler 再處理 operation scheduling、storage binding、control 與 RTL generation。直接從 RTL 開始,agent 要自己建立 datapath、控制狀態、handshake 與儲存讀寫,才有機會形成同一個候選。
這個差異包含兩種成本。第一是描述成本:一個高階 transformation 可以對應多個正確的低階操作。第二是合法性成本:compiler 在其支援範圍內協調相依、resource 與 schedule,減少 agent 必須自行維持的不變量。抽象層因此保存了部分設計知識,也限制了候選集合。論文將 HLS 的作用解讀為讓 agent 利用 compiler 所整理的設計知識。原始研究
但「限制搜尋」有正反兩面。Compiler 的 heuristics、可辨認 pattern 與 binding 選項會決定哪些架構容易表達。若最好的實作需要精確的 register organization、特殊 control 或非典型 memory mapping,高階介面可能變成阻力。直接 RTL 的自由度在這些條件下仍有價值;合理平台應讓選擇由設計問題決定,而非把「越高階越好」做成固定規則。
HLS 後接 RTL refinement,則把起始點從空白規格換成已有功能與結構的候選。Agent 可以針對局部邏輯、位寬、control 或 critical path 修正,避免重建整個設計;代價是 compiler 產生的 RTL 可能很大、命名複雜,修改後也不再由原始高階表示完整描述。平台必須保存 refinement 與原始成果的 lineage,且重新驗證修改後的語意。
一個 reduction kernel 的完整設計帳
以下是作者假設案例,並非論文 benchmark。固定介面要對 256 個 signed 16-bit 整數求和,以 32-bit 輸出精確結果;資料先放在 on-chip storage,計算期間不含外部搬運。這些數值範圍使完整和可由 32-bit 容納,驗收需包含最大正值、最小負值、混合正負與有效資料長度。若改成 saturating 或浮點運算,重排加法的合法性又要重新定義。
候選 A 每 cycle 處理八個元素,候選 B 處理十六個。理想 grouping 次數分別是 32 與 16,但加法樹、pipeline fill 與收尾仍要算入。假設 A 共 38 cycles、post-route period 4 ns,B 共 25 cycles、period 7 ns,則完成時間分別是 152 ns 與 175 ns。B 的 cycle 較少,完成時間卻較長;只用 HLS latency report 或只看頻率,都可能選錯候選。
能否每 cycle 讀取 P 個元素,還取決於 memory ports、banking 與 data layout。把 unroll factor 調成十六,不會讓一個只有兩個讀取 port 的 storage 自動供應十六筆資料。Compiler 可能序列化存取、改用更多 banks 或 registers,帶來不同 resource 與 routing 成本。驗收應追資料供應、運算與回寫三段路徑,辨認是哪一段決定 initiation interval。
Accumulator recurrence 也是限制。若前一輪的和必須先完成,下一輪才能更新,單一 pipeline pragma 不一定能形成預期的 II。可能需要多組部分和、tree reduction 或不同 schedule;每種選擇都要保留功能語意。這正是 compiler 能保存工程知識的地方,也是低階 refinement 有機會改善 critical path 的地方。
最後把外部介面放回來:若資料搬運占主要時間,縮短這個 on-chip kernel 未必改善端到端吞吐。對單次工作應量 input arrival 到 output completion;對連續工作則應量 steady-state initiation interval、backpressure 與 overlap。抽象層有沒有幫助,必須先對準需要改善的瓶頸,不能讓「較漂亮的核心結果」替代原來的需求。
延伸到 R2G:介面要承載工程不變量
以下是作者提出的 R2G 設計。HLS 啟發的是如何將常用設計知識放進介面;R2G 的對應物件可以是 stage contract、typed artifact 與具體可執行的 mutation。這不要求所有 EDA 工具先改成同一個 IR,也不要求 agent 能理解全部 Tcl。最小介面可以先界定「這個階段允許改什麼、哪些成果可接續,以及如何判定成功」。
以 placement exploration 為例,固定 synth checkpoint、floorplan、library、SDC 與 tool version,只讓候選在三組已支援的 placement parameters 中選擇。每個 action 帶有 inputs、參數、seed、resource budget 及 acceptance-spec version。介面做參數型別與範圍檢查,再產生工具專用腳本;實際 EDA engine 仍負責 placement 與分析。Typed API 能提早拒絕無效要求,但不能保證物理結果會改善。
如果 agent 只拿到任意 shell/Tcl,它可以快速接上 legacy flow,也能表達平台尚未預期的變更;同時必須自行辨認 workspace、tool state 與驗收規則。若全部改成受限 semantic API,平台可以集中維護常用 operation 的 precondition、postcondition 與資源限制,但新增方法需要工程維護,也可能排除有效的探索方向。兩者的比較應以少做了多少無效工作、犧牲多少有效候選為準。
OpenROAD-MCP API 是工具介面的一個公開參考,bazel-orfs 則提供 flow dependency 與增量執行的參考。它們與 AHRR 是不同工作,不能將各自的功能拼成一套已被論文驗證的完整平台。下面的 acceptance loop 是作者設計,研究結果沒有替這個組合背書。
資料路徑可以從 versioned intent 開始:候選選擇 action,平台建立獨立 workspace,工具產生 database 與 reports,驗證器重新開啟成果,再檢查固定條件。通過者以不可變的 manifest 記錄 inputs、tool identity、參數與證據;失敗者留在支線,不能覆蓋目前可信 state。Agent 下一輪只能讀取已標示來源與版本的結果,避免把不同候選的好數字湊成不存在的設計。
控制路徑則需處理排程、timeout、quota、cancel 與人工升級權限。Runtime 可以允許更多候選,但 acceptance-spec、clock definition 與 signoff waiver 不應由同一個探索回圈任意更改。當問題確實需要改 SDC,應建立新的需求版本,再明確比較;這樣才能區分「改善原需求的實作」與「重新定義需求」。
工具完成與成果通過,需要兩種判斷
NVIDIA 的 agent evaluation 技術文章 區分 process 與 outcome 評估。對 EDA 而言,這可對應為工具操作紀錄與工程成果驗收:command 沒有 exception,只表示某次操作沒有以該方式報錯;它不表示所有必要 reports 都來自目前 database,也不表示需求已達成。
驗收至少要固定功能、介面、constraints、resource ceiling 與量測方法,再由獨立程序檢查 persisted artifact。若候選同時有權修改 checker,就可能靠弱化測試得到好分數;若候選能改 clock period 或刪 timing exception 的檢查,報告改善也未必來自更好的設計。這些都屬於評分邊界問題,增加模型能力無法取代邊界。
「獨立」也要落到工程物件。Report parser 不應直接相信 agent 整理的 JSON;它要讀取固定版本工具輸出,確認分析對象、corner、mode 與數值欄位。功能驗證則需依 mutation 選擇 simulation、equivalence 或其他適當方法。測試通過只支持測試所覆蓋的行為;branch coverage 再高,也不能單獨證明所有數值與時間行為等價。
再考慮一個作者設計的 timeout 情境:候選已完成 route,agent 只讀到前一次報告便宣布成功。新的 database 在磁碟上,最新 STA 卻尚未完成,workspace 也可能留著舊報告。平台應以 manifest 與分析 inputs 的版本關係辨認 stale evidence,將此候選維持為「尚未驗收」。恢復時重新執行缺少的分析,不必因 completion message 遺失而盲目重跑整段 route。
如果新分析失敗或量測不符,就隔離候選,保留上一個通過的成果;如果另一個 worker 晚回來,promotion 仍要比對 state version,不能讓過期結果覆蓋新基準。這個恢復保證建立在不可變成果、完整相依關係與原子狀態更新上。缺少其中一項,所謂 replay 可能只是再次執行一串工具,而沒有保存當時決策的工程語意。
公平評估要把探索與驗證一起量帳
設計品質與找到設計的成本是不同指標。對 agent 平台而言,完成一個候選需要模型推理、工具執行、queue、驗證與資料存取;其中最慢的一段會限制可探索候選數。抽象層若讓程式更快產生,但每個候選要更久才完成 routing,固定一天的研究預算下也可能看不到收益。
作者會設計兩組比較:固定候選輪數,觀察介面對設計品質的影響;固定 wall-clock 與 compute/license budget,觀察可交付成果的影響。兩組都有價值,不能混在同一個 speedup 裡。對 HLS 加 RTL refinement 的雙階段路徑,要記錄各階段花費,再與同樣總預算下的直接 RTL baseline 比較,才知道額外 refinement 的成本是否值得。
以作者假設的八小時實驗為例,若每個完整驗證平均一小時,最多只有約八次串行回饋;模型把候選生成從十分鐘降到一分鐘,並不會帶來十倍有效探索。若早期檢查能在五分鐘拒絕功能錯誤,則可以把昂貴的 physical evaluation 留給較有希望的候選。這種分級驗證會改變搜尋效率,但早期 gate 不能誤殺只有後段才看得出優勢的架構。
除了最好一次的 QoR,我會記錄多次執行的成功率、分布、有效候選數、總工具時間、失敗原因及每個通過成果的成本。沒有有效 baseline 的任務不能硬塞進速度比例,卻仍需出現在成功率與成本統計。否則把困難任務排除後,平均 speedup 會看起來很好,平台能交付的範圍卻沒有被正確呈現。
驗收也應抵抗任務洩漏。開發用的 stimulus 可以公開,測試用的 corner cases 則應保留獨立性;任何資料規模、shape、數值範圍或介面限制,都要事先定義。Agent 若只針對某一 stimulus 寫死結果,或假設原本允許變動的維度固定,功能上就不是同一個任務。這類錯誤要由 checker 偵測,不能期待每輪 prompt 提醒就會消失。
抽象層的維護成本與逃生口
高階介面把知識集中,也會集中維護責任。工具版本改變、report schema 調整或新 cell library 導入,都可能讓 lowering 與驗收失效。平台需要有自己的 regression cases,確認 operation 的語意與 report 解讀仍一致;否則 agent 的輸入看似穩定,底下卻已換成另一個工程問題。
適合被抽象的 operation,通常有反覆出現的意圖、可界定的 inputs,以及穩定的驗收方法。探索性的特殊架構、一次性 debug 或工具尚未暴露的控制,可能仍需要低階操作。逃生口可以保留,但使用後要記錄額外 mutation、擴大相依範圍並重做適當驗證;不能讓一個未追蹤的 Tcl command 破壞所有 cache 與 lineage 的假設。
平台導入也應比較改善過的基準流程。若現有腳本已把必要知識保存得很好,額外 API 可能只增加包裝成本。作者會先挑重複出錯、驗證昂貴且結果可獨立評分的小閉環,再確認介面確實降低 failure rate 或 cost per success。有效之後擴張,才能避免把平台規模當成研究進展。
我的判斷
以下三點是作者推論。
第一,EDA Agent 的競爭會包含設計介面與 compiler 所承載的知識。相同模型在不同 abstraction 下的結果,應被當成不同系統來評估;把模型排名直接外推到硬體設計能力,會漏掉工具與搜尋空間的影響。
第二,高階起步、必要時低階修正,是值得測試的分工。其收益需要與額外驗證、lineage 維護和候選成本一起比較;對 register-scale、特殊控制或強 target dependence 的問題,直接低階設計仍可能合理。選擇應由 bottleneck 與證據驅動。
第三,R2G 最可長期保存的資產,是固定需求下的設計語意、成果版本與驗收方法。模型可以更換,探索可以失敗,但每個被接受的成果必須能回答「對哪份需求、用什麼 inputs、經哪些檢查而成立」。這個邊界越清楚,自動探索才越有機會擴大。
接下來值得研究的問題,是如何量化介面縮減了哪些無效搜尋、又排除了哪些好設計;如何以完整成本比較組合 flow;以及如何在 refinement 後維持跨層語意與獨立驗收。最小實驗可以選一個 kernel 或一個 APR 閉環,固定模型、需求、總預算與 checker,反覆比較兩種抽象層。這樣得到的結果,才會增加對平台設計的理解。
References
- Can Agents Design Better Chips with a Higher Level Abstraction? — Zijian Ding, UCLA;ICCAD 2026 invited paper / arXiv, 2026.
- How to Evaluate AI Agents From Tool Calls to Task Completion — NVIDIA Technical Blog, 2026.
- OpenROAD-MCP API — The OpenROAD Project.
- bazel-orfs — The OpenROAD Project.