
400G/lane 光互連的設計代價:頻寬密度、DSP 功耗與電氣距離
AI fabric 的容量擴張,同時受到 ASIC I/O、封裝邊界、面板空間與散熱限制。400G/lane 的長期價值,在於用較少通道搬運相同資料量,讓有限的實體邊界容納更多有效頻寬;成立條件是每條高速通道增加的訊號處理與功耗,沒有吃掉省下的成本。單看 lane rate 或製程節點,無法回答這個問題。
資料中心互連的任務,是讓運算、記憶體與儲存之間的資料交換跟上系統需求。增加鏈路數原本是直接的擴充方法,但每個通道都要經過 package escape、電氣走線、光電轉換與連接器;這些資源不能隨 ASIC 的邏輯密度一起縮小。當系統希望在同一機箱或 rack 中提高交換容量,單位邊界的頻寬就成為值得獨立研究的設計變數。
Marvell 的 ECOC 2026 公告 提出 2nm、400G/lane PAM4 光互連展示。它延續了 OFC 2025 公布的 224 Gbaud electrical-to-optical link。這條技術路徑的重要性,是讓「增加 lane」之外的設計空間有了實體證據;接下來要理解的,是較少 lane 究竟把成本移到哪裡。
先沿圖中的資料路徑走一次:有效資料必須跨過 ASIC、package/PCB、光電轉換與光纖,再由接收端還原。增加 lane 會占用更多實體邊界,提高每 lane 速率則把負擔移向訊號裕量與處理功耗;圖下方列出的預算,是後面比較方案時要一起核對的條件。
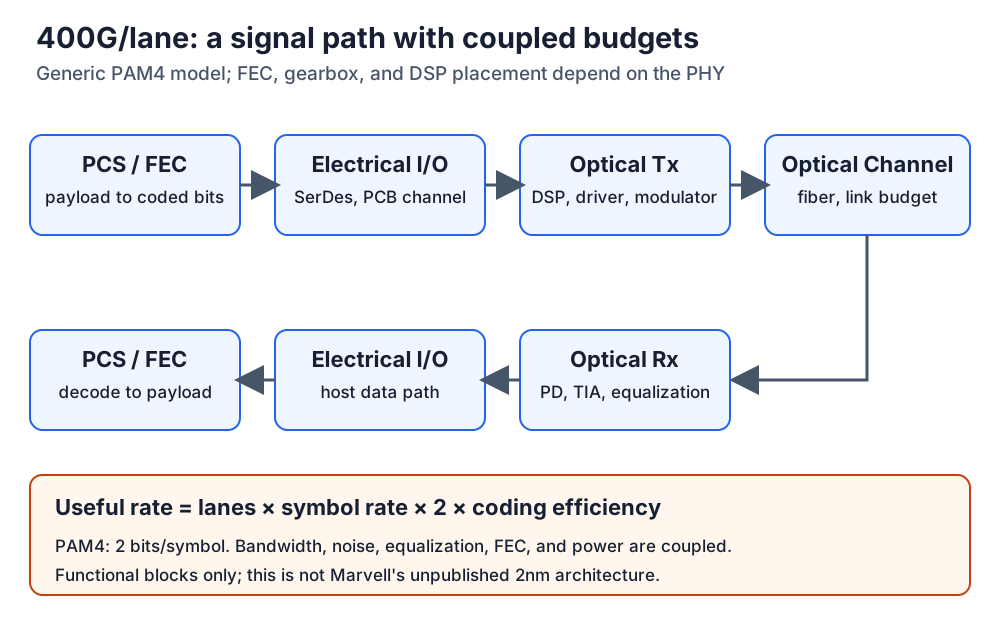
圖:作者整理;功能路徑參考 Marvell OFC 2025 electrical-to-optical demonstration。圖為通用 PAM4 模型;FEC、gearbox 與 DSP 的實際位置依 PHY 架構而定。
先固定比較單位:400G 是哪一段的速率
PAM4 每個 symbol 有四個電平,可表示兩個 bit。以下採最簡單的速率帳:
R_useful = N × f_symbol × 2 × η
其中 N 是平行 lane 數,η 是從 raw line bits 到指定「有效資料」定義的效率,包含該比較邊界內的 coding、framing 或其他 overhead。224 Gbaud 對應每 lane 448 Gb/s 的 raw bit rate,是直接的算術;它不能單獨告訴我們 payload throughput、採用哪個 FEC,或「400G」在產品名稱中的精確定義。
若以 400 Gb/s useful rate 配對 448 Gb/s raw rate,算出的 η 約為 0.893。這只是兩個數字在同一邊界下成立時的比例,不能拿來反推未公開的 code rate。比較不同技術時,應分開列 raw rate、PCS rate 與 application goodput;否則更強 FEC、多一層 encapsulation,甚至不同的雙向計數方式,都可能混進「每 bit 更省電」的分母。
八條 400G lane 可形成名目 3.2 Tb/s aggregate,同樣容量也可以用十六條 200G lane 組成。這個比較揭露了 density 的來源:通道數減半。然而,光 lane、host electrical lane 與 fiber 數不一定相等。一條 fiber 可以承載多個 wavelength;host 也可能經過 gearbox。由「八條 optical lane」直接推導「八條 host SerDes」或「八根 fiber」,會錯估 package、DSP 與佈線成本。
例如,作者可構想一個 host 保持十六條 200G、optical side 改為八條 400G 的介面。這會改善光側密度,但 host package escape 並未同步減半,而且 gearbox、lane alignment 與 clock-domain 邊界仍要付成本。是否值得做,取決於目前最稀缺的是光元件、host I/O,還是 electrical reach;這是系統選擇,並非廠商已公布的 2nm block diagram。
Symbol rate 上升,把 channel 的高頻損耗放大
在理想的零 excess-bandwidth 基頻模型中,224 Gbaud 的 Nyquist frequency 是 112 GHz。這是 symbol rate 除以二得到的量級,不表示實際 transmitter、receiver、封裝或量測儀器只要支援到該頻率就足夠;pulse shaping、有限 rise time、equalizer 與實作裕量會改變所需頻率響應。
電氣 channel 可抽象為 impulse response h(t)。Receiver 看到的是發送波形與 h(t) 的 convolution,加上 noise、jitter 與非線性失真。走線和 connector 在高頻的衰減,使相鄰 symbol 的影響拖到當前取樣點,形成 inter-symbol interference。這個瓶頸來自通道和取樣條件,不能靠「DSP 使用更先進節點」一句話消除。
PAM4 本身也有明確的裕量代價。若固定峰對峰擺幅,並假設四個電平均勻分布,symbol 到最近 decision threshold 的距離是 Vpp/6;兩電平訊號在同一假設下是 Vpp/2。三分之一的判斷裕量,說明 noise、level mismatch 與 threshold offset 為何重要。這不是無條件的 SNR penalty:改用平均功率、不同 driver swing 或不同 coding,比較結果會變,必須先固定限制。
Equalization 可以重新分配頻率響應、抵銷部分 ISI,但補高頻時也可能放大 noise;feedback-based cancellation 又受到錯誤傳播與延遲限制。提高 tap 數、ADC 頻寬或解析度,通常會增加運算、類比前端與資料搬運負擔。真正的工程問題是:在允許的 channel loss、反射、溫度與製程變異下,需要多少補償才能把 pre-FEC error 放進可接受區域。
因此,electrical reach 應理解為一組 channel 條件。兩條相同長度的 PCB trace,若材料、via、connector 或 package discontinuity 不同,可能有完全不同的裕量。以公分數比較 DSP-based optics、LPO 與 CPO,卻沒有對齊 insertion loss 與 reflection mask,會把拓樸差異誤認成技術優劣。
一條完整光互連的資料與訊號路徑
從有效資料開始,PCS/FEC 將資料編碼成可傳送的 sequence,host electrical I/O 再穿過 package 與 PCB 到光端。Transmit side 的訊號處理、driver 與 modulator 把 electrical symbols 轉成光訊號;經過 fiber、coupling 與連接器後,photodetector 和 TIA 把接收光訊號轉回可判斷的 electrical waveform。Receiver 進行所需 equalization、clock recovery 與 decoding,最後交還資料。
這些方塊不是都會放在同一顆 DSP,也不是每條介面都會經過一次相同的 FEC。Marvell 的 2025 公告明確列出 PAM4 DSP、TIA、modulator driver 與 photonics 的展示組成,但沒有公開到足以重建每個內部資料路徑的程度。本文的圖只表示功能相依,不把作者模型畫成廠商晶片架構。OFC 2025 公告
Optical link budget 和 electrical eye margin 也不能互相取代。增加 launch power 可能補光路 attenuation,卻無法直接修復 host connector 的反射;改善 DSP 的 ISI cancellation,也不能讓 photodetector 憑空接收到缺少的光子。最後的 error rate 是整條路徑共同產生,驗收要能區分哪一段先耗盡裕量,才能選對修復方式。
FEC 在這裡承接殘餘錯誤。它讓一定程度的 raw error 不會直接變成 packet loss,但 decoder 的 correction capability 有限,也增加 latency 與能耗。若錯誤呈現 burst、lane correlation 或特定 pattern,平均 BER 可能掩蓋真正的 failure probability。比較時要保留 code、interleaving、error distribution、測試時間及 post-FEC uncorrectable event;只報一個 pre-FEC BER,無法完整描述系統可靠性。
2nm 能改善哪些功耗,哪些仍要另外量
較先進的 CMOS 節點為數位邏輯、運算密度與切換能量提供改善空間;實際成果還受 operating voltage、clock rate、memory access 與 implementation 影響。光互連中的 driver swing、TIA noise、光源效率與 modulator 所需條件,則不會自動按數位邏輯的比例縮小。將整個模組的功耗改善歸因於 DSP 製程,會漏掉固定與類比成本。
作者用下列一階預算拆開比較:
P_path = N × P_fixed_per_lane + R_useful × E_variable + P_shared
P_path 的邊界固定為一條單向完整互連,包含兩端在此方向的相關電路;P_fixed_per_lane 是每 lane 合計的固定成本,E_variable 是以 useful bit 為分母的可變能耗,P_shared 是共同控制與支援成本。這只是分析模型,沒有假定它能完整擬合任何廠商晶片。
在 3.2 Tb/s 下,1 pJ/bit 就是 3.2 W。假設十六條 200G lane 的固定成本各為 0.25 W,變動能耗為 5 pJ/bit,得到 4 + 16 = 20 W,加上共同成本。若八條 400G lane 固定成本仍各為 0.25 W,變動能耗增加到 5.5 pJ/bit,則是 2 + 17.6 = 19.6 W。Lane 減半,在此算例中只省 0.4 W;若新 lane 的固定成本更高,結果可能反轉。
這組數字全是作者假設,用來說明 density 與 energy 是不同的最佳化目標。400G/lane 可以讓面板或封裝容納更多頻寬,即使完整路徑 pJ/bit 沒有改善,仍可能有價值;但系統要接受相應的散熱與供電需求。反過來,較省電的低速 lane 若占用過多 I/O,也可能無法形成需要的交換容量。
完整比較還要列 active/idle power、雙向或單向計數、FEC overhead、光源是否納入、溫度及支持的 channel loss。只用 DSP die 的瓦數除以名目總速率,不能回答 rack 消耗多少電力。這也是未公開 module power 與測試條件為何會影響架構判斷,而非只是等待更多產品資訊。
更快的 lane,不必然縮短訊息完成時間
比較 8 × 400G 與 16 × 200G 時,aggregate bandwidth 相同。若資料能理想分散到所有 lane,同一訊息的 serialization time 也相同。以作者算例的 4 KiB 為例,在 3.2 Tb/s 下只算資料位元的 serialization 約為 10.24 ns,沒有納入 framing、FEC、propagation、排隊或端點處理。若應用本來只取得較小的服務速率,則應用看到的時間要以那個速率計算;不能直接拿 port 名目頻寬代入。
Lane rate 改變後,clock recovery、lane deskew、gearbox 與 decoding 的 latency 可能改變。假設某個 decoder 必須收齊 C 個 coded bits 才能開始輸出,C/R_coded 就是等待預算的一部分;用更多 parallel logic 提高 decoder throughput,並不自動移除收齊區塊的等待。反之,streaming decoder 的等待模型又不同。沒有實際 code 與 implementation,不能由 symbol rate 推估整個 PHY 的 latency。
Clocking 的量級也值得單獨看。224 Gbaud 的 symbol interval 約為 4.46 ps;作者假設 100 fs 的取樣時間誤差,已占這個 interval 約 2.24%。在 112 Gbaud 下,同樣誤差約占 1.12%。這只說明 normalized timing uncertainty 增加,並不表示 BER 恰好加倍。實際誤判還取決於取樣點斜率、clock-recovery transfer function,以及 jitter 是否與 data pattern 相關。
這讓量測的重點從「平均 eye 看起來開著」移到裕量分布:不同電平 transition、lane skew、頻率漂移與溫度下,最差條件的判斷距離還剩多少。若校準只對某個短 pattern 有效,長時間或不同資料分布就可能暴露殘餘 ISI。完整 link demonstration 的價值因此高於分別展示單一元件頻寬;但要比較系統選擇,仍需相同 pattern、channel 與 error target。
頻寬密度還有熱與拓樸兩個邊界
即使每 bit 能耗下降,總頻寬增加也可能提高局部功率密度。作者以簡化熱模型 Tj = Ta + P × θ 說明:如果散熱路徑的等效 thermal resistance θ 沒有改善,增加集中在同一區域的功率 P,就會提高 junction temperature。真實 assembly 有多個熱源與耦合,θ 也不是永遠固定;這個模型只用來指出「更省電的 bit」與「更容易散熱的 package」不能畫上等號。
溫度又會回到訊號品質,形成耦合:高密度放置改善 package I/O 面積,卻可能增加光源、類比前端與 DSP 的熱干擾,要求更多校準或更大裕量。比較應量測持續滿載後的穩態,而非只用冷機短測;若需要降額工作才能維持 error target,density 應以可持續的容量計算。這是一個可驗證的工程問題,不能靠名目 Tb/s 回答。
Switch radix 則需要與 lane 組合方式分開。相同 ASIC aggregate capacity 下,採較大 port 可以減少 port 數;這可能降低某些纜線與管理負擔,也可能讓更多端點共用較粗的拓樸單位。400G/lane 本身沒有指定 port size、oversubscription 或 collective mapping。作者會先固定 workload 的 traffic matrix、failure budget 與所需 bisection,再比較 lane rate 如何幫助實作該拓樸,避免由 PHY 規格直接跳到 cluster 效能。
Pluggable、LPO 與 CPO 分配不同責任
下面是作者依功能邊界整理的比較,並非對任何尚未公開 400G/lane 產品的效能排名:
| 選擇 | 主要設計槓桿 | 需要承擔的限制 | 必須對齊的比較條件 |
|---|---|---|---|
| DSP-based pluggable | 在模組側處理訊號,保留插拔服務邊界 | 模組 DSP 功耗、host channel、面板散熱 | 模組完整功耗、electrical loss、FEC 與 reach |
| Linear pluggable | 簡化模組處理,依賴 host 與整條線性路徑 | 系統共同設計、端點匹配、裕量與校準 | host 增加的功耗及相同 channel/error target |
| Co-packaged optics | 縮短 ASIC 到 optical engine 的電氣路徑 | 封裝、熱、光源、fiber attach 與維修邊界 | package-level power、良率、故障更換範圍 |
提高 lane rate 會增加縮短 electrical path 的吸引力,但這不會自動決定封裝形式。Pluggable 的維修彈性、供應商互換及庫存模型有系統價值;CPO 若降低電氣損耗,卻把光元件故障擴大成昂貴 assembly 的更換成本,也需要重新計算總持有成本。LPO 的省電則要把 host side 的責任與能耗一起放進帳,不能只比較模組標籤。
Reach 也會改變方法。短距離 IM-DD/PAM4 與 campus coherent-lite 解決的 channel 不同;Marvell Aquila product brief 所列 2–20 km、800G/1.6T 是 coherent-lite 的產品目標,不能當成這條 400G/lane PAM4 路徑的 reach 證據。距離增加後,是否改用 coherent 應由 loss、dispersion、power 與成本共同決定。
當裕量耗盡,系統看到什麼
以作者假設的高溫故障為例:某個通道在冷機測試可正常解碼,長時間高負載後,光輸出、receiver noise 或 channel response 漂移,使錯誤增加。Equalizer 與 FEC 在初期可能仍維持可用資料流,應用層看不出異常;當 correction capacity 被超過,才出現 uncorrectable block、link recovery 或可見資料遺失。具體回復行為依 PHY 與 transport 而定。
因此可觀測性至少要能分辨校準狀態、pre-FEC error、uncorrectable events、溫度與光功率,並保留時間關係。單一均值無法判斷這是瞬時干擾、老化,還是散熱不足造成的週期性退化。故障注入也應涵蓋多 lane 同時受熱或共同光源問題,避免只測獨立隨機錯誤。
恢復可以包含重新校準、切換可用路徑或更換故障部件;降速只有在介面與系統明確支持時才是選項。若 recovery 需要整個 aggregate link 重啟,lane 數減少並不表示故障影響較小。較高 port capacity 也讓一次 port failure 失去更多絕對頻寬;拓樸冗餘與 spare capacity 必須按失效單位重新量帳。
我的判斷與接下來要追的證據
以下是作者推論。
第一,400G/lane 最值得保留的 insight,是 I/O 密度改善會把負擔從通道數移到每通道的訊號與熱設計。未來比較應以「在指定 loss、reach、error target 與溫度下的 useful Tb/s」為單位,配對完整路徑功耗與面積,才能看見新的可行邊界。
第二,host electrical interface 若跟不上 optical lane,gearbox 可以形成過渡路徑,但 density 收益將落在光側;不能預期 package routing、SerDes 數量與前面板同時按相同比例縮小。哪一段先升級,需要從當前 bottleneck 出發。
第三,400G/lane 是否推動 CPO,取決於 electrical path 省下的裕量與功耗,能否支付封裝、維修及光源分配的成本。現有展示支持技術路徑值得深入追蹤,尚不能直接推導各部署模型的成本排序。
我接下來會追三組資料:完整 Tx+Rx 路徑的 pJ/useful bit 與測試條件;跨溫度、channel loss、製程與老化的 error margin;以及實際 assembly 的 bandwidth density、良率與可維修失效單位。這些資料才會回答,400G/lane 在固定系統預算下增加多少有效容量,以及下一個瓶頸移到了哪裡。
References
- Marvell Demonstrates Industry-First 2nm Optical Technology for AI Data Center Infrastructure at ECOC 2026 — Marvell, 2026.
- Marvell to Demonstrate Industry’s First 400G/lane PAM4 Electrical-to-Optical Link Technology at OFC 2025 — Marvell, 2025.
- Aquila Coherent-Lite DSP Product Brief — Marvell, 2024.