
256×256 Systolic Array 的供料條件:TPU v1 如何重用資料
TPU v1 的 systolic array 把矩陣乘法轉成規律的資料重用流程;65,536 個 MAC 的峰值只有在 operands 及累加狀態能持續供應時才成立。研究這個結構,重點是理解如何降低每次運算需要支付的搬移與控制成本,以及哪些 shape 會讓它失去效率。
神經網路的線性層與 convolution 可以形成大量重複的乘加。若每個 MAC 都獨立回到大型儲存體取得 operands,所需的記憶體埠、連線與功耗會隨並行度增加。規律陣列讓相鄰單元傳遞資料,把重用安排在空間與時間上;代價是軟體要把工作切成硬體能承接的 tiles。Google TPU v1 deep dive
在第一代 TPU 的服務需求之後,這篇把視角縮到一條 matrix instruction。由 MatrixMultiply(B) 追到 weight load、pipeline 與 shape utilization,便能看出「更多 MAC」何時增加吞吐量,何時只增加等待資料的硬體。
圖上半部把每個 MAC 都獨立取得資料的成本畫出來,下半部則以小陣列示意相鄰單元的資料傳遞。先觀察 activation 橫向流動與 partial sum 向下累積:規律重用能降低大型儲存體的供應負擔,但仍要讓資料在正確的 cycle 相遇。
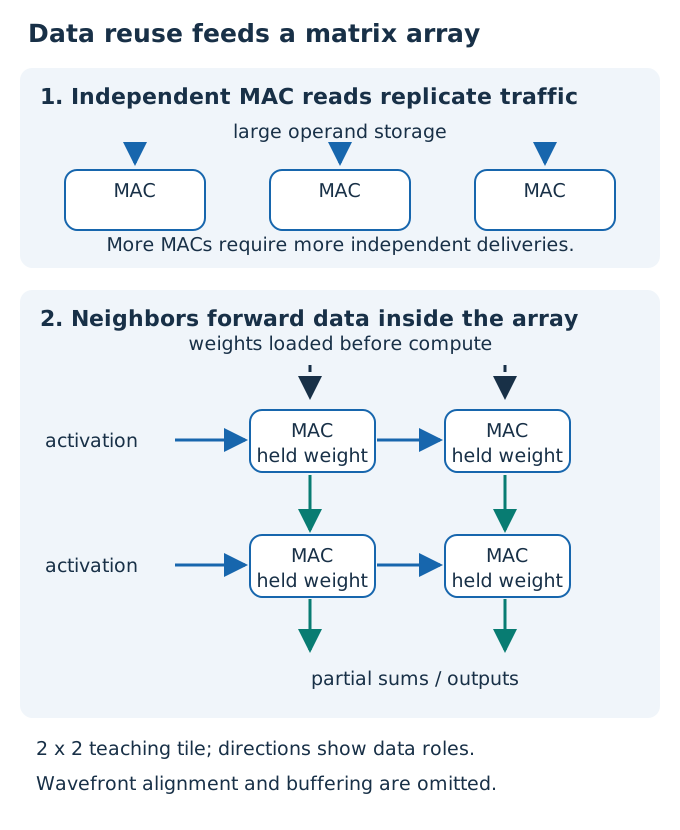
圖:作者整理;2×2 為教學示意,省略 wavefront 對齊與 buffering,不代表 TPU 的實際陣列大小。資料流概念依據:Google TPU v1 deep dive。
92 TOPS 只是算術上限,資料必須先供得上
TPU v1 的 Matrix Multiply Unit 是 256 × 256 個 8-bit MAC,共 65,536 個運算單元。晶片頻率約 700 MHz,因此理論 MAC throughput 是:
65,536 × 700M ≈ 45.9 TMAC/s
若把 multiply 與 add 各算一個 operation,就是約 91.8 TOPS,通常寫成 92 TOPS。Jouppi et al., ISCA 2017|Google Cloud TPU v1 deep dive
但如果這 65,536 個 MAC 每個 cycle 都各自從 SRAM 讀兩個 operand,再把結果寫回 SRAM,記憶體埠數、wire、energy 與面積會先失控。Google 對第一代 TPU 的描述很直接:systolic array 讓一次讀進來的資料在相鄰 ALU 間繼續流動,不必反覆經過 register file 或大型 SRAM。
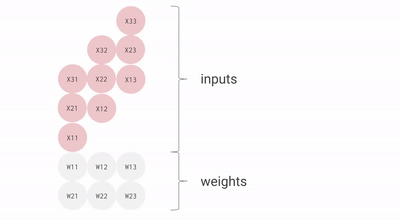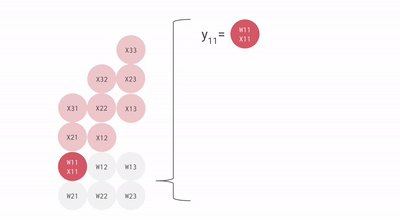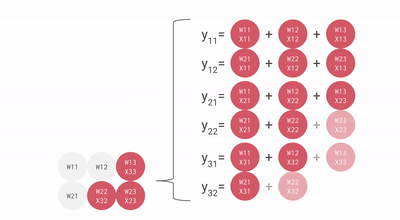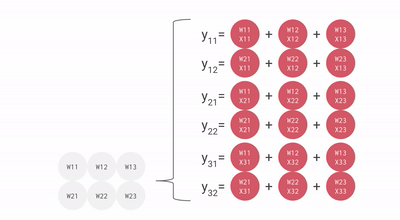
從晶片設計角度看,這個差異非常大。長距離讀 register file 或 SRAM,需要 decoder、wordline、bitline、mux 與較長 interconnect;相鄰 MAC 間的短 wire 則單純得多。當演算法本身具有高度規律的 data reuse,硬體就可以把「資料搬移」從反覆 memory access,改成鄰近 processing element 間的 forwarding。
MatrixMultiply(B) 已經把硬體形狀寫進 ISA
TPU v1 有一條 matrix multiply instruction,而這條 instruction 的 operand shape 幾乎直接揭露了硬體結構。
論文中的 MatrixMultiply/Convolve 接受一個可變大小的 B × 256 activation matrix,乘上一個固定 256 × 256 weight tile,輸出 B × 256,並在權重已就位後以 B 個 pipelined cycles 完成。ISCA 2017
也就是:
[B × 256] × [256 × 256] → [B × 256]
這和一般 CPU ISA 的思路不同。CPU 的 instruction 描述一次 scalar/vector operation;TPU 的 instruction 描述一整塊 tensor computation。軟體看到的是 MatrixMultiply(B),硬體看到的則是:256-wide activation stream 應該持續餵入一個已經載好 weights 的 256×256 array。
TPU v1 的 dataflow 可以粗略理解成「一個 weight tile 在陣列中停留一段時間,activation rows 持續流過它」。嚴格說來,Google 的公開資料描述的是 weights 預先載入、input 從另一方向流入;用現代 accelerator 術語看,它具有明顯的 weight-stationary 特徵。比起分類名稱,更有用的事實是同一組 weights 能被 B 個 input rows 重複使用。
假設 B=256,一個 64 KiB weight tile 載入後可以連續處理 256 列 activation。若 B=1024,同一組 weights 的成本會被更多 input rows 攤薄;若 B 很小,weight load 與 pipeline overhead 就會顯得昂貴。這也是 latency-sensitive inference 永遠存在的矛盾:batch 做大,array 比較容易吃滿;batch 做小,tail latency 比較好,但硬體效率下降。
Double buffering 與 weight load 的時間重疊
TPU v1 的 Matrix Unit 可以容納一個 64 KiB weight tile,另外再放一份 tile 做 double buffering。Google 論文指出,將一個 weight tile shift 進 array 需要約 256 cycles;第二份 buffer 的目的,就是在目前 tile 計算時,同時準備下一份 tile。ISCA 2017
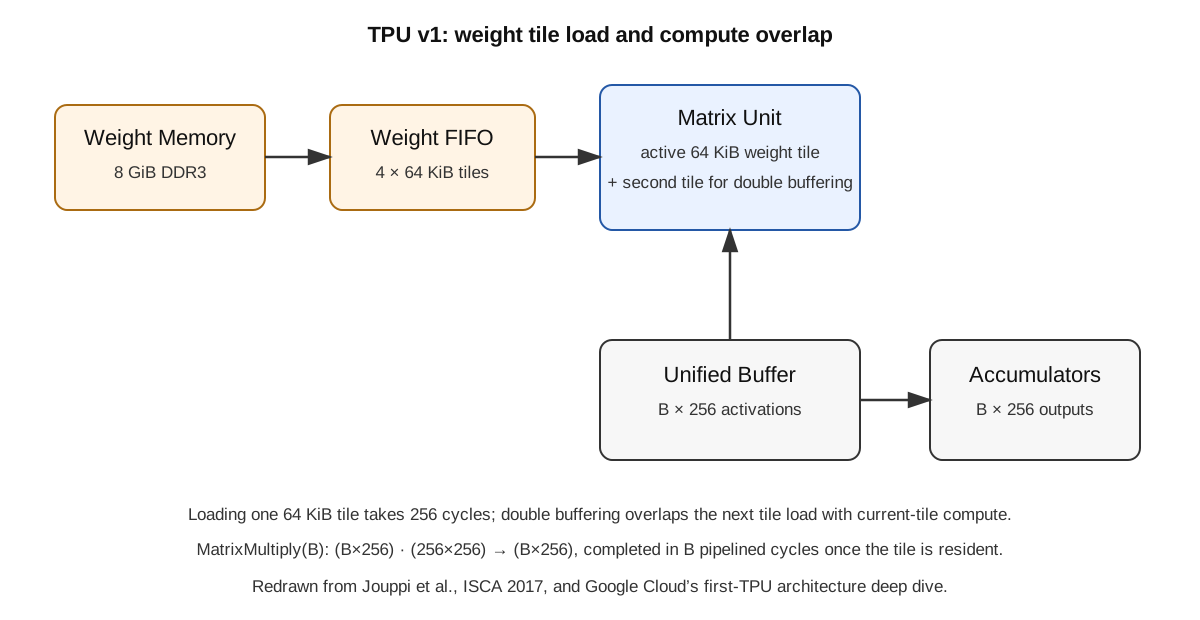
這裡可以直接做一個簡單推導。
若目前 tile 的 MatrixMultiply(B) 只有 B=64,compute 本身只有 64 個 pipelined cycles;下一個 weight tile 卻需要約 256 cycles 才能完全載好。即使有 double buffering,還是可能等 weights。
若 B=256,compute window 也有 256 cycles,理想情況下剛好可以把下一個 tile load 藏掉。
若 B=1024,weight load 相對更容易被完整 amortize。
可見 systolic array 的 throughput 不能只用 array size 一個數字描述。實際 throughput 大致是:
array utilization × data reuse × pipeline overlap × memory availability
少掉任何一項,65,536 個 MAC 都可能只是晶片上的閒置面積。
256 這個維度會一路反向約束 compiler
固定大小的 array 帶來效率,也帶來 rigidity。
假設某一層的內積維度正好是 256,hardware tile 可以完整利用。如果是 512,可以乾淨切成兩個 256 tile。如果是 320,至少需要兩個 tile:第一個用滿 256,第二個只有 64 個有效欄位。
只看這一個維度,平均有效 utilization 大約是:
320 / (2 × 256) = 62.5%
其餘 37.5% 的陣列位置可能被 padding 或無效工作吃掉。實際 compiler 還可以藉由 batch、feature dimensions、convolution lowering 等方式重新排 layout,但核心問題不會消失:演算法的 tensor shape 必須被切成硬體喜歡的形狀。
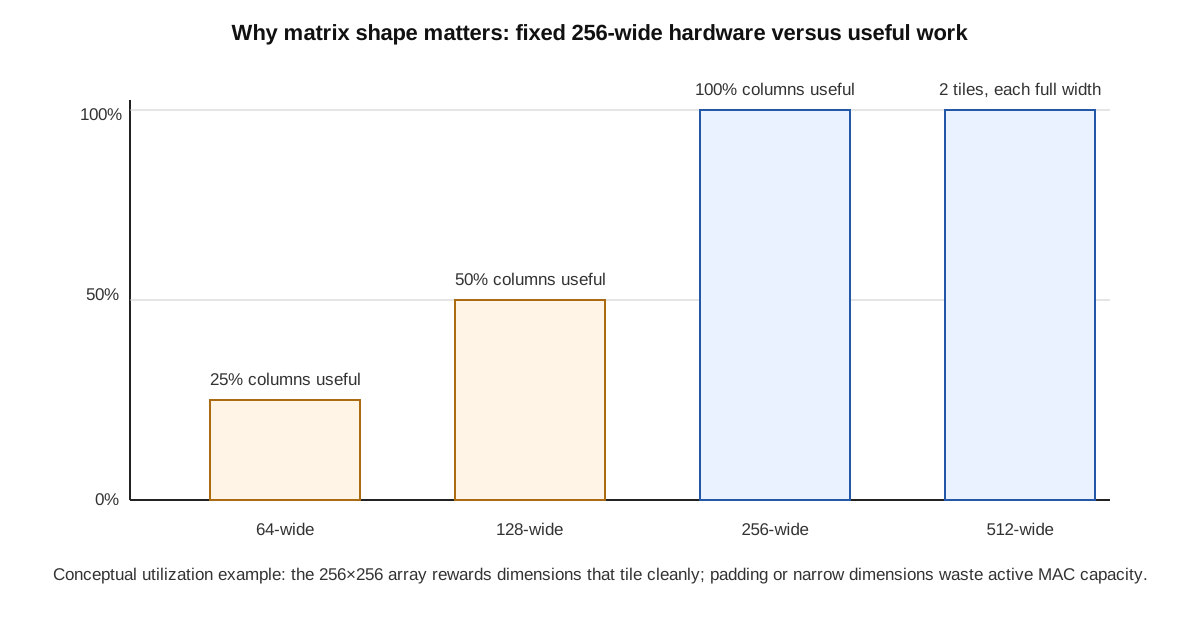
因此 accelerator 與 compiler 必須一起看。當 hardware 固定為 256×256,compiler 除了「把 TensorFlow operator 換成 TPU instruction」,還必須處理 tiling、padding、layout、buffer placement,以及哪一段 computation 值得留在 MXU、哪一段交給其他單元。
今天 Google Cloud 的 TPU 文件仍然直接提醒使用者:XLA 會根據 MXU 的實際幾何形狀做 tiling,而 tensor dimensions 是否容易被 tile 會影響效率。Cloud TPU introduction 這個問題從 v1 到現代 TPU 並沒有消失,只是 array size、precision、compiler 與 workload 都已經更複雜。
Systolic array 解決 data movement,下一個牆就變成 memory bandwidth
TPU v1 的 systolic array 很成功地降低了 MXU 內部反覆讀寫 SRAM 的需求,但它無法消滅更外層的資料搬移。
weights 還是要從 8 GiB DDR3 Weight Memory 經 Weight FIFO 送進 Matrix Unit;activations 還是要待在 24 MiB Unified Buffer;partial sums 還是要進 4 MiB Accumulators。當 MXU 變得非常快,瓶頸自然往外移。
Google 的實測結果正好證明這件事:六個代表性 production workloads 中有四個受到 memory bandwidth 限制;論文甚至估算,如果把 TPU 的 memory system 換成當時 NVIDIA K80 等級的 GDDR5 bandwidth,achieved TOPS 可以接近三倍。Jouppi et al., ISCA 2017
這是一個很典型的 accelerator 演化路徑:
先把 arithmetic 做便宜 → data movement 成為主成本 → 再把 memory hierarchy 往前推
理解 TPU v1 的 systolic array,不應停在「Google 用了 256×256 MAC」。Google 把 matrix multiplication 重新表達成一條資料重用流水線,讓 operand 儘量留在晶片內、沿著鄰近 MAC 移動;這個方法成功後,整個系統的瓶頸隨即從 arithmetic 轉移到 memory bandwidth。
下一篇會沿著這個因果鏈繼續往下:TPU v1 為何把主資料路徑壓到 INT8。低 precision 除了是模型壓縮技巧,也直接決定一顆晶片能放多少 MAC、SRAM 要多寬、memory bandwidth 可以服務多少運算,以及最終每瓦能換到多少 inference。