
EDA Agent 的評分要跟著同一份設計與執行結果走
重點
- 晶片驗證團隊
- 晶片驗證團隊應讓 coverage 與資料檢查共同指向相同 RTL、測試、seed 和執行紀錄,避免把兩次各自成功的結果拼成一次合格成果;代價是補齊 runner 與報告對應,換取可追查的生成測試品質。
- Siemens 與 NVIDIA
- Siemens 與 NVIDIA 的 Liberty 案例示範以最終產物回饋工具介面調校,但公開分數來自小型開發子集;平台採用時仍需另測未見過的 cell 與完整成本,才能判斷回合減少是否轉成工程收益。
- CAD 平台負責人
- CAD 平台負責人把失敗、超時與人工修正一併除以合格交付數,才能比較腳本與 Agent;若只報成功案例的 token 或 PPA,流程可能因大量重跑而更昂貴,也會鼓勵挑選較容易的任務。
- EDA 方法工程師
- EDA 方法工程師將需求、checker 與工具版本的定義保存為長期資產,讓模型或供應商可替換;維護負擔會增加,若工作高度固定且既有腳本已穩定,持續使用確定性流程仍可能最划算。
驗證工程師收到一份新產生的 FIFO 測試:coverage 已到目標,另一份 scoreboard 報告也顯示零錯誤。接下來要交付的,卻是「這份測試在這版 RTL 上執行後,同時滿足目標覆蓋與資料正確性」。兩張漂亮報表與這個工程承諾之間,還隔著版本、stimulus 和執行身分的對應。
既有人工流程通常靠目錄命名、工程師記憶和固定 regression recipe 維持這種對應,腳本也能在輸入穩定時做得很好。Agent 加快了修改 test、RTL、SDC 與 Tcl 的頻率,還可能在一次對話內交替查看多次執行結果;原本由人腦補上的關係便需要明確保存。平台的下一步,是把可採計的產物集合固定下來,再比較哪種方法用較少工具與人工工作交付同樣品質。
上篇診斷 skill 研究評估的是下一步查核建議。本篇往下游走:Agent 提出了變更之後,如何建立一份可評分的交付,以及錯誤報告、過期結果和工具中斷如何影響分母。以下 runner、manifest 與測試都是參考設計,先用公開案例理解問題,再用可重跑的合成程式檢查必要條件。
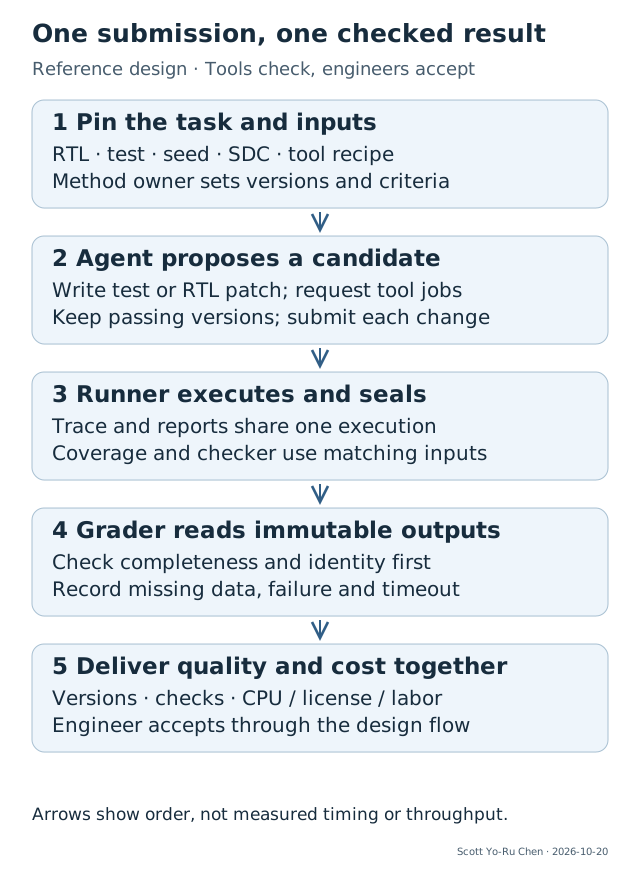
沿圖向下看,Agent 可以提出更多候選,正式比較卻只消費固定的提交。生成、執行、評分、工程接受各自有輸入和輸出,能讓同一套評量用於人工、腳本與不同模型。
三個公開案例把評分推向不同交付物
2026 年 10 月 14 日,Siemens 與 NVIDIA 公開 Solido characterization 的開發案例:SPICE 輸入經設定、模擬與 Liberty 產生後,grader 檢查完整性、格式、相對 reference 的新增失敗、數值 tolerance 及結果是否完整生成。四個二元條件乘上 tolerance 內數值比例,任一必要條件失敗即為零。公開調校每輪只使用兩個 cells、36 個 PVT corners,約 25 個 rollouts;平均綜合分數約 55% 升至 95%,turns 155 降至 53,output tokens 約 81K 降至 29K,屬供應商自報的開發結果。原始方法與設定
同月的 Build-A-Chip-Bench 將目標擴到 RTL 與 GDS,Agent、可查詢的隱藏 VIP、獨立 grader 分置三個 container。每個 task 的功能通過、乾淨 GDS 條件與 PPA 分數相乘,再對全體 tasks 平均。公開最佳綜合分數 16.6% 是這套評法的自報結果;不同欄位有不同分母。方法、公式與結果
另一端是 Venkata Krishna Kumar Vedantam/Portland State University 於 2026 年 10 月 15 日發表的 AMBU-CovAgent v1。論文坦白指出,固定 stimulus 的 scoreboard 與生成測試分開執行,reactive monitor 尚未普遍接到每份生成測試;三個小設計的 coverage 提升因此留下同份 stimulus 的資料檢查缺口。論文方法與限制
三者提供互補的工程理解:Liberty 案例將錯誤回溯到設定與工具選擇;RTL-to-GDS 將跨階段品質放在共同 task 上;AMBU-CovAgent 則示範即使已有兩種檢查,對應關係仍可能斷開。共同的設計要求,是先定義每一個分數究竟屬於哪份輸出,再討論 Agent 的進步。
報告要攜帶能重建工作的身分
考慮一個公開式 FIFO 任務,要求在 reset 後保持資料順序,並補到 full、empty 與 reset interaction 的指定功能 bins。方法工程師先固定 RTL 與 coverage plan,既有 testbench 產生起始結果;Agent 只能在指定目錄寫新的 directed test。這時的提交單位可以是下列 manifest:
submission: fifo-candidate-17
inputs:
  rtl_digest: ...
  test_digest: ...
  seed: 11
  simulator_build: ...
  checker_revision: fifo-monitor-v3
  coverage_plan_digest: ...
execution:
  id: exec-104
  state: completed
outputs:
  trace_digest: ...
  coverage_report_digest: ...
  checker_report_digest: ...
Digest 是內容識別,execution id 則回答「哪次工作產生了這些內容」。同一份程式重跑兩次可能使用相同輸入,仍要分別記錄執行;相同的 pass 字樣更不足以識別資料。報告由 runner 收集、固定內容後交付 grader,Agent 可讀取診斷,評分所用副本保持唯讀。
輸入清單應按階段展開。生成測試以 RTL、stimulus、seed、simulator 與 checker 為主;綜合還要固定 Tcl、SDC、library view 和 elaboration 設定;APR 加入 netlist、floorplan、實體 library 與 recipe;post-route STA 再綁 SPEF 與 corner。直接把所有東西塞進一個「專案版本」會讓失效原因難以定位。分層列出相依,才能在只改 test 時保留其他可重用資料,改 RTL 時則明確重做相關功能與實體工作。
檔名也應和內容識別分開。工程師可以保留熟悉的 reports/timing.rpt,manifest 記錄它的來源及內容;grader 讀取固定提交中的檔案,避免 Agent 下一輪將相同路徑覆寫後改變評分。這讓不同工具的格式可以各自保留,只要 adapter 將共同欄位轉成可檢查資料即可。
可信任的產生者是另一項必要工作。若 Agent 同時能修改 checker、completion record 和 seal,所有欄位都匹配仍可能只是自製答案。實際平台應把 runner 的服務身分、可寫目錄及 grader 輸入控制分開;digest 只協助發現內容改動。權限系統負責誰能產生正式紀錄,領域 checker 負責輸出符合哪些工程條件,兩者需要分別測試。
Coverage 累積前,先完成同一條軌跡的資料檢查
一次測試可能寫入 7、讀出 8,卻成功碰到 empty-to-nonempty 狀態。Coverage 計數可以完全正確,資料順序卻已經出錯。參考設計讓 monitor 和 coverage instrumentation 共同消費同一次 DUT execution:write handshake 將資料加入期望佇列,read handshake 將實際輸出與佇首比較,reset 依規格清空狀態。
這裡至少有兩個不同定義要固定。第一是什麼時候算一次有效 transfer,例如 valid 與 ready 同時成立;第二是 reset 前後的資料如何處理。若 monitor 把尚未接受的 write 也放進佇列,就會對正確 RTL 產生誤報。Checker 的獨立性需要獨立的規格推導和測試,單純改成另一個 Python 檔案仍留下共用錯誤的可能。
有效 coverage 集合可以寫成:
有效 bins = union(通過同軌跡檢查之 executions 的 bins)
這會使錯誤測試的命中暫時退出累積集合,讓下一輪仍看到待補目標。若修改 RTL,集合要改用新 revision,或由明確的相容規則重新建立;沿用舊版的滿分容易掩蓋新缺陷。Agent 可以接收「哪個 bin 尚缺」與拒絕原因,隱藏 expected values 則保留給獨立評量,以減少反覆查詢對最後測試的污染。
2012 年 6 月 4 日,Accellera 公布 UCIS 1.0,推進跨工具 coverage 資料的共同存取與交換。這個前例解決資料互通的方向,Agent 流程新增的是高頻變更下的執行對應與生成測試品質。既有 coverage 基礎設施可以沿用,前提是保留能追到原始工作與檢查結果的 metadata。
AMBU-CovAgent 固定程式的 compute_comparison 分列 hit-only 和 verified,should_stop 則讀 raw coverage 與 data_fail;這兩組欄位的差別,正好顯示「有命中」與「該命中有資料檢查」需要明確區分。固定版本程式可作靜態對照。本篇的修正方向是先接線、再計分,沒有修改該專案或重現其模型實驗。
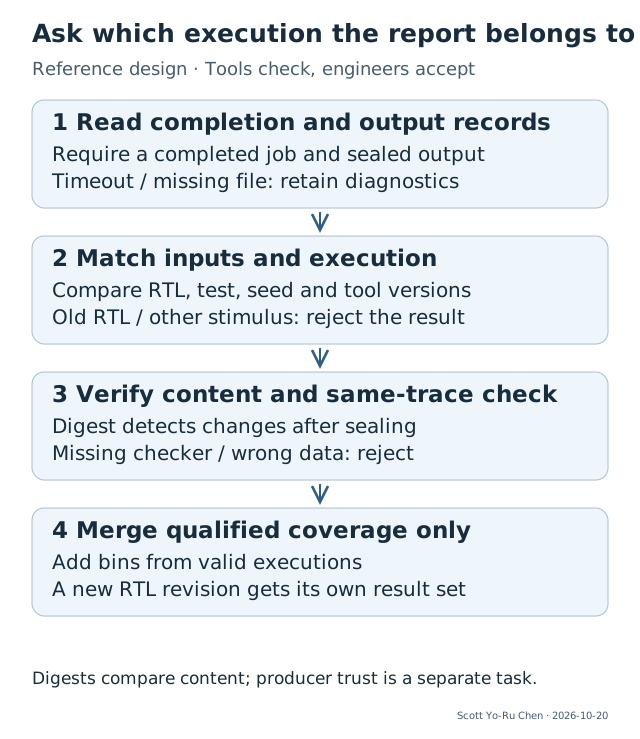
十個手工案例檢查誤收從哪裡進來
本篇的 Python 協定測試已實際執行,固定十個手工案例。程式用 deque 對照 write/read 資料,沒有執行 RTL simulation;coverage 值是手工 fixture。它的用途是檢查資料對應、拒絕原因與評分計帳,對照方法刻意保留常見的弱實作:只要 coverage 達 98%,另一份 scoreboard 零錯誤就接受,缺值還預設為零。
較嚴格的 grader 逐項比對輸入與 execution、completion、封存 digest、checker 是否存在及同一 trace 的資料結果,再看 coverage。兩個正常案例分別寫入並讀出 7 與 9,其餘案例注入資料錯誤、過期 RTL、不同 stimulus、缺 checker、封存後變更、超時半成品、coverage 不足與已回報錯誤。
| 合成情境 | 弱基準 | 版本綁定及同軌跡檢查 | 拒絕原因 |
|---|---|---|---|
| 兩個正常資料案例 | 2 個接受 | 2 個接受 | — |
| 生成 trace 讀出錯值 | 接受 | 拒絕 | 同軌跡資料比對失敗 |
| 舊 RTL/不同測試 | 2 個接受 | 2 個拒絕 | 輸入或 execution 身分不同 |
| 缺 checker | 接受 | 拒絕 | 檢查結果缺漏 |
| 封存後內容改動 | 接受 | 拒絕 | digest 及資料檢查失敗 |
| 超時但留下 coverage | 接受 | 拒絕 | 工作未完成 |
| coverage 不足/已回報錯誤 | 2 個拒絕 | 2 個拒絕 | 原有條件已能識別 |
弱基準接受八個,其中六個屬於預定義的無效案例;新 grader 接受兩個、誤收零個。兩者對相同十個 fixture 執行,結果與每筆拒絕原因保存在 原始輸出。這些案例依同一份設計規格編寫,結果證明程式按規則運作,統計泛化和真實團隊效益另需資料。
這個實驗也揭露最小模型省略的工作。它假設報告由可信任 producer 提供,seal 和 LOCK 都在同一程序中,沒有隔離 Agent 寫入能力;它沒有模擬 async FIFO 的時脈、backpressure 或 reset race。真正接到 cocotb/simulator 時,應先測 monitor 的 reset-heavy 行為、零比較次數、模擬 fatal、舊報告殘留,以及 replay 是否保留原始 trace。把這些列成下一步測試,比宣稱十例通過就能正式採用更有用。
合格率與 PPA 必須保留交集分母
跨 RTL 與實體流程的評量,還有另一種常見誤算。假設六個 tasks 中功能通過四個、物理條件通過四個,只有兩個同時通過;這兩個的 PPA 分數都是 80%。全體平均應是 2 / 6 × 0.8 = 26.67%。若把兩個邊際比例相乘,會得到 4 / 6 × 4 / 6 × 0.8 = 35.56%,多出 8.89 個百分點。
相乘邊際比例暗中加入兩項條件獨立的假設。設計工作通常有強烈關聯:為了時序加 pipeline 可能改變功能 latency,為了減面積共用運算單元可能降低吞吐;同一個架構決定會同時影響多項結果。最簡單的處理是保存逐 task 的功能、實體與 PPA,最後依同一列相乘再平均。上述六例也包含在實跑程式中。
將這個想法套回工具資料,功能報告的 RTL、equivalence 使用的 netlist、STA 的 SDC/SPEF,以及 GDS 的來源都要可對應。若 Agent 在功能測試後修改 pipeline,原先功能 pass 留在歷史,但新的提交需要自己的檢查。保留較佳舊提交則能讓探索失敗有退路,避免最後一輪變更把原本可交付的版本覆蓋。
總分仍要搭配失敗分類。語法錯誤、工具環境失敗、功能錯誤、物理失敗與預算耗盡,分別引導不同的改善工作。把它們全部壓成一個零分適合排名,診斷頁則要保留原因;否則平台團隊可能花時間修改模型描述,實際瓶頸卻是 license 排隊或 parser 拒收新版報告。
失敗的工具工作也要分攤到合格交付
假設十次嘗試共消耗 160 core-hours,最後兩次交付合格,平均成本是每份合格成果 80 core-hours。這與只看成功兩次各用 16 core-hours 相差五倍。失敗嘗試有研究價值,也確實使用資源,因此導入評估需保留兩種帳:整個探索活動總成本,以及最後接受的成果數。
CPU、license、token、人工與日曆時間要分欄。16 核心跑一小時是 16 core-hours,單一授權占用一小時是一個 license-hour;二者價格與可取得性各異。等待 license 的兩小時可能幾乎沒有 CPU 消耗,卻延後設計交付。工程師修正 checker、改寫工具描述及判讀誤報的時間,則落在人力帳上。
一個可比較的試驗可先固定二十個任務、每個相同的總工具預算,三條路線分別為人工配既有腳本、固定 recipe 的自動執行,以及可以提出 bounded 變更的 Agent。三條路線共用相同需求、checker 與最後評分資料;資深工程師原本能使用的腳本保留,避免刻意弱化現行流程。任務按設計家族與工具版本分組,將調校使用的集合與最後測試隔開。
模型回合或 token 下降時,先觀察合格交付數與總工具工作是否也改善。若 Agent 更快提出錯誤配置,simulation 反而可能增加;若它精準指出一次 constraint 問題,少量模型成本就可能省掉一整輪 APR。這兩種情況用同一個成功分母才能比較。
固定腳本與隔離重跑各有適用範圍
最便宜的起點通常是保留既有 runner,只把 report、版本和完成狀態補齊。這種 adapter 路線改動小、容易沿用成熟 regression,但 runner 的共用工作目錄與工具狀態仍要仔細處理。另一條路線是每次在隔離環境重跑提交,以獨立 checker 產生最後結果;隔離更清楚,資料搬移、工具啟動與授權整合也更昂貴。
| 路線 | 較適合的條件 | 主要成本與不足 |
|---|---|---|
| 人工+固定腳本 | 需求穩定、失敗類型少、工具流程成熟 | 人工處理新問題,變更彈性較低 |
| 原 runner 加版本化 grader | 已有可靠執行服務,需要先減少報告誤配 | 逐工具 adapter、共享狀態調查與維護 |
| 隔離提交+獨立重跑 | Agent 可改動範圍大、需跨模型公平比較 | 重跑、資料搬移、license 與環境複製 |
| 自適應 Agent+相同 grader | 已有固定任務與可信 checker,探索成本可控 | 額外模型、評估調校與人工診斷工作 |
這些是合理方案比較,尚無四條路線的實測排名。若既有腳本幾乎全數通過,且工程師介入很少,Agent 的額外組件可能只增加維護;平台應允許保留簡單流程。若任務變體多、工具等待昂貴、人工反覆閱讀 report,模型才較可能透過選擇下一步與修改候選產生淨收益。
長期來看,方法團隊會掌握 task、checker、版本關係與成本資料,供應商提供模型及工具能力。控制點由單次漂亮示範轉向可持續比較的工程規格;模型替換容易一些,checker 與 adapter 的維護責任則更集中。日常抄寫報告的工作可能減少,獨立規格、測試品質及失敗分析的工作會增加。
近期 RapidWright 研究說明已完成局部實作可以用模組庫保存並重用;本篇補上另一面:重用任何 DCP、測試或報告,都需要知道它在哪些條件下仍有效。交付物與評分一起保存,能讓省下的重跑有可核對的品質前提。
未來三個月,較有機會先改善的是既有 flow 上的 report 對應與有限操作評量,而非直接放大自主探索。可先在二十個公開小任務上比較相同品質下的總 tool-hours、人工介入與超時比例;若版本綁定持續攔到誤配,且維護時間低於省下的調查,就擴大到跨工具交接。若獨立重跑經常翻轉原結果,或 checker 誤報占用更多工程時間,應先修正量測流程,再增加 Agent 權限。
工具中斷後,半成品應留作診斷資料
一個具體失效情境是 simulator 已輸出 coverage,runner 在寫 scoreboard 前失去連線。殘留目錄可能同時存在本輪 coverage、上輪 scoreboard 與未更新的狀態檔。若合併程式僅看檔案存在,就會接受一份從未完整跑完的組合。
參考設計先將每次 execution 寫入獨立 staging 目錄。所有必要報告完成後,由 runner 記錄輸入與輸出 digest,再將完成提交提供給 grader。中斷的目錄保留失敗狀態與診斷資訊;新的嘗試使用新 execution id,避免沿用同一路徑把舊結果變成新結果。已完成的舊提交仍可供工程師選擇,探索的半成品則單獨保留。
偵測方式是檢查執行服務的最終狀態、必要報告集合與身分對應。對於遠端失聯,先確認工作是否仍在跑,再決定續接或取消;重新送出前要處理重複工作與授權占用。本文程式只測「未完成時拒絕採計」,正式的持久化、取消確認與 crash recovery 是後續執行服務工作。
這種安排改善的是報告品質和昂貴重跑的可見性。最終是否值得採用,仍回到同樣設計需求下,每份合格成果使用多少工具、多少人工以及多久日曆時間。Agent 生成更多內容之後,平台要讓團隊清楚知道哪些內容可以繼續使用、哪些需要重新檢查。
證據範圍
Siemens/NVIDIA 的數字是受控開發子集的供應商自報結果,95% 不是完整 229-cell library 的通過率,也不是量產 signoff 機率。公開材料未提供足以重現的完整 rollout、tolerance、held-out 切分與全成本。本篇沒有執行 Solido、SPICE 或其 NeMo Gym environment,也未觀看並驗證 demo 影片。
Build-A-Chip-Bench 是公開方法與初步自報評量,頁面仍有 coming-soon 項目;本文沒有重跑 task pack、獨立驗證模型排名或把開源工具/PDK 結果外推先進製程。AMBU-CovAgent 的限制依 v1 與固定程式檢視,沒有量測生成 stimulus 的實際無效比例。不同案例的分數不互相比大小。
合成測試只實跑單程序的報告對應、deque 資料檢查、拒絕條件與算式;coverage、身分與成本全為手工資料。沒有 RTL/LLM/EDA、sandbox 隔離、真實 producer authentication、資料庫交易、競態、持久化或多機 crash 測試。十個案例零誤收不構成一般錯誤率或安全保證;98% 是測試設定,並非建議所有設計採用的門檻。全文參考設計不宣稱任何公司的內部部署,不包含內部程式、PDK 或客戶資料。
參考資料
- Joshua Mabry/NVIDIA 等,Optimizing Agent Reliability and Tool Calling Efficiency for Chip Design Using NVIDIA NeMo Gym,2026-10-14。
- Surya Gunukula/ChipAgents 等,Build-A-Chip-Bench,2026 年 10 月,Task shape 與 Results。
- Venkata Krishna Kumar Vedantam/Portland State University,Independent Data-Integrity Verification for LLM-Driven Functional Coverage Closure in Hardware Design v1,2026-10-15;固定 agent.py。
- Accellera,UCIS 1.0 公布,2012-06-04。
- 合成協定測試與實跑輸出。